GLM-5.3: Yeni yaranan kiber imkanlarla qabaqcıl kodlaşdırma
GLM-5.3 üçün etdiyimiz yeganə iş sonrakı təlimi miqyaslandırmaq oldu. GLM-5.2 ilə təlim infrastrukturunu qurduq: səmərəli uzun kontekst emalı üçün IndexShare, uzun üfüqlü tapşırıqlarda RL üçün SAO və genişmiqyaslı asinxron təlim üçün slime — hamısı indiyədək topladığımız uzun üfüqlü tapşırıq mühitlərində işləyir. Ötən ay ərzində bu infrastrukturu miqyaslandırmağa davam etdik: daha çox mühit, daha müxtəlif tapşırıqlar və onların üzərində təlim üçün daha çox hesablama resursu.
Bu gün GLM-5.3-ü təqdim edirik. O, GLM-5.2 ilə eyni baza modelindən istifadə edir — bütün təkmilləşdirmələr sonrakı təlimdən qaynaqlanır. GLM-5.2 ilə müqayisədə mürəkkəb kodlaşdırma və uzun üfüqlü tapşırıqlarda xeyli yaxşı nəticə göstərir:
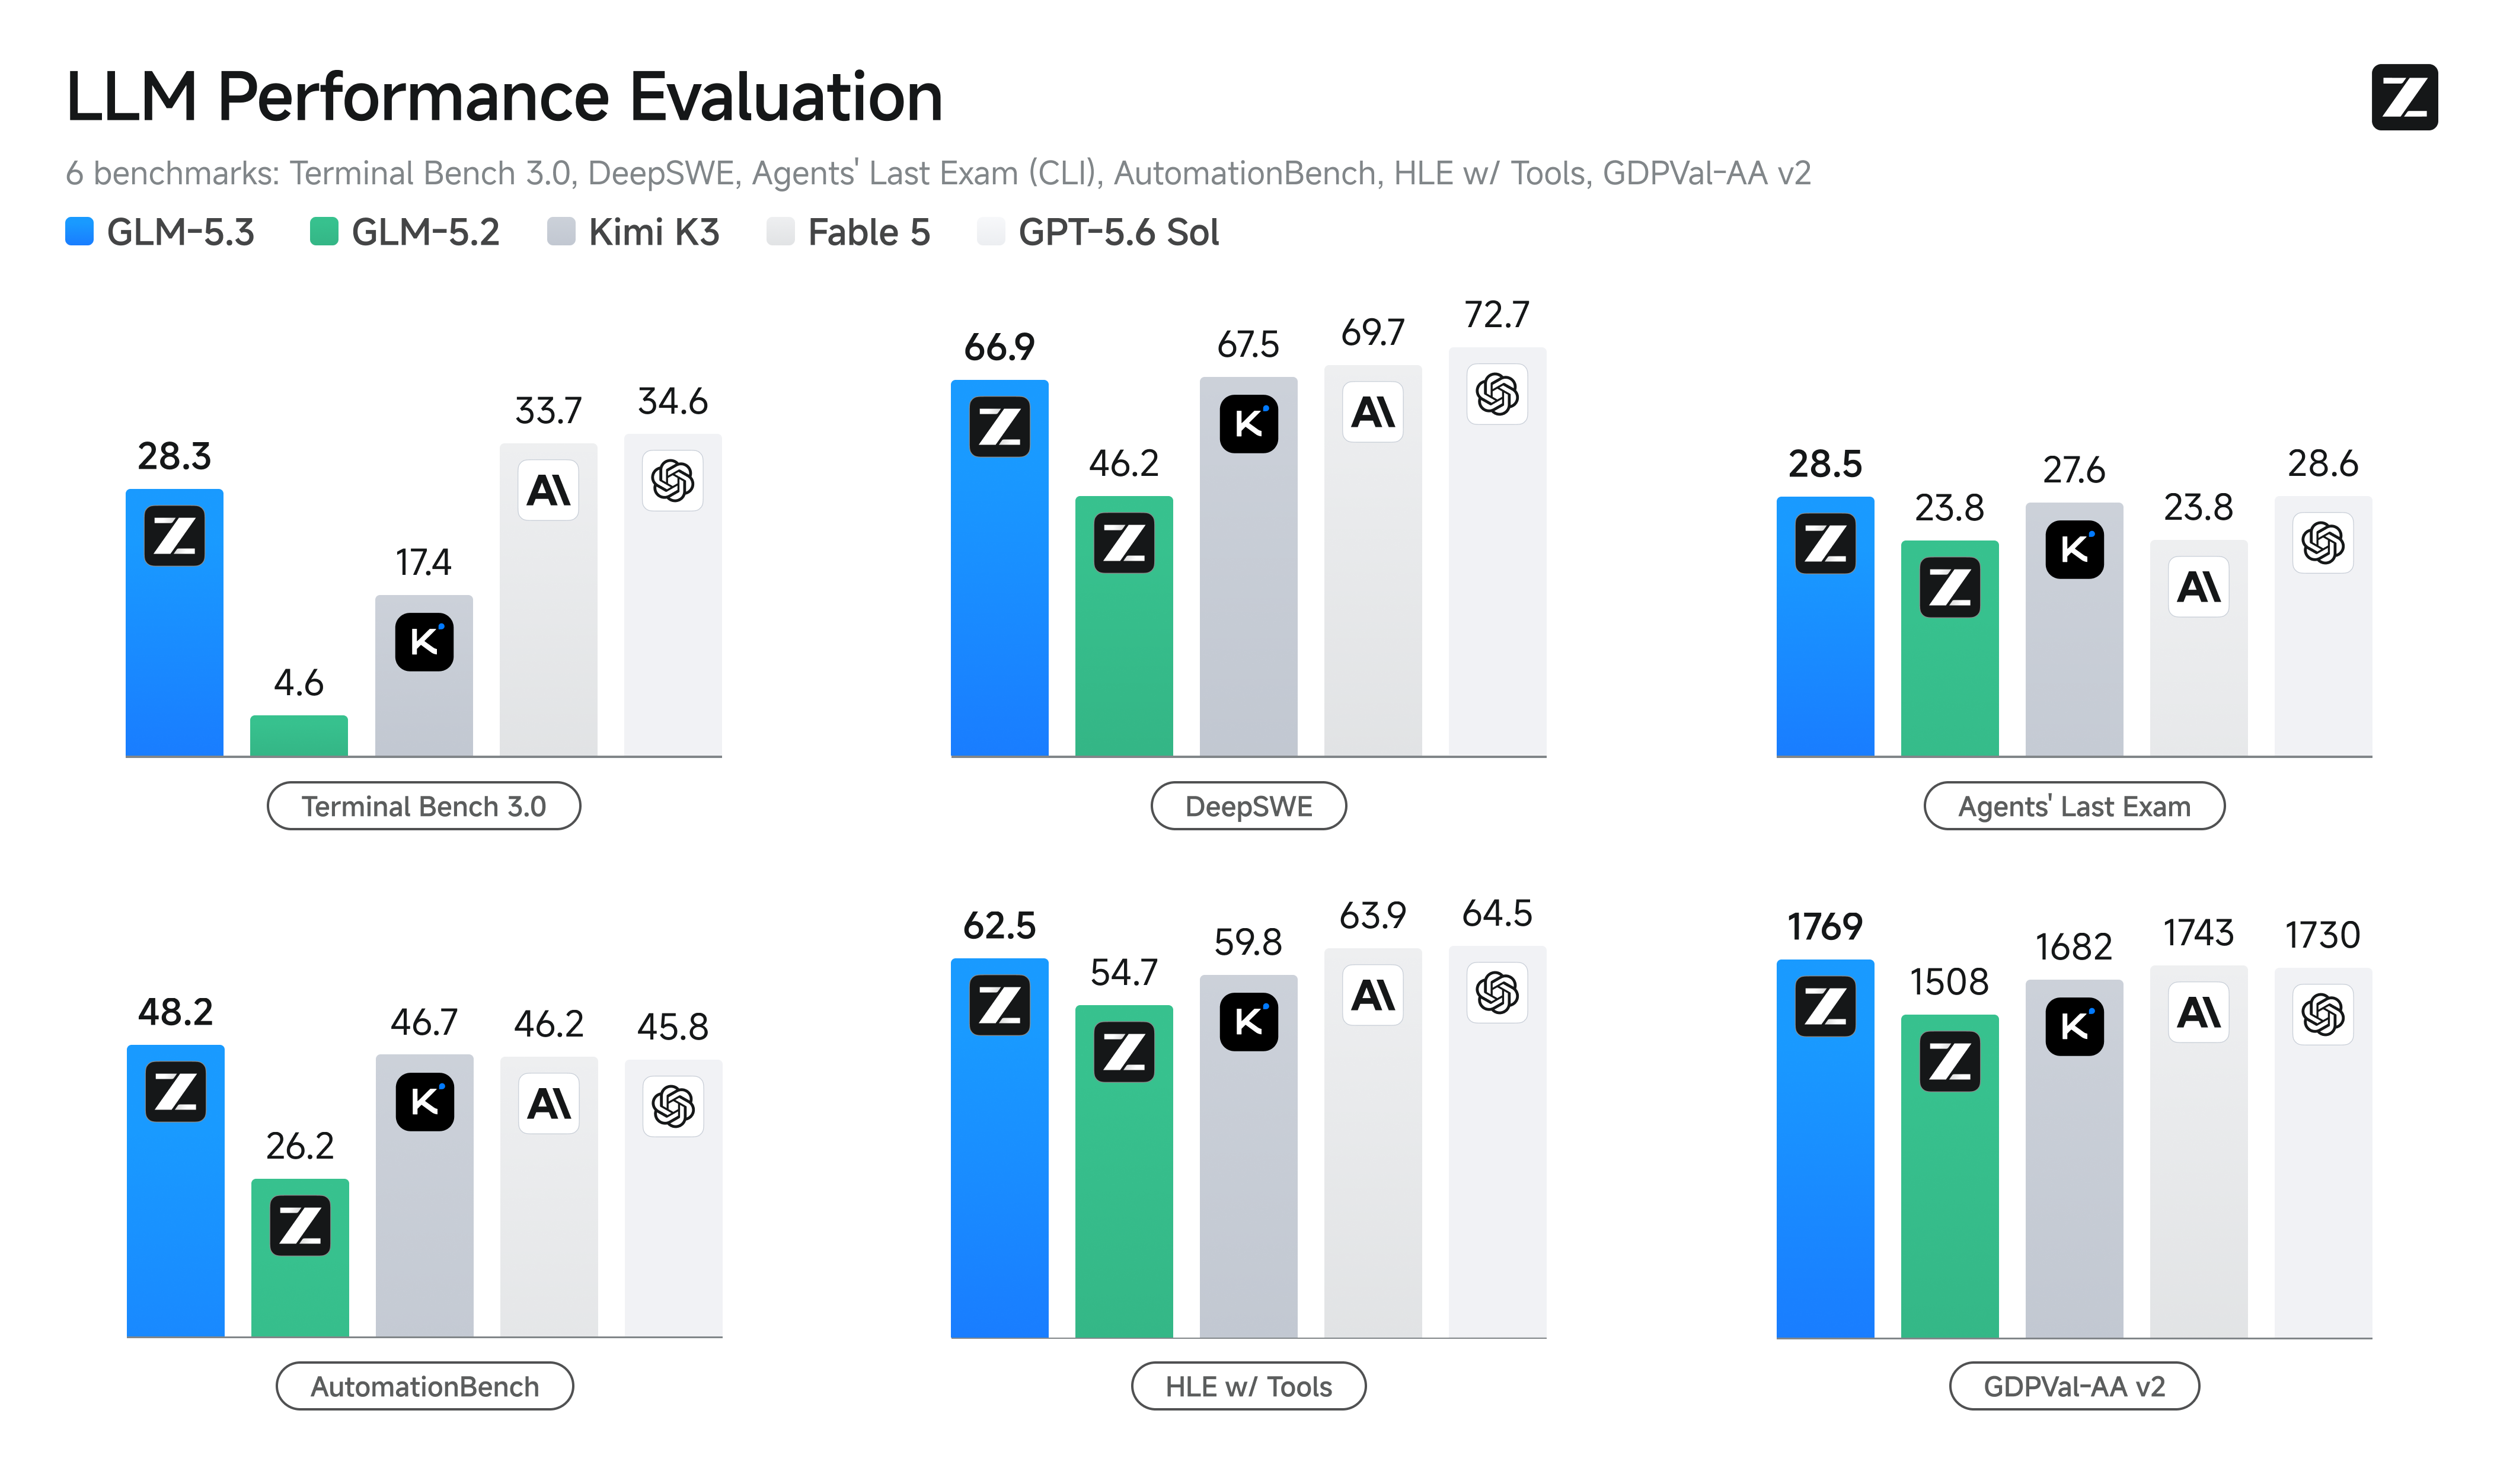
- Daha güclü kodlaşdırma: GLM-5.3 kodlaşdırma üçün ən qabiliyyətli açıq çəkili modeldir və şirkətdaxili Z.ai Code Bench testimizdə GLM-5.2-dən 50% daha yaxşı nəticə göstərir. O, həmçinin Terminal Bench 3.0 və Agents' Last Exam daxil olmaqla, ictimai meyarlar üzrə açıq mənbə SOTA nəticələrinə nail olur.
- Yeni yaranan kiber imkanlar: Sonrakı təlimi miqyaslandırdıqca, kiber imkanlar gözlədiyimizdən daha sürətlə inkişaf etdi. GLM-5.3 zəifliklərin aşkarlanmasında CyberGym üzrə ən yüksək nəticəyə sahibdir və istismar zəncirinin daha sonrakı mərhələlərində ən böyük irəliləyişləri göstərir; istismar meyarlarında GLM-5.2-ni iki dəfədən çox qabaqlayır.
- Açıq mənbə: Təhlükəsizlik qiymətləndirməsi və möhkəmləndirmə işləri tamamlandıqdan sonra, təqdimatdan iki həftə sonra çəkiləri yayımlayacağıq.
Yeni yaranan kiber imkanlar
Sonrakı təlimin bir hissəsi kimi, təlim qarışığına zəifliklərin aşkarlanması ilə bağlı məlumat və mühitlər əlavə etdik. Bunun modelin zəiflikləri tapmaq və onlar haqqında mühakimə yürütmək qabiliyyətini artıracağını gözləyirdik. Bizi təəccübləndirən isə bu qabiliyyətin gözlənilən hədəfi nə qədər aşması oldu.
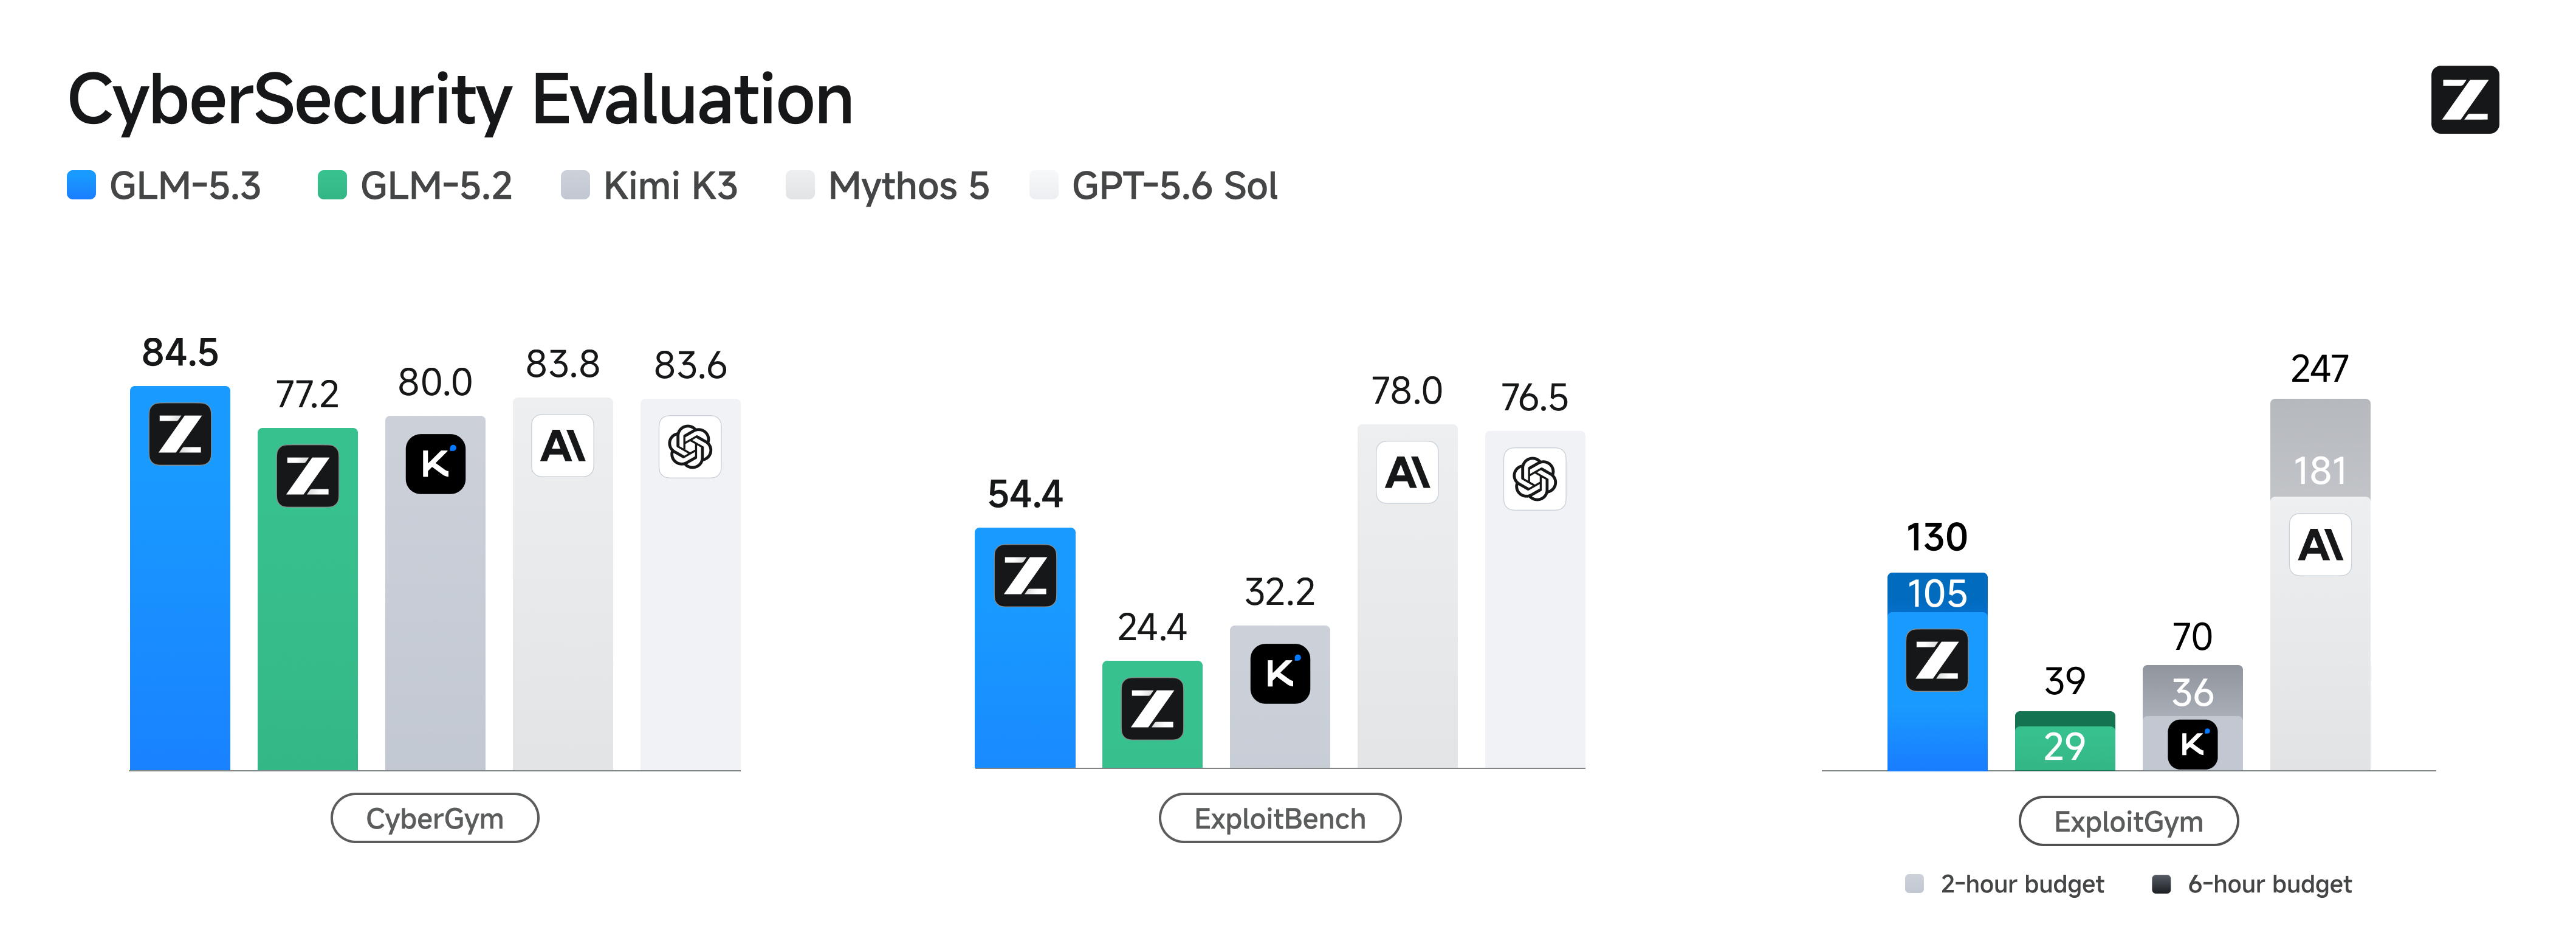
GLM-5.3-ü zəifliklərin təhlili və istismarının müxtəlif mərhələlərini əhatə edən üç meyar üzrə qiymətləndiririk. Modelin white-box mənbə kodundan başlayaraq xətalara səbəb olmaqla zəiflikləri müəyyən edib təsdiqləyə bilməsini yoxlayan CyberGym-də GLM-5.3 84.5% nəticə göstərir. Bu, GLM-5.2-nin 77.2% nəticəsindən yüksəkdir və Mythos 5-i (83.8%) və GPT-5.6 Sol-u (83.6%) qabaqlayaraq meyar üzrə ən yaxşı nəticədir. Real zəifliklər və onların istismarı barədə daha dərindən mühakimə yürütməyi tələb edən ExploitBench-də GLM-5.3 54.4%-ə çatır — bu, GLM-5.2-nin 24.4%-indən iki dəfədən çoxdur; Mythos 5 və GPT-5.6 Sol isə müvafiq olaraq 78.0% və 76.5% nəticə göstərir. Vaxta görə normallaşdırılmış büdcələr daxilində modelin tamamlaya bildiyi istismar tapşırıqlarının sayını ölçən ExploitGym-də GLM-5.3 iki saat ərzində 105, altı saat ərzində isə 130 tapşırığı yerinə yetirir; GLM-5.2 üçün bu rəqəmlər müvafiq olaraq 29 və 39-dur. Mythos 5 isə 181 və 247 tapşırıqla xeyli öndədir. Üç meyarın hamısında eyni mənzərə görünür: meyar istismar zəncirinin nə qədər sonrakı mərhələsini əhatə edirsə, GLM-5.2 ilə müqayisədə irəliləyiş bir o qədər böyük olur — lakin qapalı qabaqcıl modellərlə aradakı fərq də bir o qədər geniş qalır. İmkanlarımız ən sürətlə məhz ən çox geridə qaldığımız sahədə artır.
Daha sonra bu imkanların nəzarət olunan meyarlardan kənara çıxıb-çıxmadığını yoxladıq. GLM-5.2-dən bəri modellərimizi real kod bazalarında sınaqdan keçirmək üçün Çində bir neçə təhlükəsizlik komandası ilə əməkdaşlıq edirik. Ekspert yoxlaması, süzgəcdən keçirmə və təkrarlanan nəticələrin çıxarılmasından sonra model 269 layihədə 2,436 zəiflik müəyyən etdi; bunların 1,097-si orta və yüksək ciddilik səviyyəsində idi. Tapıntılar sistem nüvələrini, əməliyyat sistemlərini, brauzer mühərriklərini, açıq mənbəli infrastrukturu, veb tətbiqləri və şəbəkə protokollarını əhatə edir. Bir çoxu illərlə, hətta onilliklərlə aşkarlanmamış qalmışdı; ən qədiminin təxminən 40 il əvvələ aid olduğu müəyyən edildi.
Bu iş sonradan davamlı açıqlama təşəbbüsünə çevrildi. Tapıntıların açıqlama prosesi boyunca ictimai qeydiyyatını aparmaq üçün Z.ai Təhlükəsizlik Açıqlamaları Reyestrini yaratdıq. Yeni zəifliklər yoxlanılıb açıqlanmağa hazır olduqca reyestr mütəmadi yenilənir və artıq ictimaiyyətə açıqlanan məsələləri hələ açıqlama prosesində olanlardan fərqləndirir. Açıqlanmış məsələlər üçün reyestr təsirə məruz qalan layihə, ciddilik səviyyəsi, mövcud olduğu hallarda CVE və zəifliyin kod bazasında nə qədər müddət qaldığı barədə məlumatları qeyd edir.
slime: Uzun üfüqlü RL-in miqyaslandırılması üçün qurulub
Bütün bunlar RL-in miqyaslandırılması üçün açıq mənbəli sonrakı təlim çərçivəmiz olan slime üzərində işləyir; təlim tərəfində Megatron, rollout tərəfində isə SGLang istifadə olunur. Dizaynı təlimi, rollout-u və məlumat buferini vahid dataflow-da birləşdirir. Beləliklə, riyaziyyat, kod, sandbox-lar, yoxlayıcılar və uzun üfüqlü agent mühitləri təlim dövrünə dəyişiklik kimi deyil, məlumat generasiyası kimi qoşulur. Məhz bu, təlim infrastrukturunu hər dəfə yenidən qurmadan GLM-5.2 və GLM-5.3 boyunca mühitlər əlavə etməyə davam etməyimizə imkan verdi.
GLM-5.3 dövründə bu çərçivəni iki istiqamətdə inkişaf etdirdik. Alqoritmik tərəfdə RL tədqiqatına yönəlmiş imkanlar əlavə etdik: top-p mask, top-k və tam lüğət üzrə OPD, eləcə də təlim və rollout ardıcıllığını yaxşılaşdıran konfiqurasiyalar. Bunlara R3 tipli quruluşlar və təlimlə rollout yolları arasında tam ədədi uyğunlaşdırma daxildir. Bu imkanlar nümunə götürmə, təlim və müəllim siqnallarına daha dəqiq nəzarət etməyimizə, həmçinin nəzarət olunan müqayisələri sürətlə aparmağımıza şərait yaradır. Təlim və rollout ardıcıllığının qiymətləndirilməsində log ehtimalların (logprob) orta fərqi 1e-7 səviyyəsində saxlanıldı. Bu, əvvəlki quruluşlarla müqayisədə 99.99%-dən çox azalma deməkdir.
Genişmiqyaslı RL üçün resurs səmərəliliyi və sistem ötürücülüyü üzərində də çalışdıq. Yerli yaddaş indi əlavə keş qatı kimi xidmət edir və başqa halda host yaddaşında saxlanacaq model vəziyyətləri ilə məlumatları iyerarxik qaydada saxlayır. Bu, xüsusilə çoxmüəllimli OPD üçün vacibdir: təlim tərəfində müəllimləri dinamik dəyişib əvvəlcədən yükləməklə, hər biri üçün xüsusi, davamlı işləyən inferensiya xidməti yaratmadan, bir neçə müəllimdən istifadə etmək mümkündür. Əlavə yük məhdud, resurs sərfiyyatı isə xeyli aşağı olur. Agent və asinxron iş yükləri üçün router ilə slime arasında birgə planlaşdırmanı və yük balanslaşdırmasını təkmilləşdirdik ki, uzunluqları və tamamlanma vaxtları çox fərqlənən rollout sorğuları inferensiya resurslarından daha səmərəli istifadə etsin. Hər rollout mühitinin xüsusiyyətlərindən çıxış edərək ötürücülüyə yönəlmiş konfiqurasiyalar — prefill/decode resurs nisbəti, paralellik parametrləri və ötürücülük üçün vacib olan digər parametrlər — müəyyən edən iş yükünə uyğun evristikalar əlavə etdik. Nəticədə, uzun üfüqlü kodlaşdırma RL tapşırıqları üçün bu sistem səviyyəli optimallaşdırmalar RL təliminin başdan-başa ötürücülüyünü 2.3×-dən çox artırdı. Bu da daha uzun trayektoriyalar və mürəkkəb mühitlər üzrə təlimi xeyli yüksək səmərəliliklə miqyaslandırmağa imkan verdi.
Bunların hamısı birlikdə bizə daha çox eksperimental çeviklik, daha az resurs xərci və daha yüksək ötürücülük verir — RL-i miqyaslandırmağa davam etməyi praktik edən də məhz budur.
GLM-5.3 ilə işə başlayın
GLM-5.3-də API dəyişiklikləri
GLM-5.3 üç düşünmə səviyyəsini dəstəkləyir: low, high və max. GLM-5.3-də düşünmə rejimini söndürmək artıq dəstəklənmir.
| Parametr | Dəyərlər | Susmaya görə | Təsvir |
|---|---|---|---|
| thinking.type | enabled | enabled | Düşünmə rejimini aktivləşdirir. disabled artıq dəstəklənmir. |
| reasoning_effort | low, high, max | max | low: yüngül; high: gücləndirilmiş; max: dərin. Kodlaşdırma tapşırıqları üçün max tövsiyə olunur. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
Keçid tələb olunur: Tətbiqiniz hazırda thinking.type: "disabled" istifadə edirsə, model ID-sini glm-5.3 olaraq dəyişməzdən əvvəl onu enabled edin və reasoning_effort parametrini low olaraq təyin edin. Əks halda sorğu uğursuz olacaq.
GLM Coding Plan və ZCode ilə GLM-5.3-dən istifadə edin
Sevimli kodlaşdırma agentlərinizdə — ZCode, Claude Code, OpenCode və digərlərində — GLM-5.3-ü sınayın. devpack icmalına baxın.
GLM Coding Plan abunəçiləri üçün: GLM-5.3-ü bütün GLM Coding Plan istifadəçiləri üçün əlçatan etdik. Yeni GLM Coding Plan artıq xallara əsaslanan kvota sistemindən istifadə edir. Xal sərfiyyatı giriş, keşlənmiş giriş və çıxış tokenləri üçün ayrıca hesablanır. Pik saatlardan kənar edilən model çağırışları standart xalların 50%-ni sərf edir. Pik saatlar bazar ertəsindən cümə gününə qədər 14:00–18:00 (UTC+8) aralığıdır; həftəsonları da daxil olmaqla, digər bütün saatlarda qeyri-pik saatlar üçün nəzərdə tutulan 50% endirim tətbiq olunur. Elə indi qurmağa başlayın: z.ai/subscribe
ZCode ilə GLM-5.3-dən daha çox yararlanın
- 98%+-lik keş uyğunluğu — təkrarlanan kontekst daha aşağı keş tarifinə əsasən hesablanır, effektiv token sayı təxminən 30% artır
- Məhdud müddət üçün 1.5x kvota artımı — bunu keş qənaəti ilə birləşdirərək 31 avqusta qədər standart kvotanızın 180%-dək həcmindən istifadə edin
- Uzun üfüqlü tapşırıqlarda ustalıq — Goal rejimi hədəfə çatana qədər planlaşdırır, kod yazır, test edir və nəticəni yoxlayır
- Remote Control — WeChat və ya Feishu vasitəsilə telefonunuzdan uzunmüddətli tapşırıqları izləyin və idarə edin
ZCode-u sınayın: zcode.z.ai
GLM-5.3-ü yerli mühitdə işlədin
GLM-5.3-ün model çəkiləri təqdimatdan sonra iki həftə ərzində ictimaiyyətə açıq olacaq.