DeepSeek V4.1 Flash: ¿evolución o revolución?
DeepSeek lanzó V4.1-Flash el 10 de septiembre de 2026. Es un modelo multimodal Mixture-of-Experts de 552B parámetros con una ventana de contexto de 1M tokens. Según los propios benchmarks de DeepSeek, iguala o supera a Opus-5.0 en varias tareas agénticas. También es barato: la entrada cuesta $0.15 por millón de tokens en horas de menor demanda y la salida, $0.60. Es aproximadamente 4 veces más barato que DeepSeek V4-Pro para la entrada y 3 veces más barato para la salida.
El modelo ya está disponible en vega.chat y a través de la API api.vega.chat.
Arquitectura
DeepSeek-V4.1-Flash usa una arquitectura Causal Encoder-Decoder (CED): un Transformer de 40 capas dividido en un codificador causal de 20 capas y un decodificador de 20 capas. La caché KV del decodificador se proyecta a partir de los estados ocultos finales del codificador, en lugar de los estados ocultos de cada capa del propio decodificador. Esto permite que el modelo active solo 8B parámetros por token durante el prellenado y 16B durante la decodificación.
La capa MoE tiene 1 experto compartido y 384 expertos enrutados, de los cuales activa 6 por token. El modelo procesa de forma nativa imágenes y texto mediante un codificador visual (DeepSeek-ViT, entrenado desde cero con 2D-RoPE) y un proyector MLP de dos capas.
DeepSeek entrenó el modelo desde cero con un corpus multimodal de 45T tokens, con atención dispersa a una longitud de secuencia de 64K y el contexto ampliado a 1M tokens con 34T tokens. El proceso de posentrenamiento sigue las etapas SFT, RL y destilación on-policy, sin cambios algorítmicos. El trabajo sustancial se centró en la canalización de datos: síntesis automatizada a gran escala de tareas y entornos agénticos, con escalado progresivo de los datos, las tareas y las ejecuciones.
Rendimiento: nivel Opus a precios de Flash
Los propios benchmarks de DeepSeek sitúan a V4.1-Flash al nivel de Opus-5.0 y por delante en varias tareas agénticas. En Terminal-Bench 2.1, V4.1-Flash obtiene una puntuación de 90.6, superando los 89.1 de Opus-5.0. En DeepSWE v1.1, obtiene 74.2, por encima de los 74.0 de Opus. En Agent's Last Exam, obtiene 31.8, la mejor puntuación entre todos los modelos comparados, incluidos Opus, GPT-5.6 Sol, K3, GLM-5.3 y V4-Pro. En Codeforces, alcanza una clasificación de 3471, también la más alta de la comparación. En AutomationBench obtiene 54.8, de nuevo la mejor puntuación.
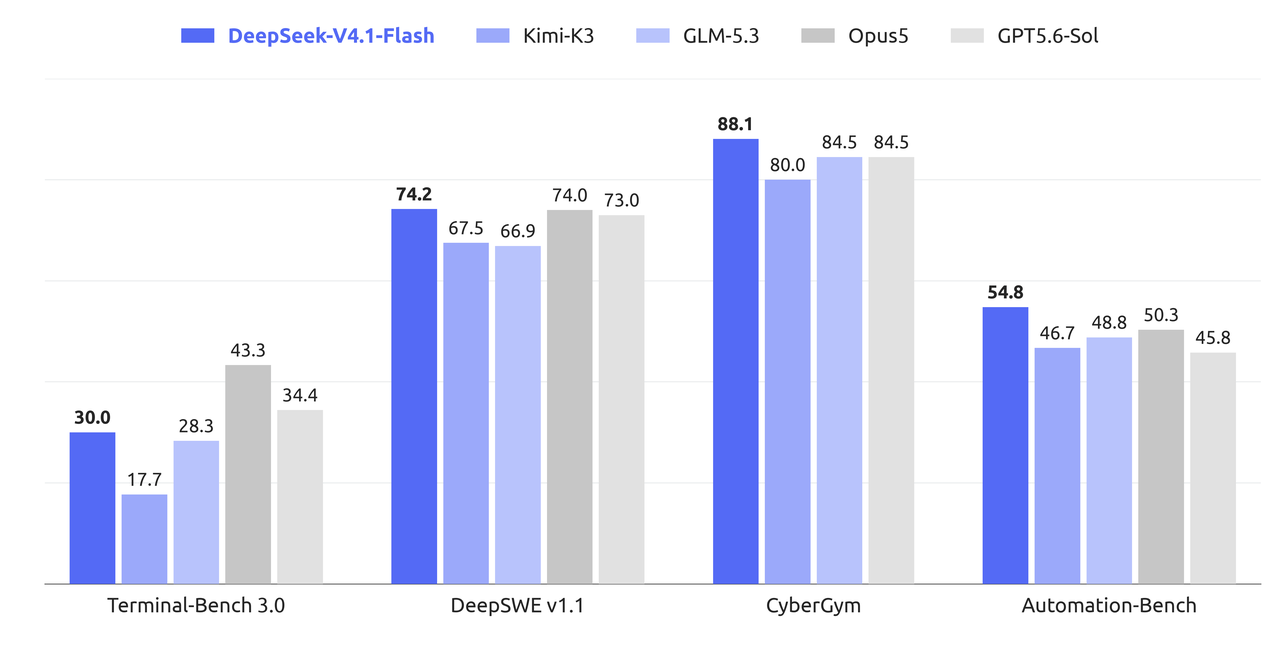
La tabla completa de benchmarks abarca tareas de razonamiento, agénticas y visuales en siete modelos. V4.1-Flash ocupa el primer puesto en Terminal-Bench 2.1, DeepSWE v1.1, Codeforces, CyberGym, HLE con herramientas, AutomationBench y Agent's Last Exam.
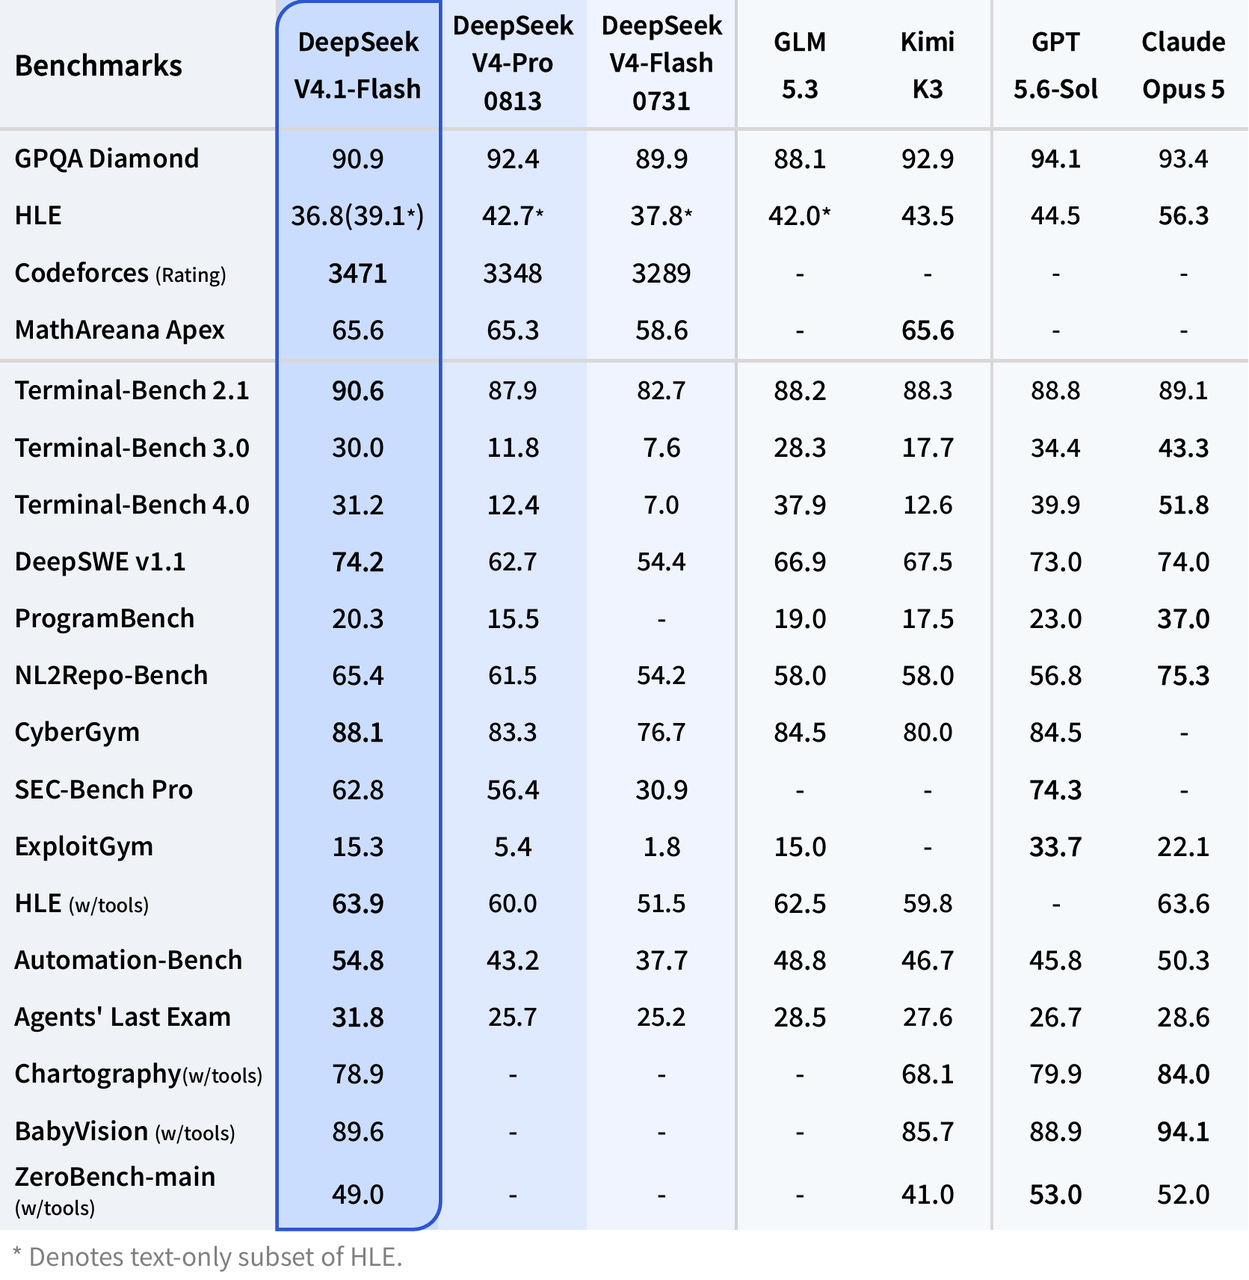
DeepSeek señala que las pruebas de varias entidades sitúan a V4.1-Flash por delante de V4-Pro en rendimiento, coste, velocidad y tiempo de ejecución total. La empresa está retirando V4-Pro de forma gradual. A partir del 14 de septiembre de 2026, todas las solicitudes a la API deepseek-v4-pro se redirigirán a V4.1-Flash con las tarifas de V4.1-Flash, hasta el lanzamiento de V4.1-Pro.
Caché KV: 4 veces más pequeña
El modelo usa Compressed Sparse Attention 2 (CSA2), que asigna a cada capa de atención uno de tres modos estáticos: Full, Reindex o Reuse. Esto permite compartir la KV principal y el K del indexador entre capas, además de reutilizar los índices de atención dispersa Top-K. Combinado con el almacenamiento en caché KV principal en FP4 (formato E2M1, una escala E4M3 por cada 16 canales), el tamaño global de la caché KV se reduce a 890 bytes por token. Esto equivale aproximadamente a 1/4 del tamaño de DeepSeek V4-Flash y a 1/437 del de DeepSeek V1.
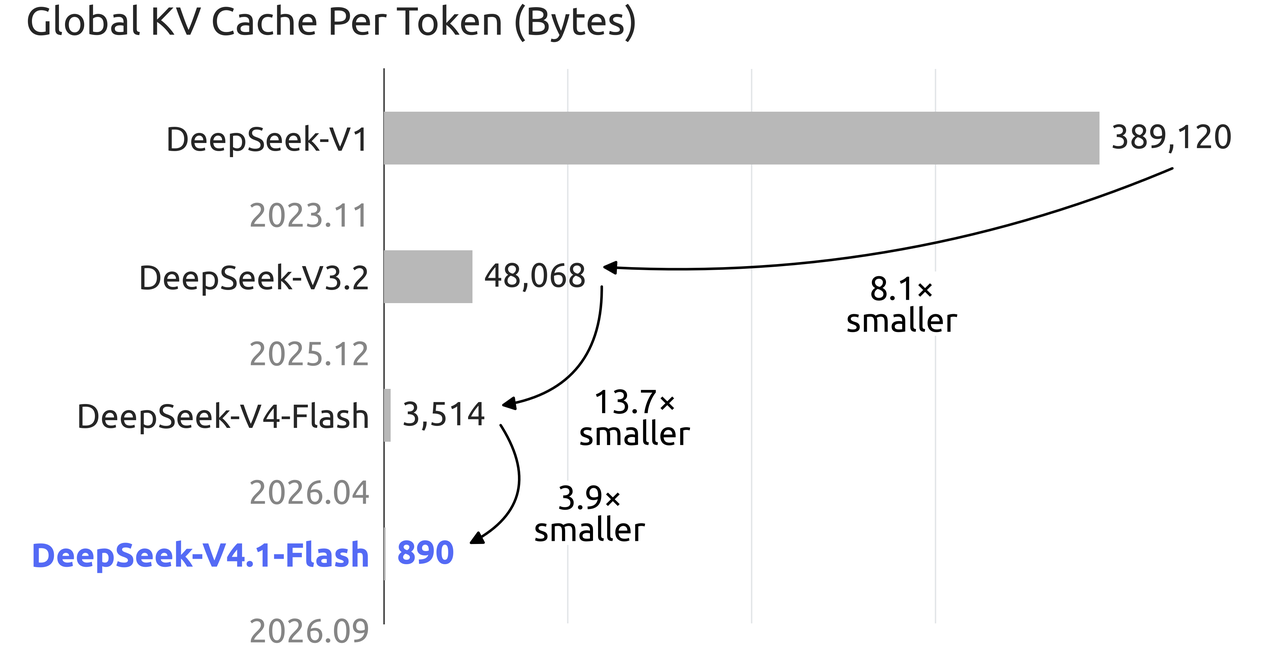
Los cargos por aciertos de caché suelen representar una gran parte de los costes de los agentes. Comprimir la caché reduce esos costes directamente. Frente a la generación anterior, V4.1-Flash necesita 1/4 de la HBM y 1/8 del almacenamiento SSD para su caché KV.
Precios
V4.1-Flash tiene precios para horas punta y horas de menor demanda. Las tarifas en horas de menor demanda equivalen al 50 % de las tarifas en horas punta. Los nuevos precios entraron en vigor a las 04:00 UTC del 10 de septiembre de 2026.
| Tipo de token | Horas de menor demanda (por 1M) | Horas punta (por 1M) |
|---|---|---|
| Entrada (acierto de caché) | $0.003 | $0.006 |
| Entrada (fallo de caché) | $0.15 | $0.30 |
| Salida | $0.60 | $1.20 |
A modo de comparación, V4-Pro cobra $0.66 por 1M de tokens de entrada (horas de menor demanda, fallo de caché) y $1.98 por 1M de tokens de salida (horas de menor demanda). V4.1-Flash es aproximadamente 4 veces más barato para la entrada y 3 veces más barato para la salida, a la vez que iguala o supera a V4-Pro en los benchmarks.

Tareas cotidianas, agentes y programación por intuición
V4.1-Flash está diseñado para cargas de trabajo agénticas con gran volumen de entrada. Los 8B parámetros activos durante el prellenado hacen que procesar contextos largos sea barato, que es donde se acumulan los costes de los agentes. La ventana de contexto de 1M tokens y la compatibilidad multimodal nativa (texto e imágenes) le permiten leer documentos extensos, bases de código e información visual de una sola pasada.
El modelo permite ajustar continuamente el nivel de razonamiento (un entero del 1 al 100), con un equilibrio entre el coste de inferencia y la precisión. Los niveles de esfuerzo más bajos reducen el consumo de tokens en consultas más sencillas. Los niveles más altos añaden pasos de razonamiento para problemas complejos. Esto lo hace práctico para el chat cotidiano y las preguntas rápidas, no solo para ciclos agénticos intensivos.
En los benchmarks agénticos, el modelo obtiene sus mejores resultados: Terminal-Bench 2.1 (90.6), DeepSWE v1.1 (74.2), Agent's Last Exam (31.8) y AutomationBench (54.8). Admite llamadas a herramientas, salida JSON y la Responses API. WorkBuddy (incluido CodeBuddy) y OpenCode, socios oficiales de DeepSeek, ya son totalmente compatibles con V4.1-Flash.
Para la programación por intuición, la clasificación de 3471 en Codeforces y la puntuación de 74.2 en DeepSWE v1.1 sitúan a V4.1-Flash en lo más alto de la comparación, por delante de Opus-5.0 y GPT-5.6 Sol. Combinado con el bajo precio y el contexto de 1M, esto lo convierte en un sólido modelo predeterminado para agentes de programación que ejecutan sesiones largas y acumulan grandes ventanas de contexto.
Prueba DeepSeek V4.1-Flash en vega.chat
DeepSeek V4.1-Flash ya está disponible en vega.chat y a través de la API api.vega.chat. Puedes probarlo en la interfaz de chat, comparar sus respuestas con las de otros modelos o integrarlo en tus aplicaciones mediante la API compatible con OpenRouter en api.vega.chat.