GLM-5.3: Programación de frontera con capacidades cibernéticas emergentes
Con GLM-5.3, lo único que hicimos fue escalar el post-entrenamiento. En GLM-5.2 ya habíamos construido la infraestructura: IndexShare para procesamiento eficiente de contexto largo, SAO para reinforcement learning en tareas de horizonte prolongado, y slime para entrenamiento asíncrono a gran escala — todo corriendo sobre los entornos de tareas de horizonte prolongado que llevamos acumulando. Durante el último mes seguimos escalando sobre esta base: más entornos, tareas más variadas y más cómputo dedicado al entrenamiento.
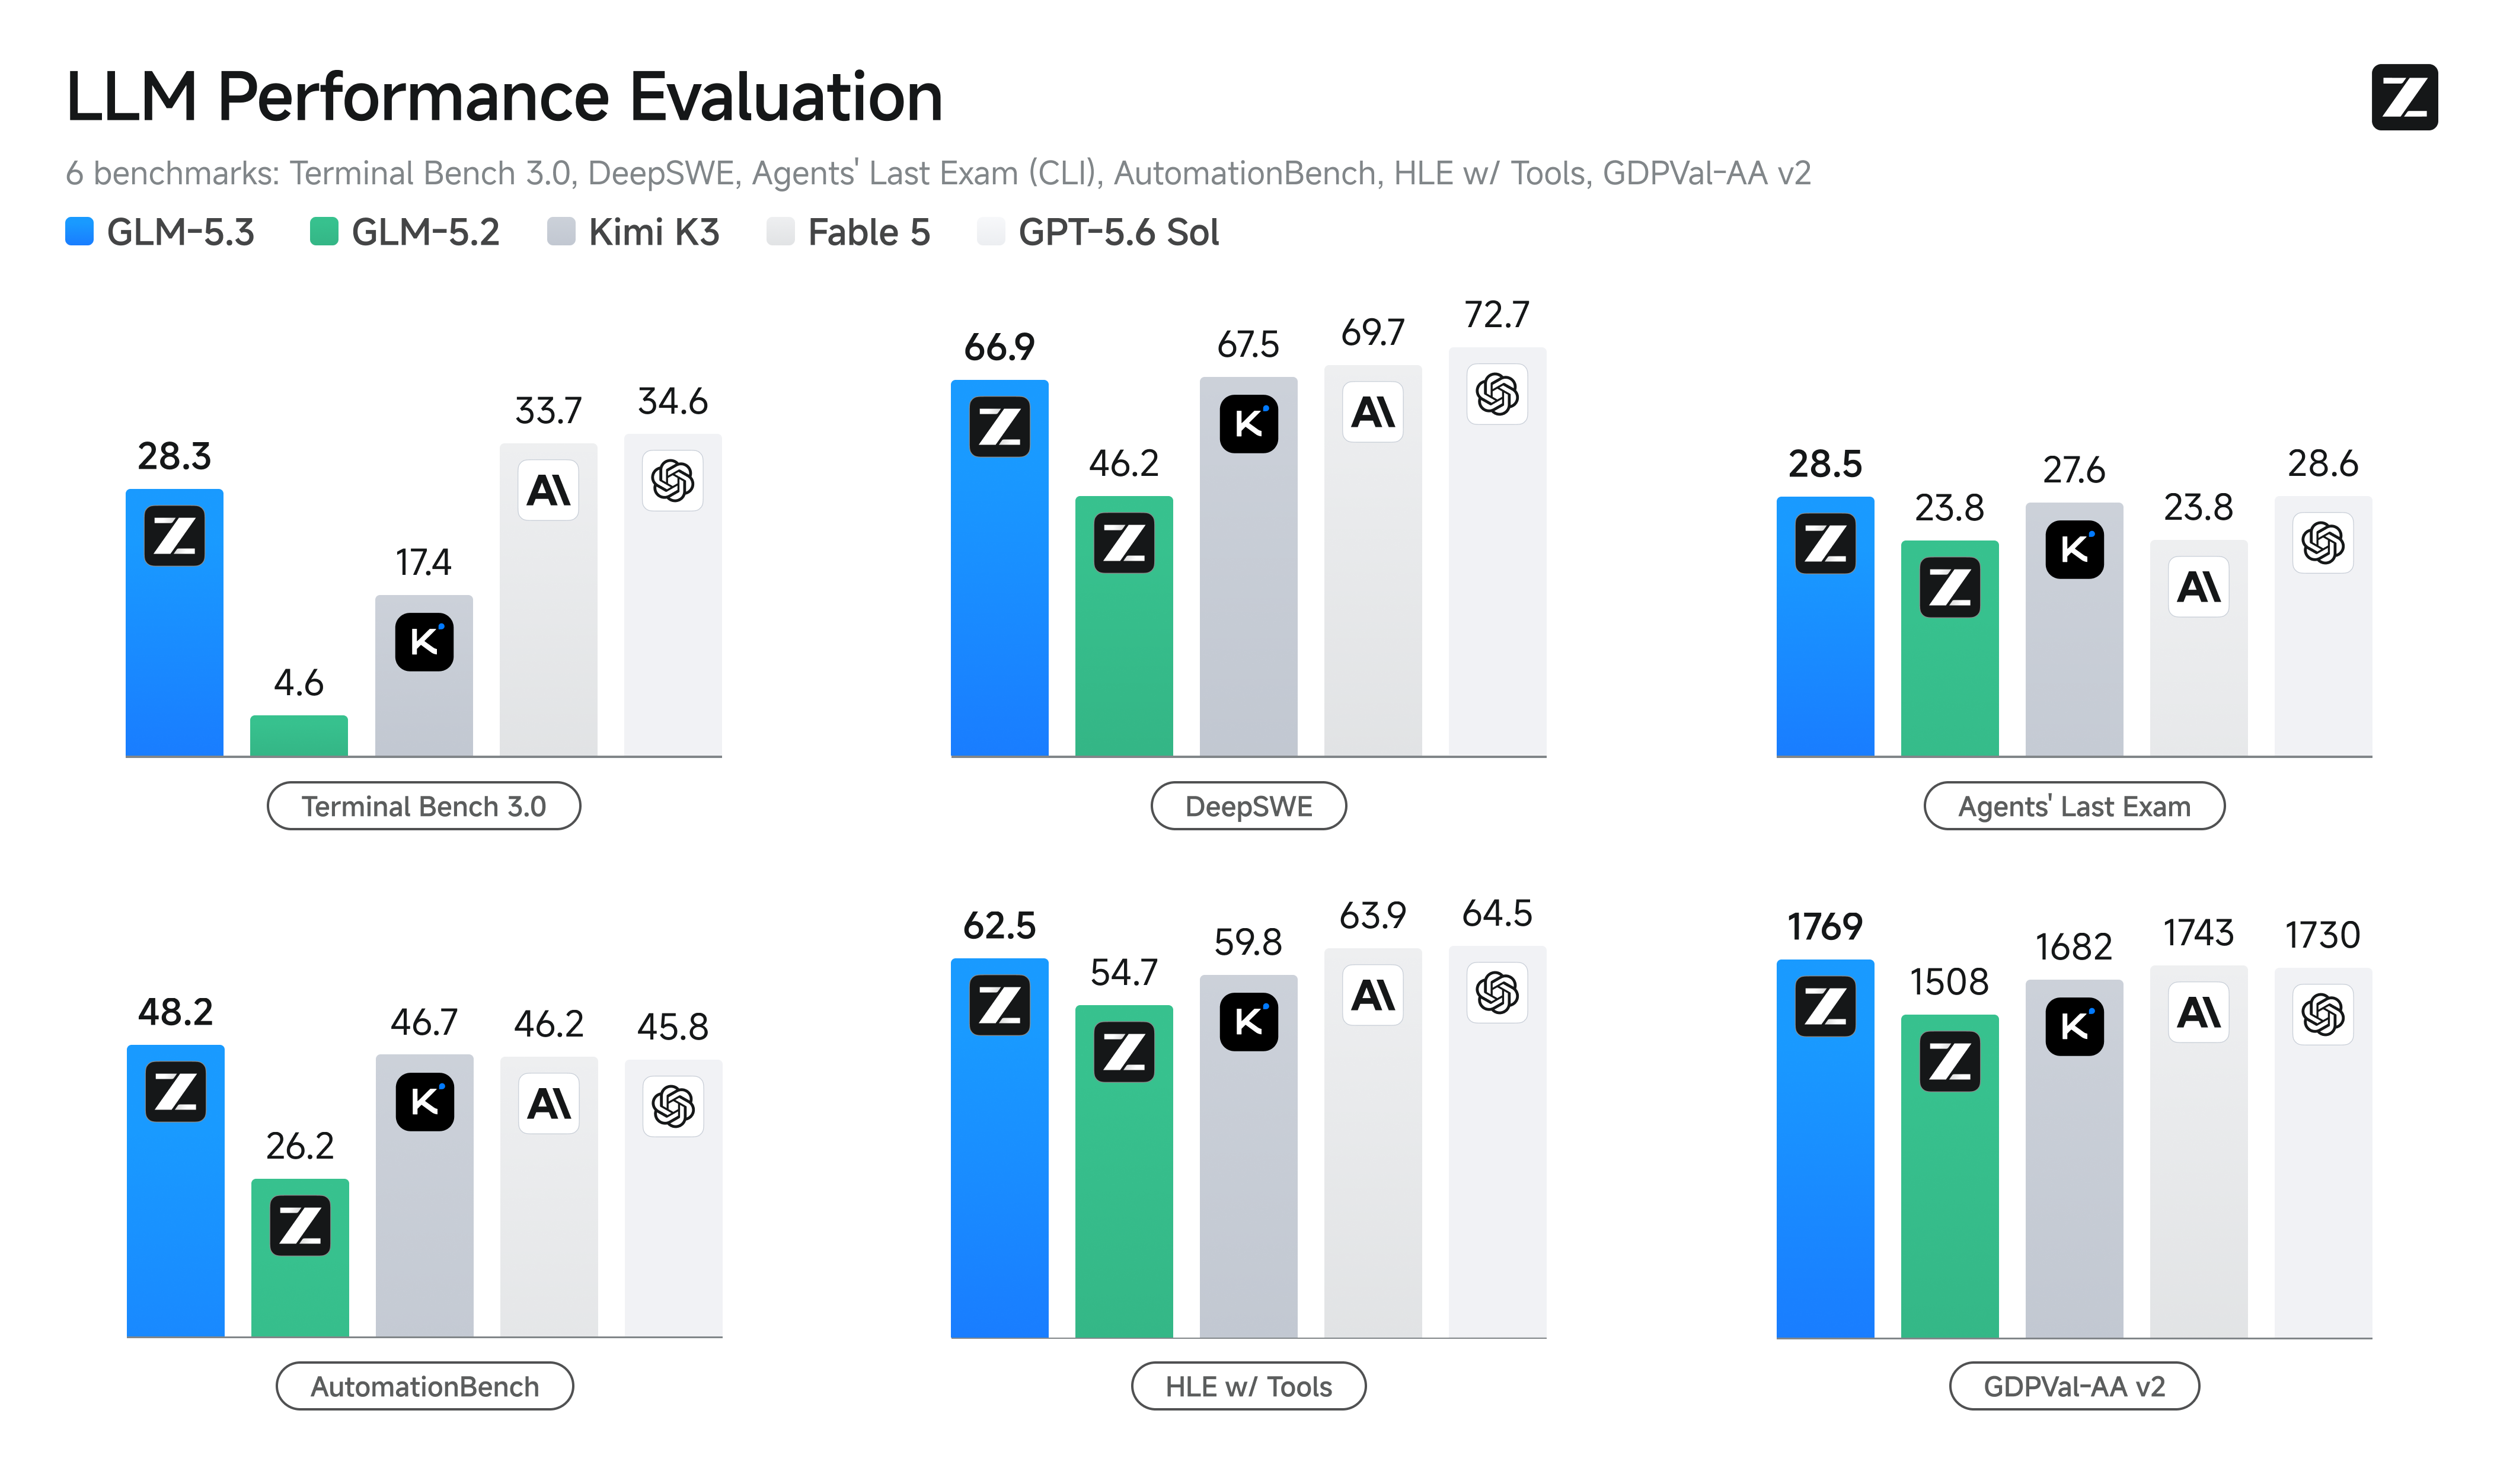
Hoy lanzamos GLM-5.3. Emplea exactamente el mismo modelo base que GLM-5.2 — cada mejora proviene del post-entrenamiento. En comparación con GLM-5.2, es notablemente superior en programación compleja y tareas de horizonte prolongado:
- Programación más sólida: GLM-5.3 es el modelo de pesos abiertos más competente para programación, con una mejora del 50% sobre GLM-5.2 en nuestro Z.ai Code Bench interno. Además alcanza el SOTA de código abierto en benchmarks públicos como Terminal Bench 3.0 y Agents' Last Exam.
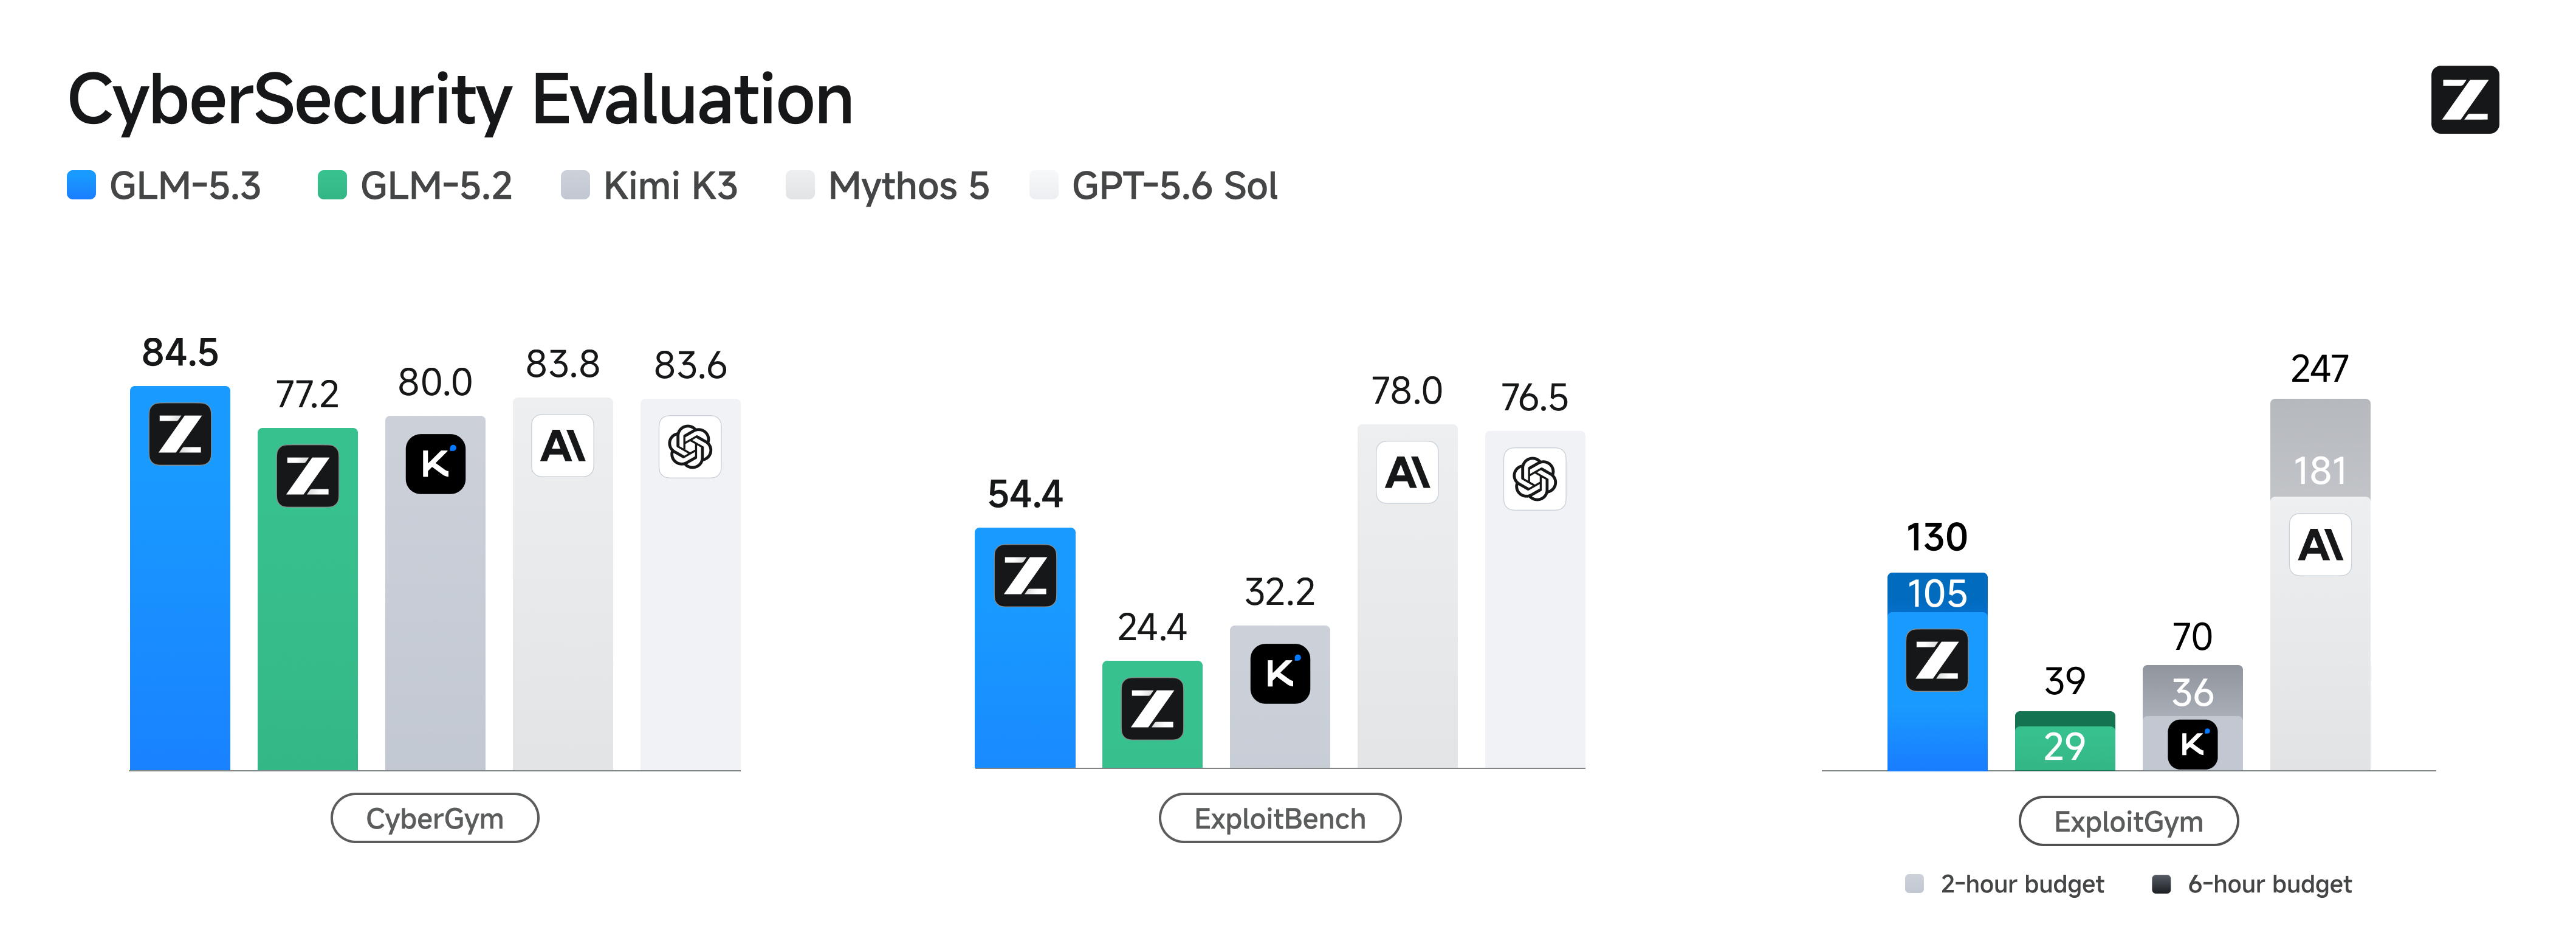
- Capacidad cibernética emergente: A medida que escalamos el post-entrenamiento, la capacidad cibernética se desarrolló más rápido de lo que anticipábamos. GLM-5.3 es el estado del arte en CyberGym para detección de vulnerabilidades, y sus mayores avances se concentran en las etapas más avanzadas de la cadena de explotación, donde más que duplica a GLM-5.2 en los benchmarks de explotación.
- Código abierto: Publicaremos los pesos en dos semanas tras el lanzamiento, una vez completadas las evaluaciones de seguridad y el endurecimiento correspondiente.
Capacidad cibernética emergente
Como parte del post-entrenamiento, incorporamos datos y entornos de detección de vulnerabilidades al conjunto de entrenamiento. Esperábamos que esto mejorara la capacidad del modelo para encontrar y razonar sobre vulnerabilidades. Lo que nos sorprendió fue cuánto superó esa meta.
Evaluamos GLM-5.3 en tres benchmarks que cubren distintas etapas del análisis y la explotación de vulnerabilidades. En CyberGym, que parte de código fuente white-box y comprueba si el modelo puede identificar y validar vulnerabilidades disparando fallos, GLM-5.3 alcanza un 84,5%, frente al 77,2% de GLM-5.2 — el mejor resultado del benchmark, por delante de Mythos 5 (83,8%) y GPT-5.6 Sol (83,6%). En ExploitBench, que exige un razonamiento más profundo sobre vulnerabilidades reales y su explotación, GLM-5.3 llega al 54,4%, más del doble del 24,4% de GLM-5.2, mientras que Mythos 5 y GPT-5.6 Sol obtienen 78,0% y 76,5%, respectivamente. En ExploitGym, que mide cuántas tareas de explotación puede completar un modelo bajo presupuestos normalizados por tiempo, GLM-5.3 completa 105 tareas en dos horas y 130 en seis, frente a 29 y 39 de GLM-5.2. Mythos 5 sigue muy por delante con 181 y 247 tareas. El patrón en los tres es consistente: cuanto más arriba en la cadena de explotación se sitúa un benchmark, mayor es la ganancia respecto a GLM-5.2 — y también más amplia la brecha que queda respecto a la frontera cerrada. La capacidad crece más rápido precisamente donde más rezagados estamos.
Después pusimos a prueba si estas capacidades se transfieren más allá de los benchmarks controlados. Desde GLM-5.2 venimos colaborando con varios equipos de seguridad en China para ejecutar nuestros modelos sobre codebases reales. Tras revisión experta, filtrado y deduplicación, el modelo identificó 2.436 vulnerabilidades en 269 proyectos, incluyendo 1.097 problemas de severidad media a alta. Los hallazgos abarcan kernels de sistema, sistemas operativos, motores de navegador, infraestructura de código abierto, aplicaciones web y protocolos de red. Muchos habían pasado desapercibidos durante años o incluso décadas, con el más antiguo remontándose hace aproximadamente 40 años.
Este trabajo ha evolucionado hasta convertirse en un esfuerzo de divulgación continuo. Construimos el Z.ai Security Disclosure Ledger para mantener un registro público de los hallazgos a medida que avanzan por el proceso de divulgación. El registro se actualiza de forma continua conforme se revisan y divulgan nuevas vulnerabilidades, distinguiendo los problemas ya públicos de aquellos que siguen en proceso de divulgación. Para los problemas divulgados, registra información como el proyecto afectado, la severidad, el CVE cuando está disponible y cuánto tiempo estuvo la vulnerabilidad en el código.
slime: Diseñado para el escalado de RL de horizonte prolongado
Todo esto corre sobre slime, nuestro framework de post-entrenamiento de código abierto para escalado de RL, con Megatron en el lado de entrenamiento y SGLang en el de rollout. Su diseño mantiene el entrenamiento, el rollout y el búfer de datos en un único dataflow, de modo que las matemáticas, el código, los sandboxes, los verificadores y los entornos agénticos de horizonte prolongado se conectan como generación de datos en lugar de cambios al bucle de entrenamiento. Eso es lo que nos permitió seguir añadiendo entornos a lo largo de GLM-5.2 y GLM-5.3 sin reconstruir la infraestructura de entrenamiento cada vez.
Con GLM-5.3 seguimos desarrollándolo en dos frentes. En el lado algorítmico añadimos capacidades orientadas a la investigación en RL: top-p mask, OPD con top-k y vocabulario completo, y configuraciones que mejoran la consistencia entre entrenamiento y rollout, incluyendo setups estilo R3 y alineación numérica completa entre las rutas de entrenamiento y rollout, lo que nos da un control más fino sobre el muestreo, el entrenamiento y las señales del teacher, y agiliza la ejecución de comparaciones controladas. En nuestra evaluación de consistencia entrenamiento–rollout, la diferencia media en log-probabilidades (logprob) se mantuvo a nivel de 1e-7, lo que representa una reducción superior al 99,99% frente a configuraciones anteriores.
También trabajamos en la eficiencia de recursos y el throughput del sistema para RL a gran escala. El almacenamiento local actúa ahora como capa adicional de caché, almacenando estados del modelo y datos de forma jerárquica que de otro modo residirían en memoria del host. Esto cobra especial relevancia en OPD multi-teacher: con conmutación dinámica de teachers y prefetching en el lado de entrenamiento, se pueden emplear varios teachers sin levantar un servicio de inferencia dedicado y de larga duración para cada uno, con un overhead adicional limitado y un consumo de recursos notablemente inferior. Para cargas agénticas y asíncronas, mejoramos la planificación conjunta y el balance de carga entre el router y slime, de manera que las peticiones de rollout con longitudes y tiempos de completitud muy variables aprovechan mejor los recursos de inferencia. Añadimos heurísticas conscientes de la carga de trabajo que derivan configuraciones orientadas al throughput — ratio de recursos prefill/decode, ajustes de concurrencia y otros parámetros críticos — a partir de las características de cada entorno de rollout. Como resultado, en tareas de RL de programación de horizonte prolongado, estas optimizaciones a nivel de sistema mejoraron el throughput de entrenamiento RL de extremo a extremo en más de 2,3×, permitiéndonos escalar el entrenamiento sobre trayectorias más largas y entornos más complejos con una eficiencia sustancialmente mayor.
En conjunto, todo esto nos aporta mayor flexibilidad experimental, menor coste de recursos y mayor throughput — y eso es precisamente lo que hace viable seguir escalando RL.
Cómo empezar con GLM-5.3
Cambios en la API de GLM-5.3
GLM-5.3 admite tres niveles de thinking effort: low, high y max. La desactivación del thinking ya no es compatible en GLM-5.3.
| Parámetro | Valores | Por defecto | Descripción |
|---|---|---|---|
| thinking.type | enabled | enabled | Activa el thinking. disabled ya no es compatible. |
| reasoning_effort | low, high, max | max | low: ligero; high: mejorado; max: profundo. Se recomienda max para tareas de programación. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
Migración necesaria: Si tu aplicación utiliza actualmente thinking.type: "disabled", cámbialo a enabled y ajusta reasoning_effort a low antes de actualizar el ID del modelo a glm-5.3. De lo contrario, la petición fallará.
Usa GLM-5.3 con GLM Coding Plan y ZCode
Prueba GLM-5.3 en tus agentes de programación favoritos — ZCode, Claude Code, OpenCode y más. Consulta la guía de devpack.
Para suscriptores del GLM Coding Plan: ya hemos desplegado GLM-5.3 para todos los usuarios del plan. El nuevo GLM Coding Plan utiliza un sistema de cuota basado en puntos. El consumo de puntos se calcula por separado para los tokens de entrada, entrada en caché y salida. Las llamadas al modelo realizadas fuera de las horas pico consumen el 50% de los puntos estándar. Las horas pico son de 14:00 a 18:00 (UTC+8), de lunes a viernes; todas las demás horas, incluidos los fines de semana, tienen la tarifa reducida del 50%. Empieza a construir ahora: z.ai/subscribe
Sácale más provecho a GLM-5.3 con ZCode
- Más de 98% de cache hit rate — el contexto repetido se factura a la tarifa reducida de caché, ~30% más tokens efectivos
- Aumento de cuota limitado de 1,5× — combínalo con el ahorro de caché para obtener hasta el 180% de tu cuota estándar hasta el 31 de agosto
- Dominio del horizonte prolongado — el modo Goal planifica, programa, prueba y verifica hasta cumplir el objetivo
- Remote Control — supervisa y dirige tareas de larga duración desde tu teléfono vía WeChat o Feishu
Prueba ZCode: zcode.z.ai
Sirve GLM-5.3 localmente
Los pesos del modelo de GLM-5.3 estarán disponibles públicamente pronto, dentro de las dos semanas posteriores al lanzamiento.