Qwen 4 Max: un aliado de 2,4T para tareas largas
Qwen 4 Max es el nuevo modelo insignia de Alibaba para el trabajo profesional, la producción creativa y la investigación. Anunciado por el equipo de Qwen el 16 de noviembre de 2026, Qwen4-Max combina una ventana de contexto de 1M, visión y lenguaje nativos, y un flujo de trabajo para revisar los resultados de un agente de IA mientras aún está trabajando.
Qwen 4 Max: contexto de 1M y arquitectura dispersa
Qwen4-Max usa una nueva arquitectura dispersa de mezcla de expertos con 2,4 billones de parámetros totales, de los cuales activa 71.000 millones por token, además de 328.000 millones de parámetros de N-gram Embedding. Combina capas Gated DeltaNet con atención dispersa de microbloques y cuatro ramas paralelas Gated Residual.
La especificación más destacada para proyectos grandes es la ventana de contexto de 1.000.000 de tokens: espacio suficiente para una base de código completa o un archivo documental entero en una sola ejecución.
Qwen informa que el modelo base alcanza aproximadamente entre un 5% y un 13% menos de bits por byte que Qwen3.8-Max-Base en evaluaciones de Knowledge, Code, QA y STEM, mientras activa un 25% menos de parámetros.
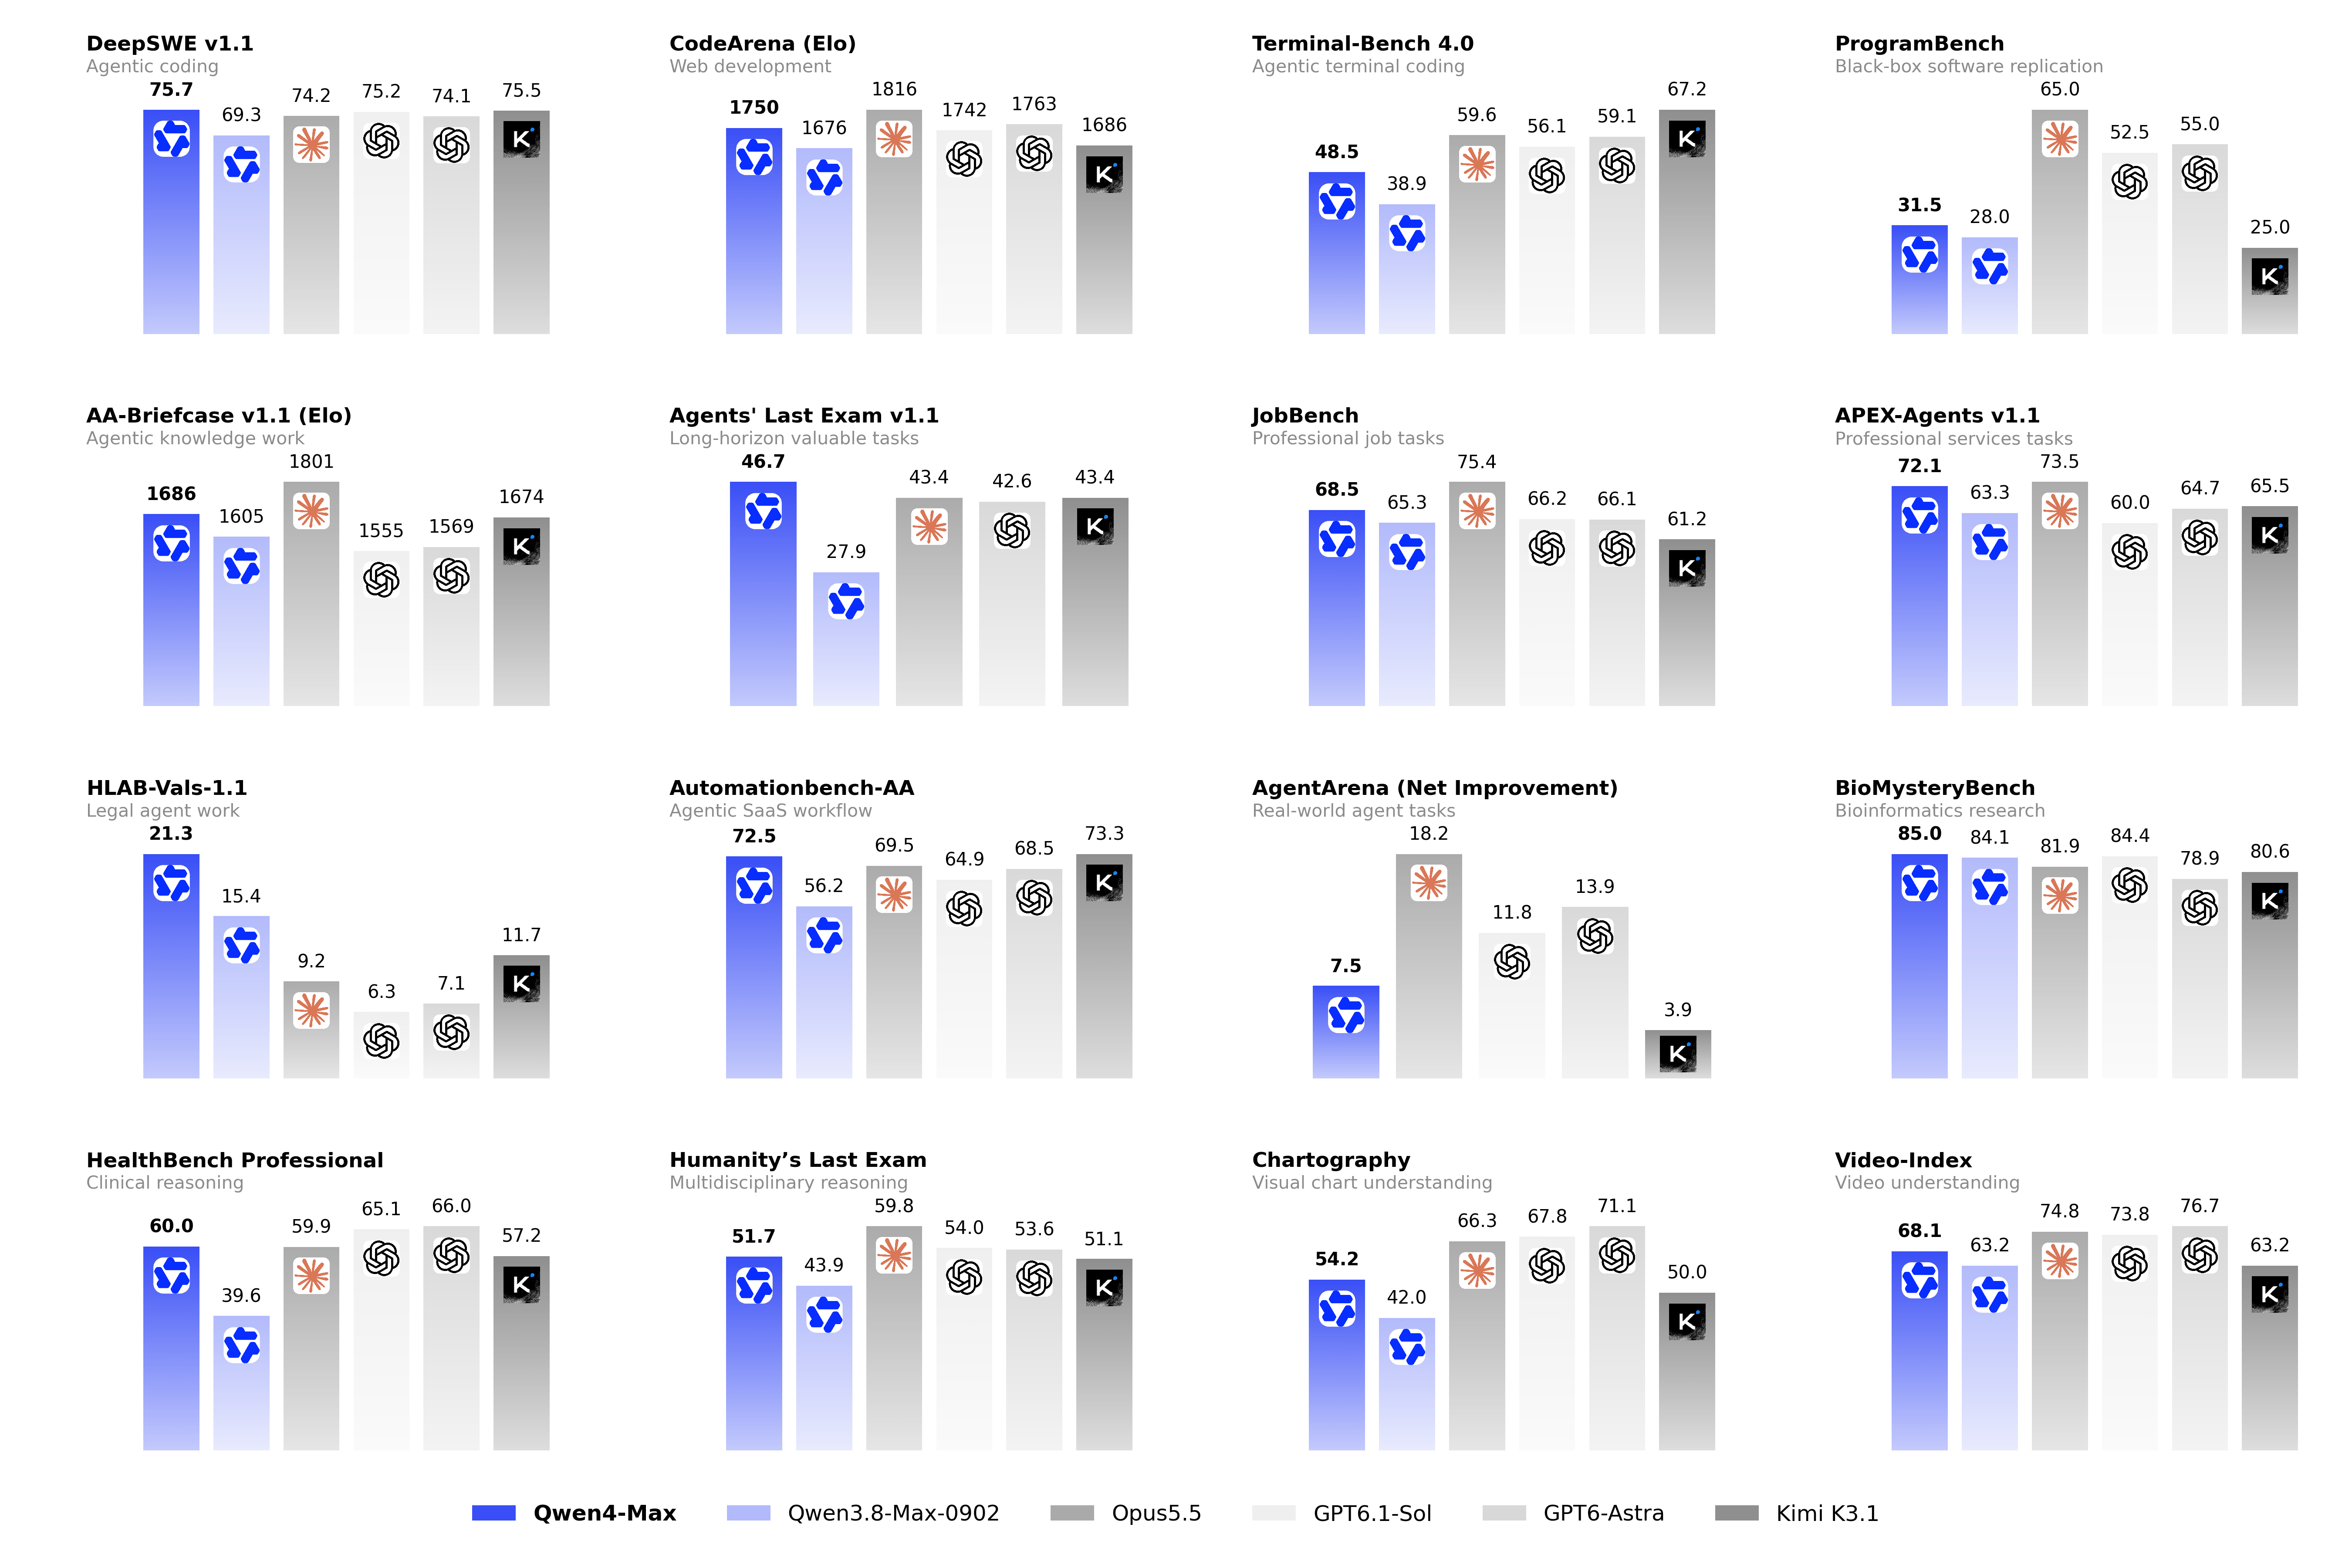
Resultados de benchmarks: mejores puntuaciones con menos tokens
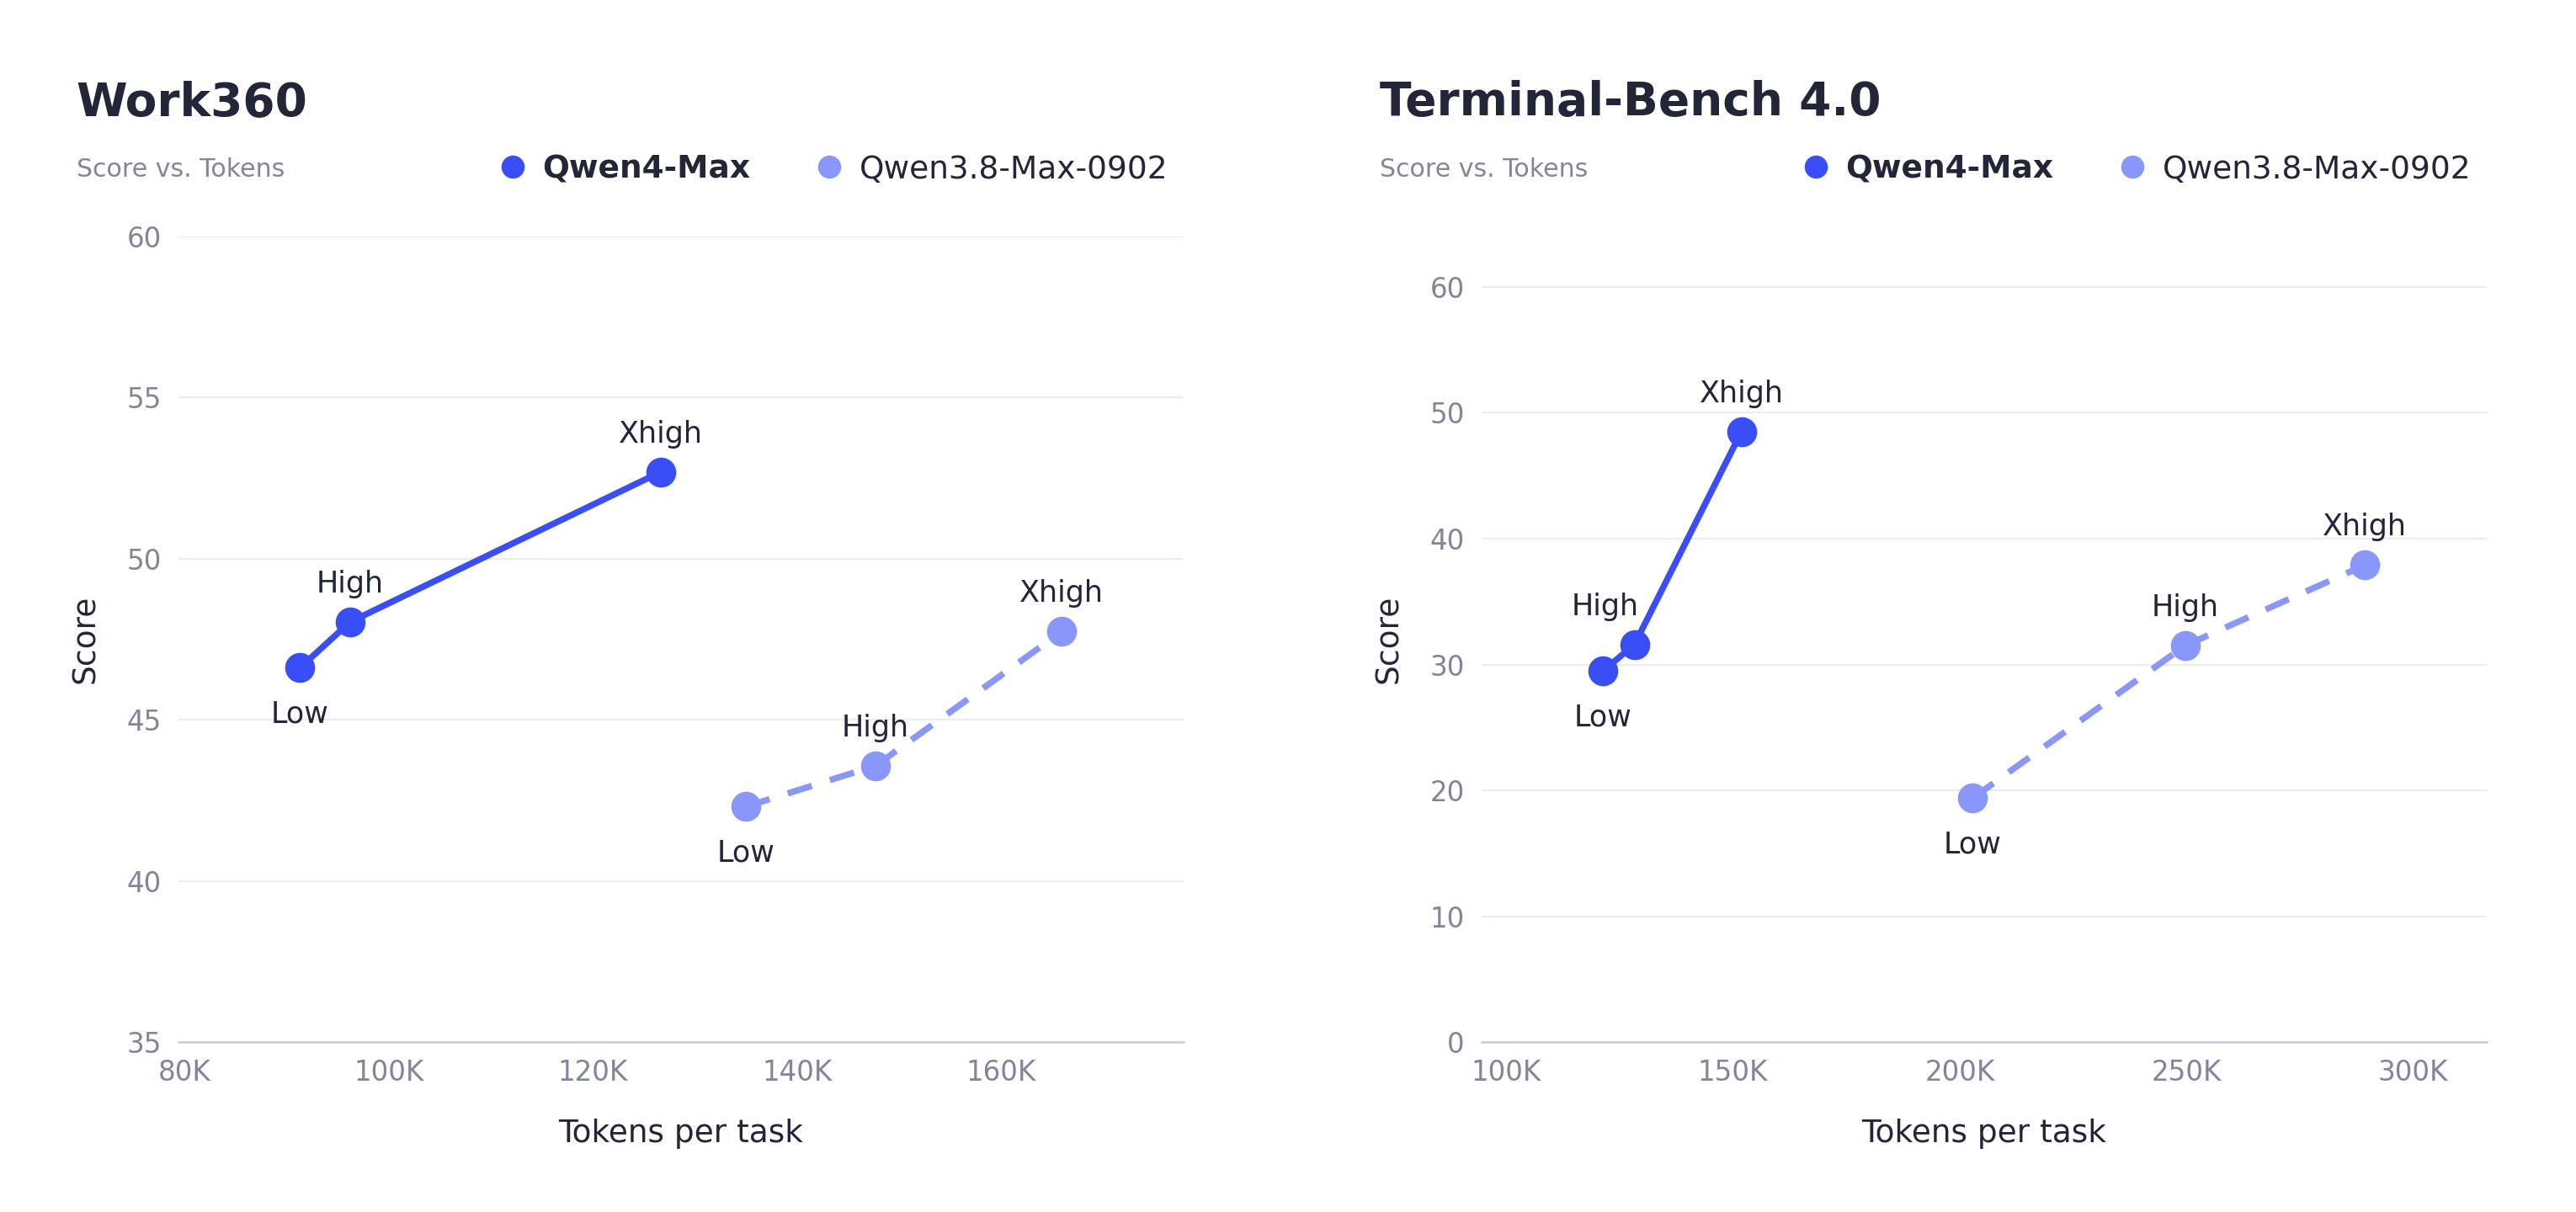
En Work360, un benchmark que abarca 26 dominios de nivel 1, 182 subdominios y 721 campos especializados, Qwen4-Max obtuvo 52,69, frente a los 47,74 de Qwen3.8-Max, según Qwen.
El equipo también informa de un menor uso de tokens: aproximadamente un 24% menos con el esfuerzo Xhigh y un 35% menos con High en Work360, además de entre un 48% y un 49% menos en Terminal-Bench 4.0.
Según Qwen, el costo promedio por tarea en Work360 bajó de $4.43 a $1.67, una reducción del 62%. El anuncio señala que los precios de la API son inferiores a los de Qwen3.8-Max, especialmente para las entradas en caché, pero no publica tarifas exactas. Estos resultados son datos comunicados por el proveedor, no una garantía para todas las cargas de trabajo.
Un agente de IA al que puedes redirigir durante la tarea
El cambio más práctico en el flujo de trabajo es Live Delivery: los agentes de larga duración transmiten entregas intermedias para que los usuarios revisen el progreso y redirijan la tarea antes de que termine. Qwen ha publicado un plugin de Live Delivery de código abierto.
Las demostraciones van desde juegos jugables creados con Unity 6, Unreal Engine y Godot hasta modelado en Blender y producción de video con agentes. A continuación, «Meow of Magic», una aventura de un gato mago que el modelo creó en Unreal Engine.
Entre los ejemplos profesionales hay investigación financiera que utiliza 90 herramientas MCP para crear libros de Excel y presentaciones de PowerPoint, y diligencia debida legal que convierte 198 documentos de trabajo en un informe de 86 páginas con citas. El patrón es el mismo en todos los casos: uso sostenido de herramientas y, después, un entregable que puedes revisar.
Dónde probar Qwen4-Max
Qwen indica que está disponible a través del Plan de tokens o la API de QwenCloud, además de QwenWork, Qoder y QwenStudio. Los pesos de Qwen4-Max no son abiertos; se prevé publicar más adelante modelos Qwen4 más pequeños como código abierto.
Puedes probar modelos de vanguardia en vega.chat o a través de api.vega.chat; revisa el selector de modelos para ver cuándo estará disponible Qwen 4 Max.
Para tareas médicas, legales, financieras y otras de alto impacto, se aplica la advertencia de Qwen: el modelo ayuda a ejercer el criterio profesional. No lo sustituye.