Claude Haiku 5.5 अब VEGA पर उपलब्ध है
Anthropic ने 7 अक्टूबर, 2026 को Claude Haiku 5.5 जारी किया। यह कंपनी का अब तक का सबसे तेज़ और सबसे सक्षम छोटा मॉडल है, और इसे चलाने की औसत लागत Haiku 4.5 से लगभग 75% कम है।
Haiku 5.5 पहले से ही VEGA में काम करता है। यह auto, chat, code, web, extreme और memory मोड के पीछे डिफ़ॉल्ट मॉडल है।
इसे किस काम के लिए बनाया गया है
Haiku 5.5 उन बड़े पैमाने के कामों के लिए है जहाँ गहन तर्क-विचार की तुलना में लागत और गति ज़्यादा मायने रखते हैं। Anthropic ने सारांश, कॉन्टेक्स्ट कॉम्पैक्शन, डेटाबेस क्वेरी और वर्गीकरण को इसके इस्तेमालों में शामिल किया है। यह लाइव ग्राहक सहायता और ब्राउज़र इस्तेमाल के लिए भी उपयुक्त है, जहाँ जवाब देने की गति तय करती है कि उत्पाद का अनुभव कैसा होगा।
कोडिंग सेटअप में, यह Opus 5.5 या Sonnet 5.5 के साथ एक सबएजेंट के रूप में काम करता है। Anthropic स्पष्ट करता है कि कठिन एजेंटिक कोडिंग के लिए यह सही विकल्प नहीं है। Terminal-Bench 4.0 जैसे कामों में Sonnet 5.5 और Opus 5.5 अब भी आगे हैं।
Haiku 5.5 पहला Haiku-क्लास मॉडल भी है जिसमें प्रयास का स्तर समायोजित किया जा सकता है। हर इस्तेमाल के लिए आप कम लागत और बेहतर गुणवत्ता के बीच चुन सकते हैं।
बेंचमार्क
इस तालिका में Haiku 5.5 की तुलना Haiku 4.5, GPT-6 Luna और Sonnet 5.5 से की गई है। Sonnet 5.5 को संदर्भ के लिए शामिल किया गया है।
| बेंचमार्क | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (ज्ञान-आधारित काम) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (ज्ञान-आधारित काम) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, ऑफ़लाइन सबसेट (कंप्यूटर इस्तेमाल) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam, बिना टूल के | 45.9% | 10.2% | n/a | 56.9% |
| Humanity's Last Exam, टूल के साथ | 57.4% | 18.7% | n/a | 64.5% |
| Terminal-Bench 4.0 (एजेंटिक कोडिंग) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1, Main (एजेंटिक कोडिंग) | 46.4% | n/a | 42.4% | 52.1% (Xhigh) |
| Chartography, बिना टूल के (दृश्य तर्क-विचार) | 46.4% | 6.4% | 29.1% | 61.6% |
प्रयास का स्तर बदलने से नतीजों में बड़ा अंतर आता है। OSWorld 2.1 पर Haiku 5.5 का स्कोर Low सेटिंग पर 42.0% ($0.07) से बढ़कर Max पर 72.4% ($0.61) हो जाता है।
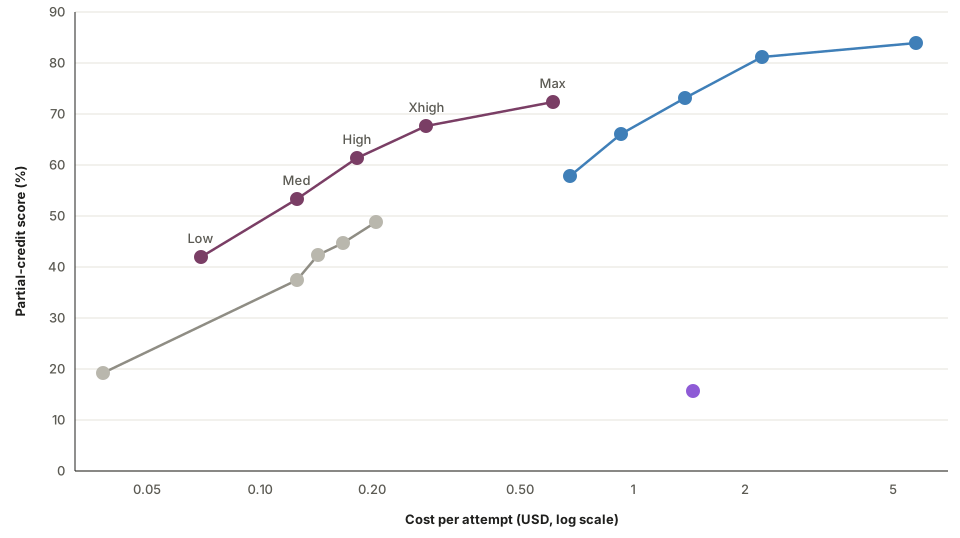
OSWorld 2.1 मापता है कि एजेंट लंबे, कई चरणों वाले कामों के ज़रिए असली कंप्यूटर को कितनी अच्छी तरह चला पाते हैं।
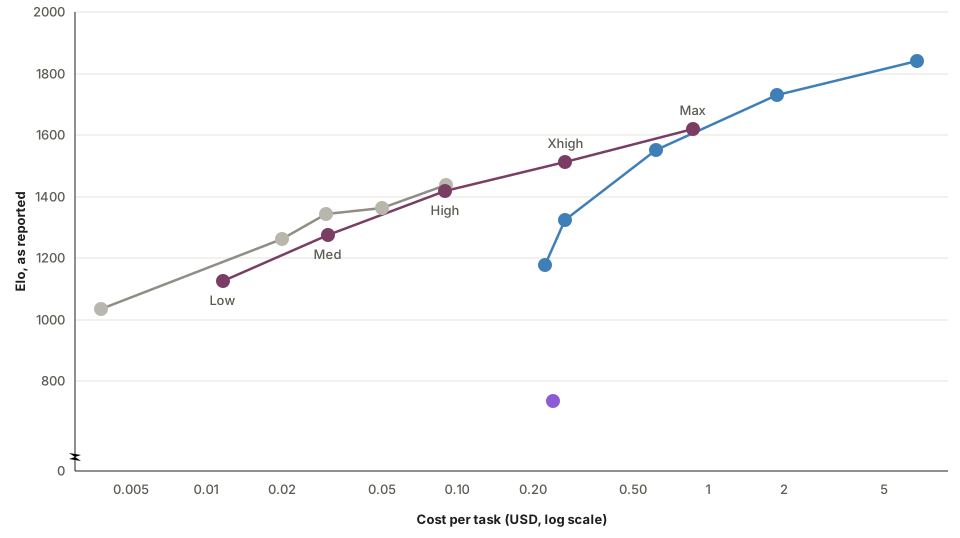
GDPval-AA v2.1 का संचालन Artificial Analysis करता है। यह 44 पेशों के वास्तविक कामों पर एजेंटों को परखता है। Haiku 5.5, Max पर 1620 तक पहुँचता है, जबकि Haiku 4.5 का स्कोर 735 था।
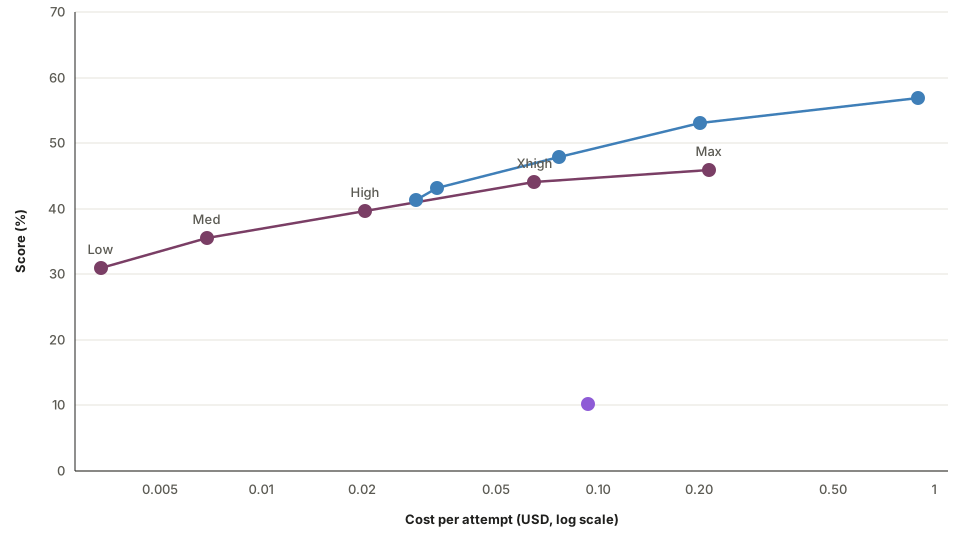
Humanity's Last Exam विशेषज्ञ स्तर के अकादमिक ज्ञान और तर्क-विचार को परखता है। टूल के बिना Haiku 5.5 का स्कोर Max पर 45.9% है, जबकि Haiku 4.5 का स्कोर 10.2% है।
शुरुआती ग्राहकों के नतीजे
Anthropic का कहना है कि शुरुआती परीक्षकों को ऐसे नतीजे मिले जो ऊपर दिए गए आँकड़ों से मेल खाते हैं।
- Asana ने अपना AI Teammates eval चलाया। आज इस्तेमाल किए जा रहे मॉडल की तुलना में, Haiku 5.5 ने काम पूरा करने में लगने वाली लेटेंसी को 30% से अधिक घटाया और प्रति एजेंट टर्न 2.5x तक तेज़ इनफ़रेंस हासिल किया।
- HubSpot ने सिम्युलेटेड CRM पोर्टल पर इसका परीक्षण किया। तीन बार चलाने पर Haiku 5.5 का औसत स्कोर 92.8% रहा—इस सूट पर HubSpot ने अब तक का सबसे अच्छा स्कोर देखा है। इसने पुराने रिकॉर्ड की ऑडिट वाला काम सबसे तेज़ पूरा किया, और परीक्षण किए गए मॉडलों में इसकी हिट रेट सबसे अधिक तथा फ़ॉल्स पॉज़िटिव रेट सबसे कम रही।
- AlphaSense ने Ask in Document के ज़रिए 400 क्वेरी चलाईं। यह एक ऐसा फ़ीचर है जो प्रोडक्शन में प्रति सप्ताह लगभग 8 मिलियन कॉल संभालता है। Haiku 5.5 ने 0.84 स्कोर किया, जबकि Haiku 4.5 का स्कोर 0.76 था—यह अंतर सांख्यिकीय रूप से महत्वपूर्ण है।
- Box ने बताया कि शुरुआती परीक्षण में Haiku 5.5 ने लगभग आधी लेटेंसी पर Haiku 4.5 से 11 अंक अधिक स्कोर किए।
- Cognition ने Devin Fusion की sidekick सूची में Haiku 5.5 को जोड़ा। लीड के रूप में Opus 5.5 के साथ जोड़े जाने पर, Fusion लागत और लेटेंसी घटाते हुए 66.2 का FrontierCode स्कोर बनाए रखता है।
मूल्य निर्धारण
कीमत प्रति दस लाख टोकन के हिसाब से है। पिछले Haiku मॉडल के लगभग 90% अनुरोध 100,000 टोकन तक के थे, और Haiku 5.5 से सबसे ज़्यादा बचत इसी सीमा में होती है।
| प्रति 1 मिलियन टोकन की कीमत | Haiku 5.5 (100k तक / 100k से अधिक) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| कैश रीड | $0.01 / $0.05 | $0.10 | $0.10 |
| कैश राइट | $0.125 / $0.625 | $1.25 | $2.50 |
| इनपुट टोकन | $0.10 / $0.50 | $1.00 | $2.00 |
| आउटपुट टोकन | $0.50 / $2.50 | $5.00 | $10.00 |
100,000 टोकन तक के प्रॉम्प्ट के लिए Haiku 5.5 की कीमत Haiku 4.5 से 90% कम है, और इससे लंबे प्रॉम्प्ट के लिए 50% कम। औसत बचत लगभग 75% है। इस आँकड़े में नए tokenizer का असर भी शामिल है, जो Sonnet 5.5 और Opus 5.5 वाले tokenizer से मिलता-जुलता है और हर काम में थोड़े अधिक टोकन बनाता है।
कीमतों में अन्य बदलाव
Anthropic ने अपने दूसरे मॉडलों की कीमतें भी बदलीं। Sonnet 5.5 के कैश रीड अब 50% सस्ते हैं—प्रति मिलियन टोकन $0.20 की जगह $0.10। ज़्यादातर एजेंटिक कामों में इससे Sonnet 5.5 की लागत लगभग 20% घट जाती है। Terminal-Bench 4.0 के लिए नीचे दिया गया चार्ट कैश की दोनों कीमतें दिखाता है।

Terminal-Bench 4.0 मापता है कि कमांड-लाइन इंटरफ़ेस में कोई मॉडल जटिल, कई चरणों वाले पेशेवर काम कितनी अच्छी तरह पूरा करता है। चार्ट यह भी दिखाता है कि Haiku 5.5 और बड़े मॉडल अलग-अलग तरह के कामों के लिए क्यों हैं। Sonnet 5.5 और Opus 5.5 जटिल एजेंटिक कोडिंग बेहतर ढंग से करते हैं, जबकि Haiku 5.5 कॉम्पैक्शन, सारांश और सबएजेंट के काम जैसे सीमित दायरे के कार्यों के लिए उपयुक्त है।
Max और Team सब्सक्राइबर को अब हर महीने नया API क्रेडिट भी मिलता है। Max 5x उपयोगकर्ताओं को हर महीने $100, Max 20x उपयोगकर्ताओं को $200, और Team सब्सक्राइबर को अपने उपयोगकर्ताओं के बीच साझा करने के लिए कुल $500 तक मिलते हैं। ये क्रेडिट इसी सप्ताह से मिलने लगेंगे और Claude Platform के किसी भी मॉडल के साथ काम करेंगे।
Python और TypeScript Claude SDK अब बीटा में कंप्यूटर और ब्राउज़र इस्तेमाल का समर्थन करते हैं। Anthropic का कहना है कि अपनी गति, क्षमता और कीमत के कारण Haiku 5.5 इन कामों के लिए उपयुक्त है।
सुरक्षा
लगभग हर अलाइनमेंट मूल्यांकन में Haiku 5.5, Haiku 4.5 से बेहतर है। यह मॉडल अलाइनमेंट से हटे व्यवहार बहुत कम दिखाता है और दुरुपयोग में मदद करने के लिए कम इच्छुक है।
इसके साइबर सुरक्षा उपाय Haiku 4.5 से ज़्यादा सख़्त हैं, लेकिन Sonnet 5.5 के उपायों से कम सख़्त हैं। ये ज़्यादा रक्षात्मक कामों की अनुमति देते हैं, लेकिन पेनेट्रेशन टेस्टिंग और हमलावरों द्वारा इस्तेमाल किए जाने की आशंका वाली अन्य तकनीकों को अब भी रोकते हैं। इसके जीवविज्ञान संबंधी सुरक्षा उपाय Sonnet 5, Sonnet 5.5 और Opus 5 के समान हैं। जीवविज्ञान से जुड़े शोध प्रश्नों की अनुमति है, जबकि नुकसान पहुँचाने की आशंका वाले अनुरोधों पर पाबंदी है। जीवविज्ञान या साइबर सुरक्षा से जुड़ी व्यापक ज़रूरतों वाले संगठन Anthropic के Life Sciences Verification Program और Cyber Verification Program के लिए आवेदन कर सकते हैं।
उपलब्धता
Haiku 5.5 अब Amazon Web Services, Google Cloud और Microsoft Azure समेत सभी प्रमुख क्लाउड प्लेटफ़ॉर्म पर उपलब्ध है। Claude Platform पर इसका मॉडल ID claude-haiku-5-5 है।
VEGA पर आज़माएँ
VEGA के auto, chat, code, web, extreme और memory मोड में Haiku 5.5 डिफ़ॉल्ट मॉडल है। यह तुरंत जवाब देने, सारांश बनाने और जानकारी खोजने जैसे कामों के लिए उपयुक्त है, जहाँ गति सबसे ज़्यादा मायने रखती है।
सबसे कठिन, खुले दायरे वाले कामों के लिए Opus 5.5 और Sonnet 5.5 अब भी बेहतर विकल्प हैं—जैसा कि Anthropic भी कहता है।
Anthropic की मूल घोषणा anthropic.com/claude-haiku-5-5 पर पढ़ें।