DeepSeek V4.1 Flash: विकास या क्रांति?
DeepSeek ने 10 सितंबर, 2026 को V4.1-Flash जारी किया। यह 552B-पैरामीटर वाला मल्टीमॉडल Mixture-of-Experts मॉडल है, जिसकी कॉन्टेक्स्ट विंडो 1M टोकन की है। DeepSeek के अपने बेंचमार्क के अनुसार, यह कई एजेंटिक कार्यों पर Opus-5.0 के बराबर या उससे बेहतर प्रदर्शन करता है। इसकी कीमत भी कम है: ऑफ़-पीक समय में इनपुट की लागत प्रति दस लाख टोकन $0.15 और आउटपुट की लागत $0.60 है। इनपुट पर यह DeepSeek V4-Pro से लगभग 4 गुना और आउटपुट पर 3 गुना सस्ता है।
यह मॉडल अब vega.chat पर और api.vega.chat API के ज़रिए उपलब्ध है।
आर्किटेक्चर
DeepSeek-V4.1-Flash Causal Encoder-Decoder (CED) आर्किटेक्चर का इस्तेमाल करता है: 40-लेयर Transformer, जिसे 20-लेयर causal encoder और 20-लेयर decoder में बाँटा गया है। Decoder का KV cache, हर decoder layer के अपने hidden states के बजाय encoder के अंतिम hidden states से प्रोजेक्ट किया जाता है। इससे मॉडल prefill के दौरान प्रति टोकन केवल 8B पैरामीटर और decode के दौरान 16B पैरामीटर सक्रिय करता है।
MoE लेयर में 1 साझा expert और 384 routed experts हैं, जिनमें से हर टोकन के लिए 6 routed experts सक्रिय होते हैं। मॉडल, vision encoder (DeepSeek-ViT, जिसे 2D-RoPE के साथ शुरू से प्रशिक्षित किया गया है) और दो-लेयर MLP projector के ज़रिए, इमेज और टेक्स्ट को मूल रूप से प्रोसेस करता है।
DeepSeek ने मॉडल को 45T-टोकन वाले मल्टीमॉडल कॉर्पस पर शुरू से प्रशिक्षित किया। इसमें 64K sequence length पर sparse attention का उपयोग किया गया और 34T टोकन पर कॉन्टेक्स्ट को बढ़ाकर 1M टोकन किया गया। पोस्ट-ट्रेनिंग पाइपलाइन SFT, RL और on-policy distillation के क्रम का पालन करती है, जिसमें एल्गोरिदम में कोई बदलाव नहीं किया गया। मुख्य काम डेटा पाइपलाइन पर हुआ: डेटा, कार्यों और rollouts को चरणबद्ध तरीके से बढ़ाते हुए एजेंट कार्यों और वातावरणों का बड़े पैमाने पर स्वचालित संश्लेषण।
प्रदर्शन: Flash कीमत पर Opus-स्तर
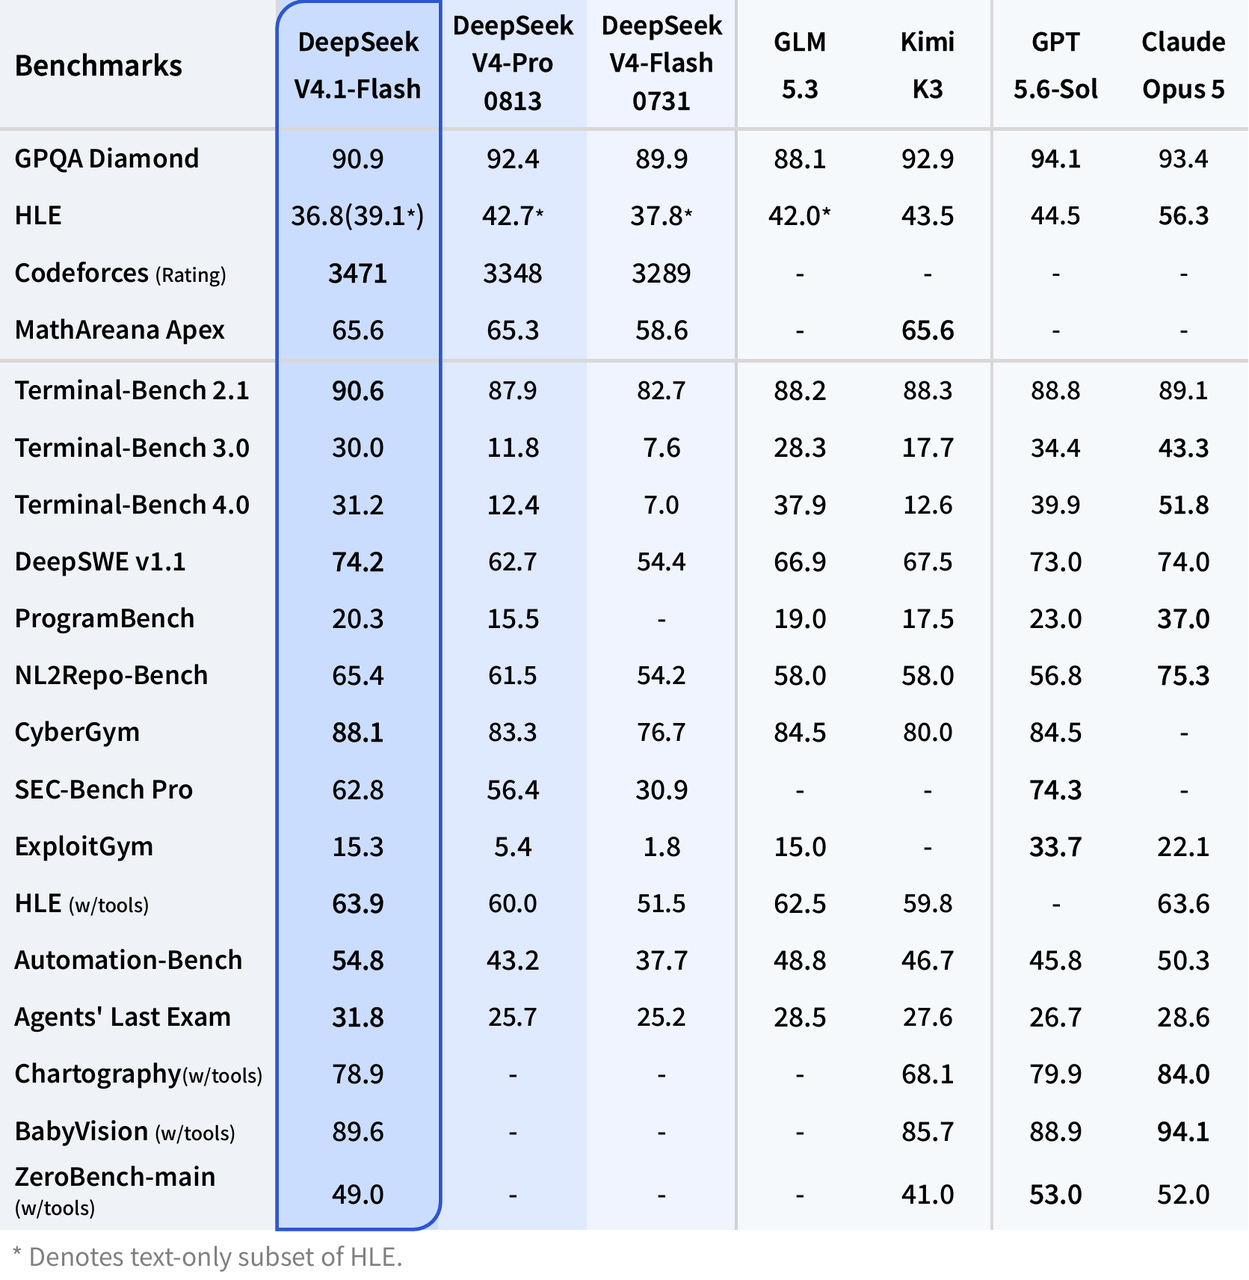
DeepSeek के अपने बेंचमार्क में V4.1-Flash, Opus-5.0 के स्तर पर है और कई एजेंटिक कार्यों पर उससे आगे है। Terminal-Bench 2.1 पर V4.1-Flash का स्कोर 90.6 है, जो Opus-5.0 के 89.1 से बेहतर है। DeepSWE v1.1 पर इसका स्कोर 74.2 है, जो Opus के 74.0 से आगे है। Agent's Last Exam पर इसका स्कोर 31.8 है—Opus, GPT-5.6 Sol, K3, GLM-5.3 और V4-Pro समेत तुलना किए गए सभी मॉडलों में सबसे अच्छा। Codeforces पर इसकी रेटिंग 3471 है, जो तुलना में सबसे अधिक है। AutomationBench पर इसका स्कोर 54.8 है—यहाँ भी सबसे अच्छा।
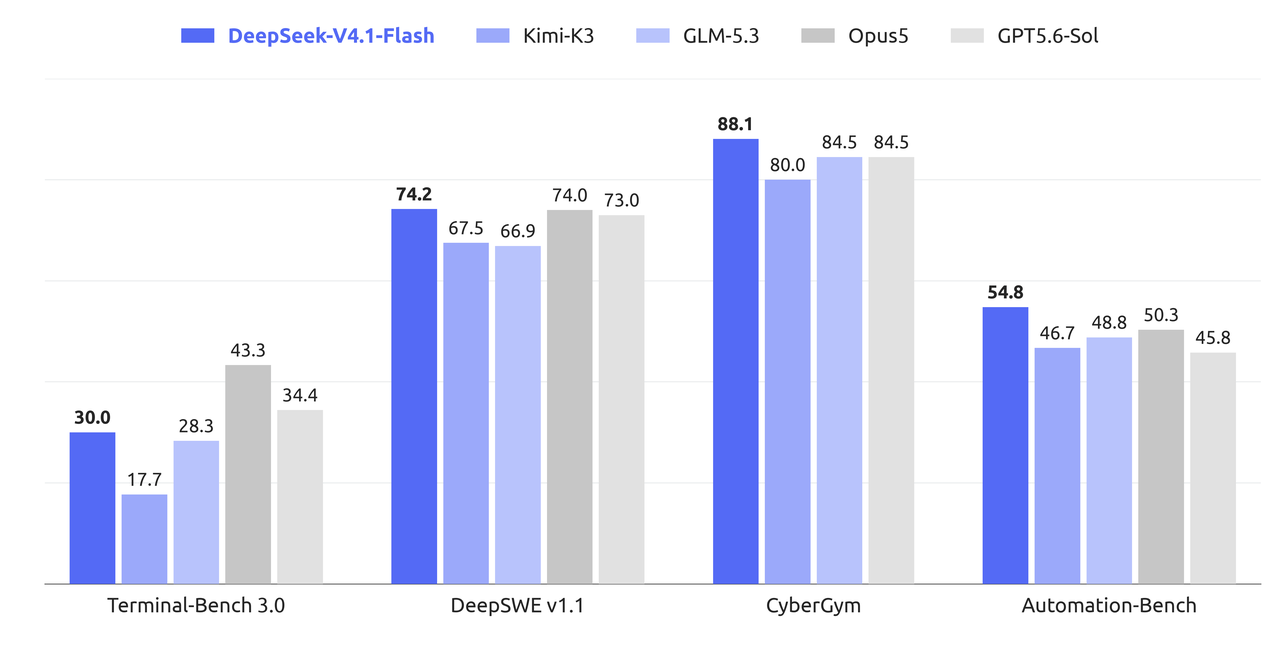
पूरी बेंचमार्क तालिका में सात मॉडलों के तर्क, एजेंटिक और विज़ुअल कार्य शामिल हैं। Terminal-Bench 2.1, DeepSWE v1.1, Codeforces, CyberGym, tools के साथ HLE, AutomationBench और Agent's Last Exam में V4.1-Flash शीर्ष स्थान पर है।
DeepSeek का कहना है कि कई पक्षों द्वारा किए गए परीक्षणों में प्रदर्शन, लागत, गति और कुल रनटाइम के मामले में V4.1-Flash, V4-Pro से आगे रहा। कंपनी V4-Pro को चरणबद्ध तरीके से बंद कर रही है। 14 सितंबर, 2026 से, deepseek-v4-pro API के सभी अनुरोध V4.1-Flash पर रूट होंगे और उन पर V4.1-Flash की दरें लागू होंगी—V4.1-Pro के लॉन्च होने तक।
KV cache: 4 गुना छोटा
मॉडल Compressed Sparse Attention 2 (CSA2) का इस्तेमाल करता है, जो हर attention layer को तीन स्थिर मोड में से एक देता है: Full, Reindex या Reuse। इससे अलग-अलग लेयर के बीच मुख्य KV और indexer K साझा होते हैं और Top-K sparse-attention indices का दोबारा इस्तेमाल किया जाता है। FP4 main KV caching (E2M1 फ़ॉर्मैट, हर 16 चैनल पर एक E4M3 scale) के साथ मिलकर, कुल KV cache का आकार घटकर प्रति टोकन 890 bytes हो जाता है। यह DeepSeek V4-Flash के आकार का लगभग 1/4 और DeepSeek V1 के आकार का 1/437 है।
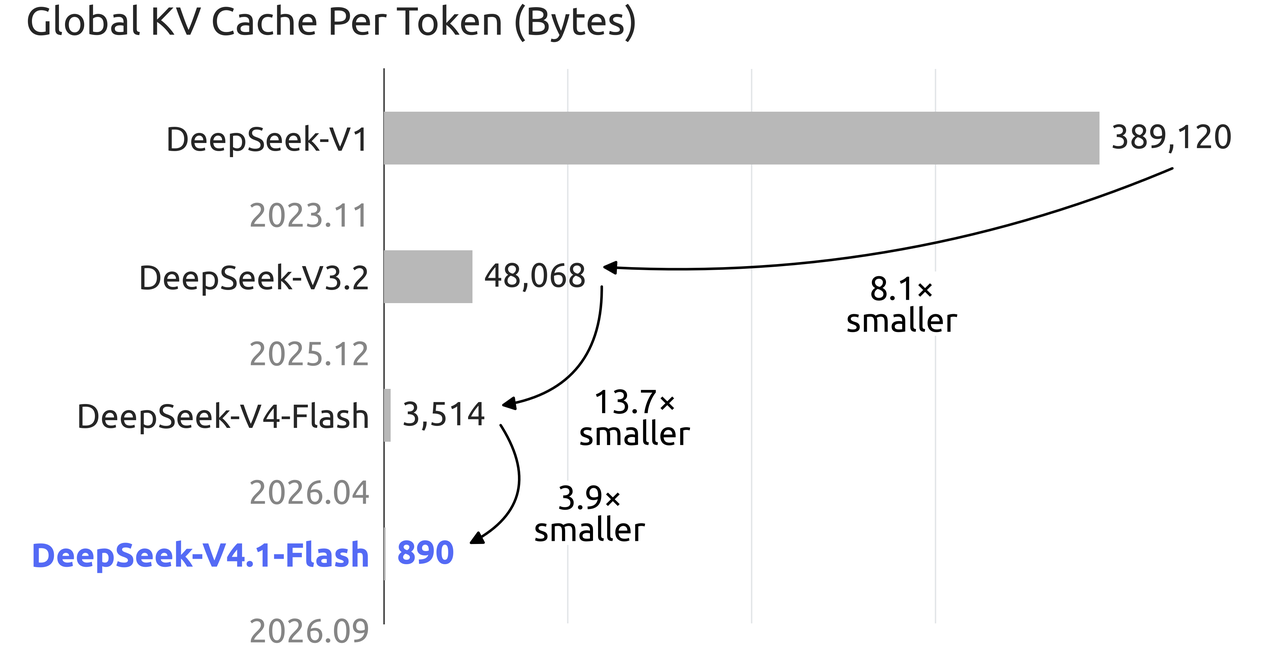
Cache-hit शुल्क अक्सर एजेंट की लागत का बड़ा हिस्सा होते हैं। Cache को कंप्रेस करने से ये लागतें सीधे घटती हैं। पिछली पीढ़ी की तुलना में, V4.1-Flash को अपने KV cache के लिए 1/4 HBM और 1/8 SSD स्टोरेज की ज़रूरत होती है।
कीमत
V4.1-Flash में peak और off-peak कीमतें लागू होती हैं। Off-peak दरें peak दरों की 50% हैं। नई कीमतें 10 सितंबर, 2026 को 04:00 UTC से लागू हुईं।
| टोकन का प्रकार | Off-peak (प्रति 1M) | Peak (प्रति 1M) |
|---|---|---|
| इनपुट (cache hit) | $0.003 | $0.006 |
| इनपुट (cache miss) | $0.15 | $0.30 |
| आउटपुट | $0.60 | $1.20 |
तुलना के लिए, V4-Pro की कीमत प्रति 1M इनपुट टोकन (off-peak, cache miss) $0.66 और प्रति 1M आउटपुट टोकन (off-peak) $1.98 है। बेंचमार्क पर V4-Pro के बराबर या उससे बेहतर प्रदर्शन करते हुए, V4.1-Flash इनपुट पर लगभग 4 गुना और आउटपुट पर 3 गुना सस्ता है।

रोज़मर्रा के काम, एजेंट और वाइब-कोडिंग
V4.1-Flash को ऐसे एजेंटिक वर्कलोड के लिए बनाया गया है जिनमें इनपुट की मात्रा ज़्यादा होती है। Prefill के दौरान 8B सक्रिय पैरामीटर होने से लंबे कॉन्टेक्स्ट को प्रोसेस करना सस्ता पड़ता है—एजेंट की लागत का बड़ा हिस्सा यहीं जमा होता है। 1M-टोकन कॉन्टेक्स्ट विंडो और मूल मल्टीमॉडल सपोर्ट (टेक्स्ट और इमेज) की मदद से यह बड़े दस्तावेज़ों, कोडबेस और विज़ुअल इनपुट को एक ही बार में पढ़ सकता है।
मॉडल में reasoning effort को लगातार नियंत्रित करने की सेटिंग उपलब्ध है (पूर्णांक 1 से 100 तक), जो inference लागत और सटीकता के बीच संतुलन बनाती है। कम effort स्तर सरल प्रश्नों के लिए टोकन ओवरहेड घटाते हैं। ऊँचे स्तर जटिल समस्याओं के लिए reasoning के अतिरिक्त चरण जोड़ते हैं। इससे यह केवल भारी एजेंटिक लूप के लिए ही नहीं, बल्कि रोज़मर्रा की चैट और त्वरित सवालों के लिए भी उपयोगी बनता है।
एजेंटिक बेंचमार्क पर मॉडल ने अपने सर्वश्रेष्ठ स्कोर दर्ज किए हैं: Terminal-Bench 2.1 (90.6), DeepSWE v1.1 (74.2), Agent's Last Exam (31.8) और AutomationBench (54.8)। यह tool calls, JSON आउटपुट और Responses API को सपोर्ट करता है। DeepSeek के आधिकारिक पार्टनर WorkBuddy (जिसमें CodeBuddy भी शामिल है) और OpenCode अब V4.1-Flash को पूरी तरह सपोर्ट करते हैं।
वाइब-कोडिंग के लिए, Codeforces पर 3471 की रेटिंग और DeepSWE v1.1 पर 74.2 का स्कोर V4.1-Flash को तुलना में शीर्ष पर रखते हैं—Opus-5.0 और GPT-5.6 Sol से भी आगे। कम कीमत और 1M कॉन्टेक्स्ट के साथ, यह उन coding agents के लिए एक मज़बूत डिफ़ॉल्ट मॉडल बनता है जो लंबे सेशन चलाते हैं और बड़े कॉन्टेक्स्ट विंडो जमा करते हैं।
vega.chat पर DeepSeek V4.1-Flash आज़माएँ
DeepSeek V4.1-Flash अब vega.chat पर और api.vega.chat API के ज़रिए उपलब्ध है। आप इसे चैट इंटरफ़ेस में आज़मा सकते हैं, अन्य मॉडलों के साथ इसके जवाबों की आमने-सामने तुलना कर सकते हैं, या api.vega.chat पर OpenRouter-संगत API के ज़रिए इसे अपने ऐप्लिकेशन में इंटीग्रेट कर सकते हैं।