GLM-5.3: फ्रंटियर कोडिंग और उभरती साइबर क्षमताएँ
GLM-5.3 के मामले में, हमने बस एक ही चीज़ पर ध्यान केंद्रित किया — पोस्ट-ट्रेनिंग को स्केल करना। GLM-5.2 के साथ हमने पूरा स्टैक खड़ा किया था: एफिशिएंट लॉन्ग-कॉन्टेक्स्ट प्रोसेसिंग के लिए IndexShare, लॉन्ग-होराइज़न टास्क्स पर RL के लिए SAO, और लार्ज-स्केल एसिंक्रोनस ट्रेनिंग के लिए slime — ये सब उन लॉन्ग-होराइज़न टास्क एनवायरनमेंट्स पर चल रहे हैं जिन्हें हम लगातार जमा कर रहे हैं। पिछले एक महीने में हमने इसी स्टैक पर स्केलिंग जारी रखी: ज़्यादा एनवायरनमेंट्स, ज़्यादा विविध टास्क्स, और उन पर ट्रेनिंग के लिए ज़्यादा कंप्यूट।
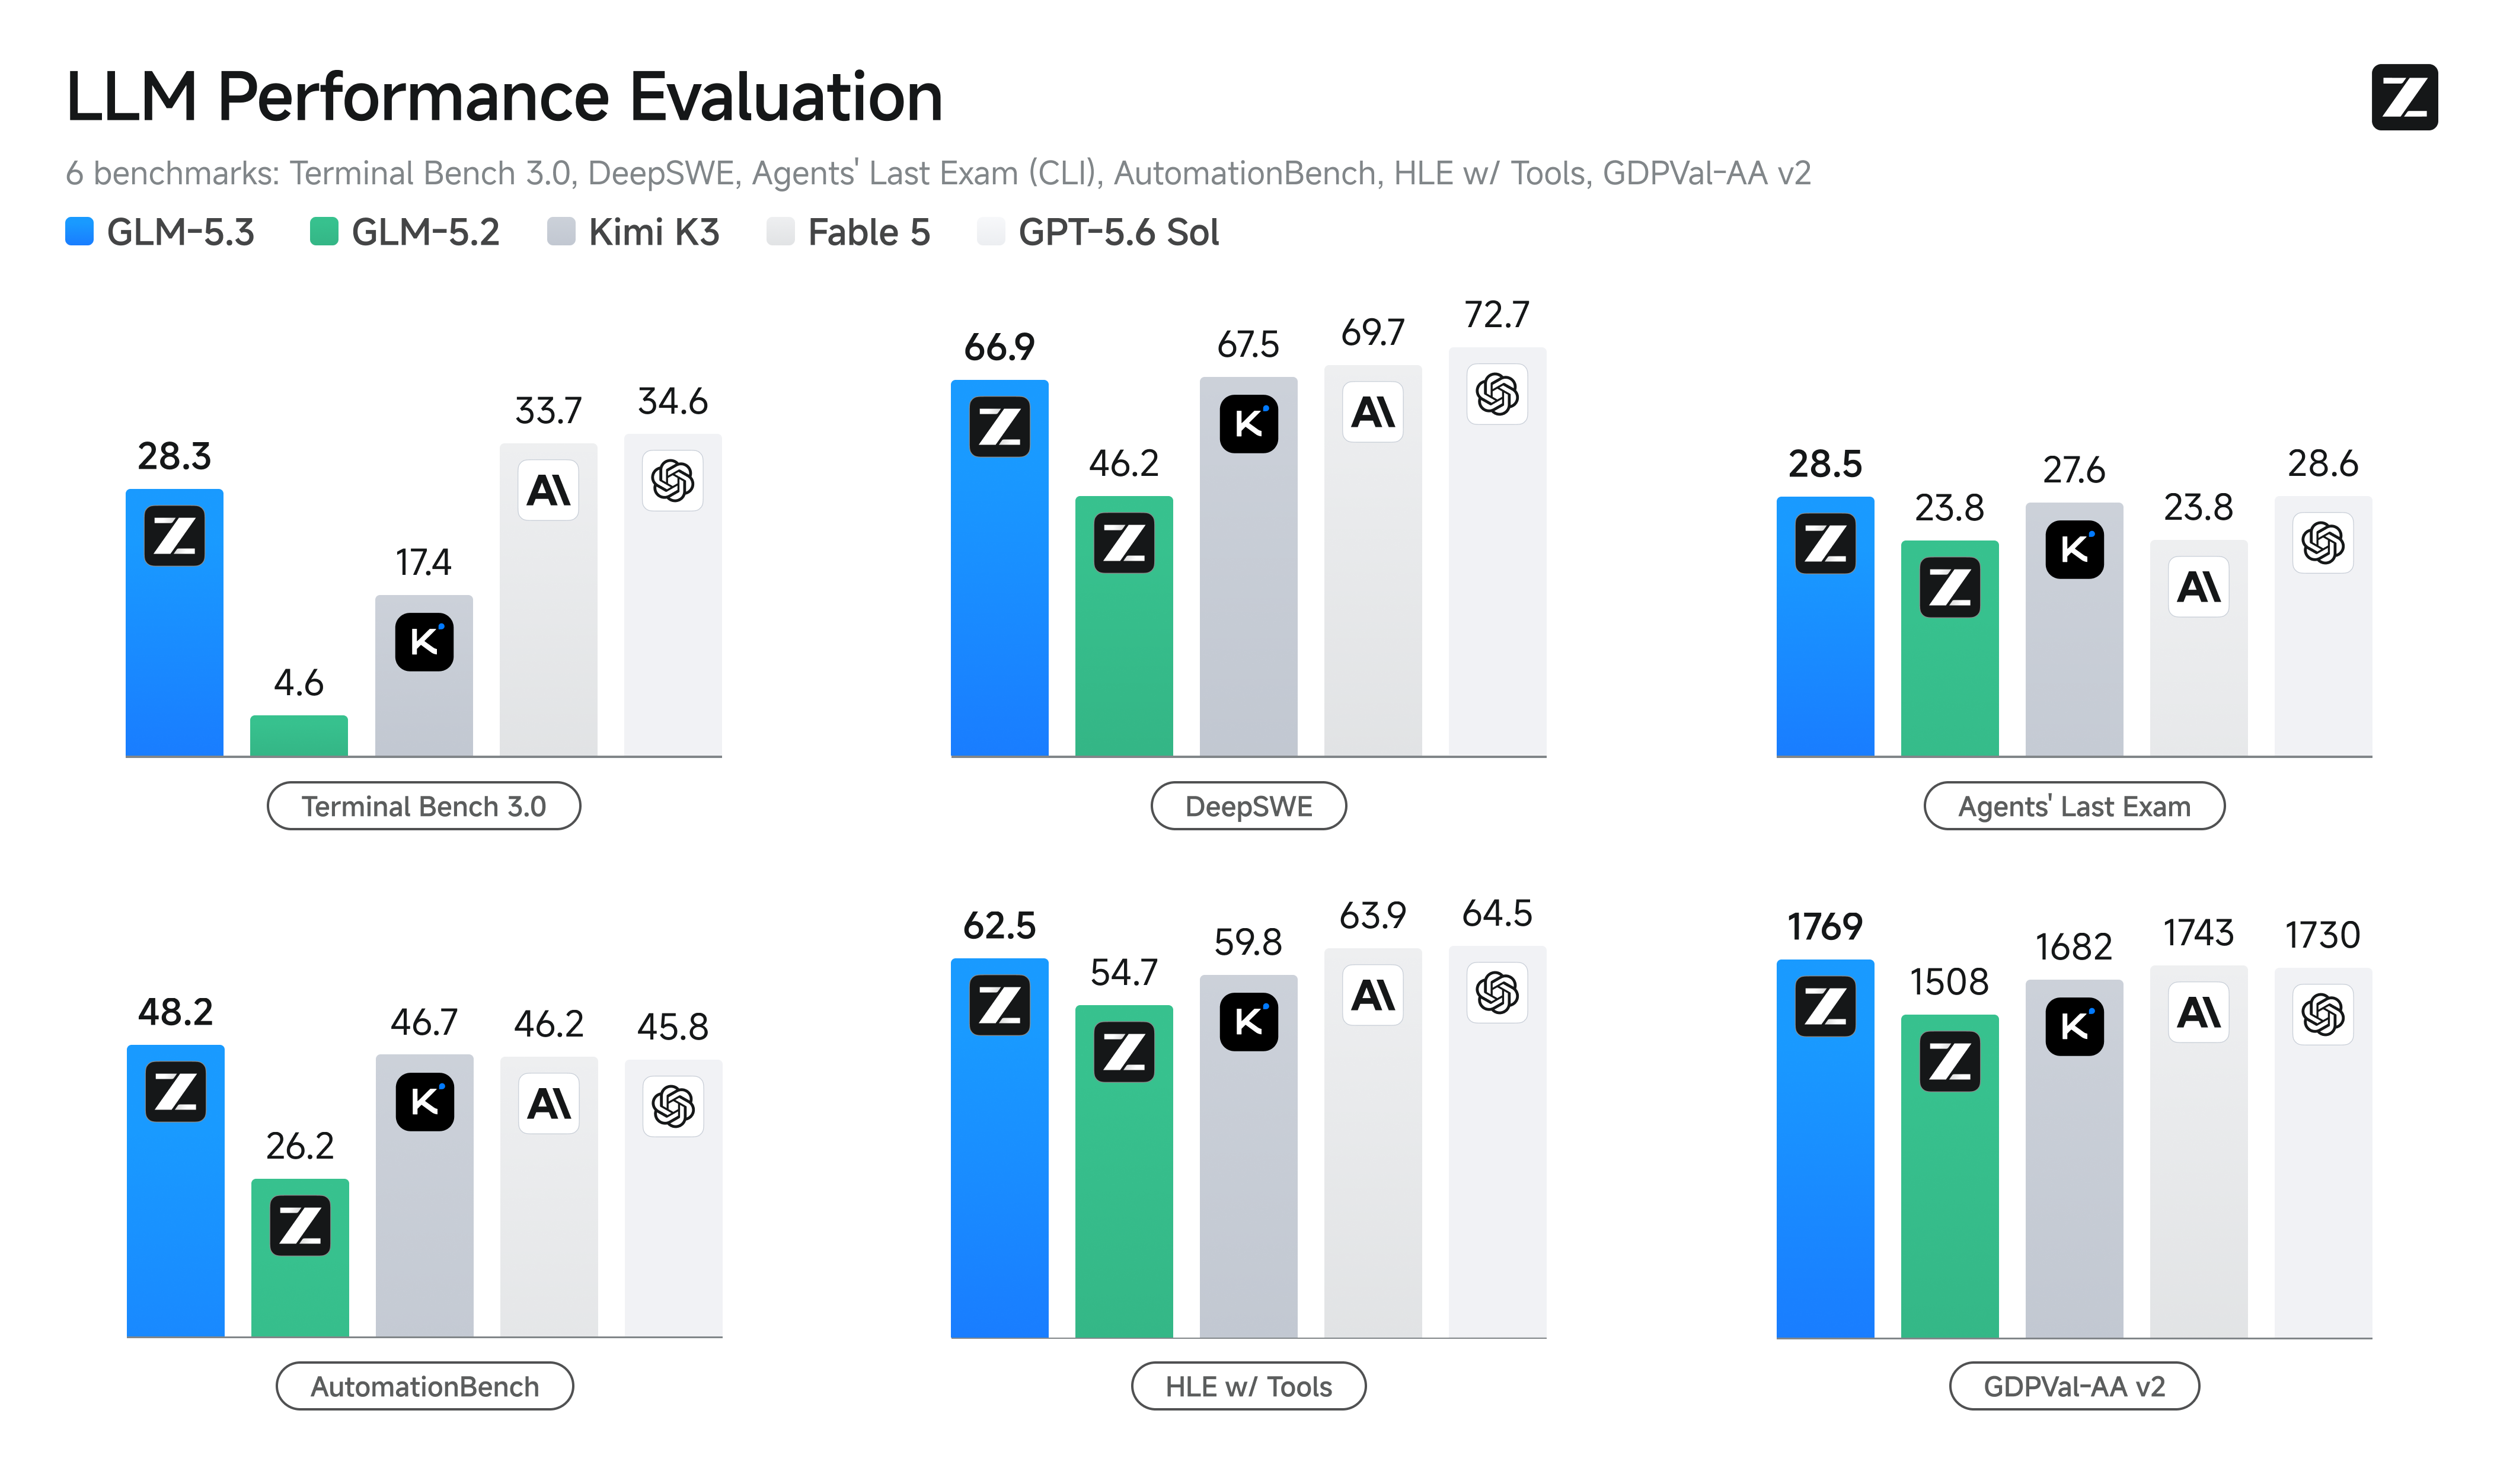
आज हम GLM-5.3 रिलीज़ कर रहे हैं। इसमें वही बेस मॉडल इस्तेमाल हुआ है जो GLM-5.2 में था — हर एक सुधार पोस्ट-ट्रेनिंग का नतीजा है। GLM-5.2 के मुकाबले, यह कॉम्प्लेक्स कोडिंग और लॉन्ग-होराइज़न टास्क्स में कहीं बेहतर है:
- और मज़बूत कोडिंग: GLM-5.3 कोडिंग के लिए सबसे क्षमतावान ओपन-वेट्स मॉडल है। हमारे इन-हाउस Z.ai Code Bench पर इसने GLM-5.2 से 50% का सुधार दिखाया है। साथ ही, Terminal Bench 3.0 और Agents' Last Exam जैसे पब्लिक बेंचमार्क्स पर इसने ओपन-सोर्स SOTA हासिल किया है।
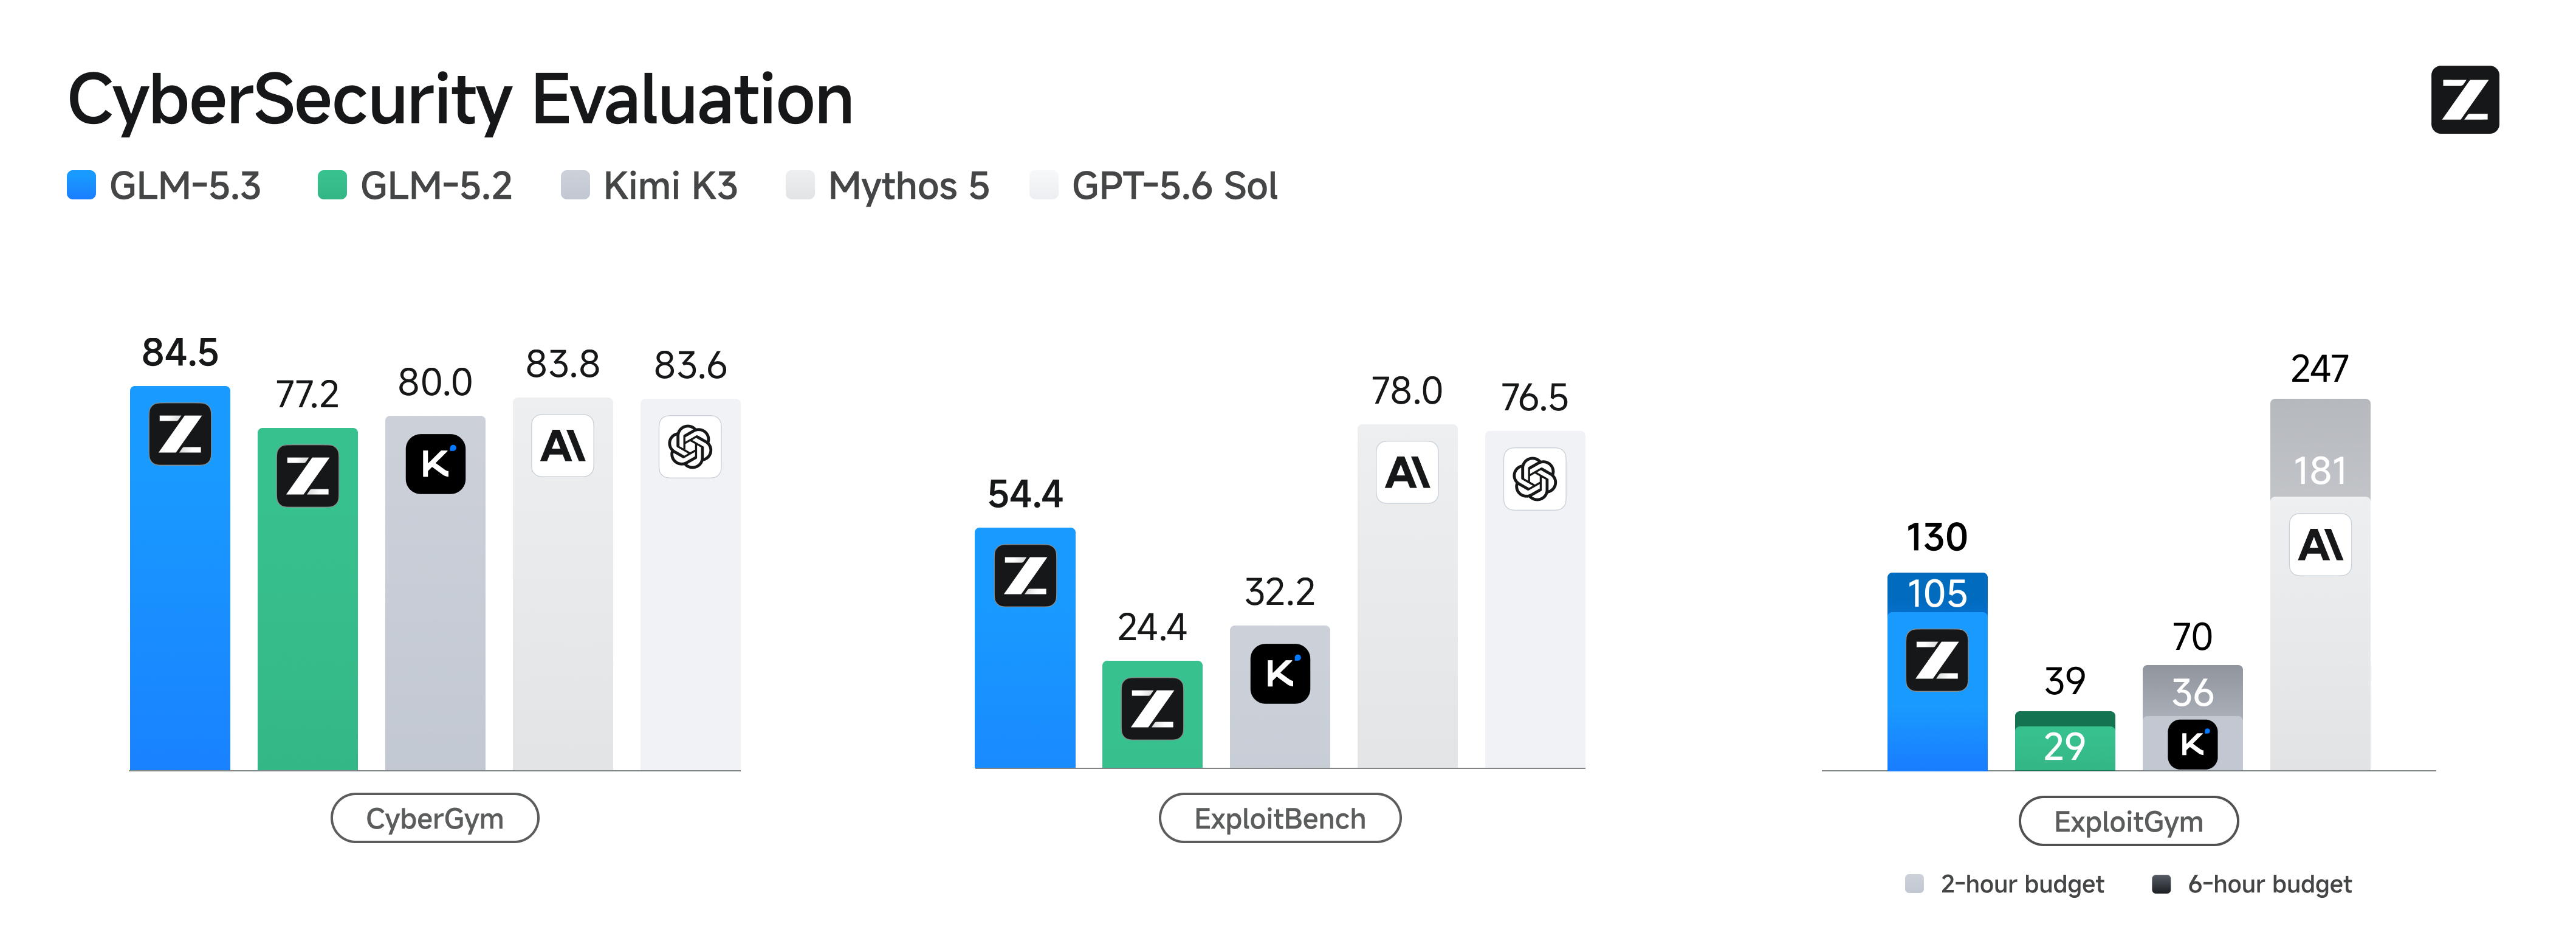
- उभरती साइबर क्षमता: जैसे-जैसे हमने पोस्ट-ट्रेनिंग को स्केल किया, साइबर क्षमता हमारी उम्मीद से कहीं तेज़ी से विकसित हुई। CyberGym पर वल्नरेबिलिटी डिस्कवरी के लिए GLM-5.3 स्टेट-ऑफ-द-आर्ट है, और एक्सप्लॉइटेशन चेन के ऊपरी हिस्सों में इसका फायदा सबसे बड़ा है — एक्सप्लॉइटेशन बेंचमार्क्स पर इसने GLM-5.2 के आंकड़े को दोगुने से भी ज़्यादा कर दिया।
- ओपन सोर्स: लॉन्च के दो हफ्ते बाद, सेफ्टी इवैल्यूएशन और हार्डनिंग पूरी होने पर हम वेट्स रिलीज़ करेंगे।
उभरती साइबर क्षमता
पोस्ट-ट्रेनिंग के तहत हमने ट्रेनिंग मिक्स में वल्नरेबिलिटी डिस्कवरी डेटा और एनवायरनमेंट्स को शामिल किया। हमारी उम्मीद थी कि इससे मॉडल वल्नरेबिलिटीज़ को खोजने और उनके बारे में रीज़न करने में बेहतर हो जाएगा। लेकिन जो हुआ उसने हमें हैरान कर दिया — यह क्षमता अपने लक्ष्य से कहीं आगे निकल गई।
हमने GLM-5.3 को तीन बेंचमार्क्स पर टेस्ट किया, जो वल्नरेबिलिटी एनालिसिस और एक्सप्लॉइटेशन के अलग-अलग चरणों को कवर करते हैं। CyberGym, जो व्हाइट-बॉक्स सोर्स कोड से शुरू होकर टेस्ट करता है कि मॉडल वल्नरेबिलिटीज़ की पहचान और वैलिडेशन फॉल्ट्स ट्रिगर करके कर पाता है या नहीं — वहां GLM-5.3 ने 84.5% स्कोर किया, जबकि GLM-5.2 के पास 77.2% थे। यह इस बेंचमार्क पर सर्वश्रेष्ठ परिणाम है, Mythos 5 (83.8%) और GPT-5.6 Sol (83.6%) से आगे। ExploitBench, जो वास्तविक वल्नरेबिलिटीज़ और उनके एक्सप्लॉइटेशन के बारे में गहराई से रीज़न करने की मांग करता है, पर GLM-5.3 54.4% तक पहुंचा — GLM-5.2 के 24.4% के मुकाबले यह दोगुने से ज़्यादा है, जबकि Mythos 5 और GPT-5.6 Sol ने क्रमशः 78.0% और 76.5% स्कोर किए। ExploitGym, जो मापता है कि टाइम-नॉर्मलाइज़्ड बजट के तहत एक मॉडल कितने एक्सप्लॉइटेशन टास्क पूरे कर सकता है, पर GLM-5.3 ने दो घंटे में 105 टास्क और छह घंटे में 130 टास्क पूरे किए — GLM-5.2 के लिए ये आंकड़े 29 और 39 थे। Mythos 5 अभी भी काफी आगे है, 181 और 247 टास्क्स के साथ। तीनों बेंचमार्क्स में एक ही पैटर्न दिखता है: एक्सप्लॉइटेशन चेन पर जितना ऊपर जाएंगे, GLM-5.2 से उतना ही बड़ा फायदा मिलेगा — और साथ ही क्लोज़्ड फ्रंटियर से बाकी गैप भी उतना ही चौड़ा होगा। क्षमता सबसे तेज़ी से वहीं बढ़ रही है जहां हम सबसे पीछे हैं।
इसके बाद हमने टेस्ट किया कि क्या ये क्षमताएँ नियंत्रित बेंचमार्क्स से बाहर भी ट्रांसफर होती हैं। GLM-5.2 के बाद से, हम चीन में कई सिक्योरिटी टीम्स के साथ मिलकर अपने मॉडल्स को वास्तविक कोडबेस पर चला रहे हैं। एक्सपर्ट रिव्यू, स्क्रीनिंग और डी-डुप्लिकेशन के बाद, मॉडल ने 269 प्रोजेक्ट्स में 2,436 वल्नरेबिलिटीज़ की पहचान की, जिनमें 1,097 मीडियम-टू-हाई सिवेरिटी के मुद्दे शामिल हैं। ये निष्कर्ष सिस्टम कर्नल्स, ऑपरेटिंग सिस्टम्स, ब्राउज़र इंजन्स, ओपन-सोर्स इंफ्रास्ट्रक्चर, वेब एप्लिकेशन्स और नेटवर्क प्रोटोकॉल्स तक फैले हुए हैं। कई दोष कई वर्षों या उससे भी दशकों से अनदेखे रहे, जिनमें सबसे पुराना लगभग 40 साल पुराना है।
यह काम अब एक जारी डिस्क्लोज़र प्रयास का रूप ले चुका है। हमने Z.ai Security Disclosure Ledger बनाया है, जो डिस्क्लोज़र प्रक्रिया से गुज़रने वाले निष्कर्षों की एक सार्वजनिक रिकॉर्ड रखता है। जैसे-जैसे नई वल्नरेबिलिटीज़ की समीक्षा और डिस्क्लोज़र होती है, लेजर लगातार अपडेट होता रहता है। यह उन मुद्दों को अलग करता है जो पहले ही सार्वजनिक हो चुके हैं, उनसे जो अभी डिस्क्लोज़र के दौरान हैं। डिस्क्लोज़ किए गए मुद्दों के लिए, इसमें प्रभावित प्रोजेक्ट, सिवेरिटी, जहां उपलब्ध हो CVE, और वल्नरेबिलिटी कोडबेस में कितने समय से मौजूद थी — ऐसी जानकारी दर्ज होती है।
slime: लॉन्ग-होराइज़न RL स्केलिंग के लिए बनाया गया
ये सब slime पर चलता है — हमारा ओपन-सोर्स पोस्ट-ट्रेनिंग फ्रेमवर्क, जो RL स्केलिंग के लिए बनाया गया है, ट्रेनिंग साइड पर Megatron और रोलआउट साइड पर SGLang के साथ। इसके डिज़ाइन में ट्रेनिंग, रोलआउट और डेटा बफर एक ही डेटाफ्लो पर रखे गए हैं, ताकि मैथ, कोड, सैंडबॉक्सेस, वेरिफायर्स और लॉन्ग-होराइज़न एजेंटिक एनवायरनमेंट्स डेटा जनरेशन के रूप में प्लग इन हो सकें — ट्रेनिंग लूप में बदलाव के रूप में नहीं। यही वजह है कि GLM-5.2 और GLM-5.3 के दौरान हम बिना हर बार ट्रेनिंग स्टैक फिर से बनाए नए एनवायरनमेंट्स जोड़ते रहे।
GLM-5.3 के दौरान हमने इसे दो मोर्चों पर आगे बढ़ाया। एल्गोरिदमिक पक्ष पर हमने RL रिसर्च पर केंद्रित क्षमताएँ जोड़ीं: top-p mask, top-k और फुल-वोकैबुलरी OPD, और ऐसे कॉन्फ़िगरेशन जो ट्रेनिंग–रोलआउट कंसिस्टेंसी को बेहतर बनाते हैं — जिनमें R3-स्टाइल सेटअप और ट्रेनिंग तथा रोलआउट पाथ के बीच फुल न्यूमेरिकल अलाइनमेंट शामिल हैं। इनसे हमें सैंप्लिंग, ट्रेनिंग और टीचर सिग्नल्स पर बारीक नियंत्रण मिलता है, और कंट्रोल्ड तुलनाएँ तेज़ी से चलाना संभव होता है। हमारे ट्रेनिंग–रोलआउट कंसिस्टेंसी इवैल्यूएशन में, लॉग प्रोबेबिलिटीज़ (logprob) में औसत अंतर 1e-7 स्तर पर नियंत्रित रहा, जो पिछले सेटअप्स के मुकाबले 99.99% से ज़्यादा की कमी दर्शाता है।
साथ ही, हमने लार्ज-स्केल RL के लिए रिसोर्स एफिशिएंसी और सिस्टम थ्रूपुट पर भी काम किया। लोकल स्टोरेज अब एक अतिरिक्त कैशिंग लेयर का काम करता है, जो मॉडल स्टेट्स और डेटा को हायरार्किकली रखता है — जो अन्यथा होस्ट मेमोरी में पड़े रहते। यह मल्टी-टीचर OPD के लिए सबसे ज़्यादा मायने रखता है: ट्रेनिंग साइड पर डायनामिक टीचर स्विचिंग और प्रीफेचिंग के साथ, कई टीचर्स का उपयोग बिना हर एक के लिए अलग से कोई डेडिकेटेड लॉन्ग-रनिंग इंफरेंस सर्विस खड़े किए किया जा सकता है — सीमित अतिरिक्त ओवरहेड और काफी कम रिसोर्स खपत के साथ। एजेंटिक और एसिंक्रोनस वर्कलोड्स के लिए, हमने राउटर और slime के बीच जॉइंट शेड्यूलिंग और लोड बैलेंसिंग को बेहतर बनाया, ताकि विभिन्न लंबाई और कम्प्लीशन टाइम वाले रोलआउट रिक्वेस्ट्स इंफरेंस रिसोर्सेस का बेहतर उपयोग कर सकें। हमने वर्कलोड-अवेयर ह्यूरिस्टिक्स जोड़े जो थ्रूपुट-ओरिएंटेड कॉन्फ़िगरेशन्स — प्रीफिल/डिकोड रिसोर्स रेश्यो, कॉन्करेंसी सेटिंग्स और अन्य थ्रूपुट-क्रिटिकल पैरामीटर्स — को हर रोलआउट एनवायरनमेंट की विशेषताओं से निकालते हैं। नतीजतन, लॉन्ग-होराइज़न कोडिंग RL टास्क्स के लिए इन सिस्टम-लेवल ऑप्टिमाइज़ेशन्स ने एंड-टू-एंड RL ट्रेनिंग थ्रूपुट को 2.3× से ज़्यादा बढ़ा दिया, जिससे हम लंबे ट्रैजेक्टरीज़ और ज़्यादा कॉम्प्लेक्स एनवायरनमेंट्स पर ट्रेनिंग को कहीं अधिक एफिशिएंसी के साथ स्केल कर सके।
संक्षेप में, इन सबने हमें ज़्यादा एक्सपेरिमेंटल फ्लेक्सिबिलिटी, कम रिसोर्स लागत और उच्च थ्रूपुट दिया — और यही वह चीज़ है जो RL को स्केल करना प्रैक्टिकल बनाती है।
GLM-5.3 के साथ शुरुआत करें
GLM-5.3 में API बदलाव
GLM-5.3 तीन थिंकिंग एफ़र्ट लेवल्स सपोर्ट करता है: low, high, और max। थिंकिंग को डिसेबल करना GLM-5.3 में अब सपोर्टेड नहीं है।
| Parameter | Values | Default | Description |
|---|---|---|---|
| thinking.type | enabled | enabled | थिंकिंग को एनेबल करता है। disabled अब सपोर्टेड नहीं है। |
| reasoning_effort | low, high, max | max | low: हल्का; high: एनहांस्ड; max: गहन। कोडिंग टास्क्स के लिए max की सिफारिश की जाती है। |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
माइग्रेशन आवश्यक: यदि आपका एप्लिकेशन वर्तमान में thinking.type: "disabled" उपयोग करता है, तो इसे enabled में बदलें और मॉडल ID को glm-5.3 में अपडेट करने से पहले reasoning_effort को low पर सेट करें। अन्यथा रिक्वेस्ट विफल हो जाएगी।
GLM Coding Plan और ZCode के साथ GLM-5.3 उपयोग करें
GLM-5.3 को अपने पसंदीदा कोडिंग एजेंट्स में आज़माएं — ZCode, Claude Code, OpenCode, और भी बहुत कुछ। devpack overview देखें।
GLM Coding Plan सब्सक्राइबर्स के लिए: हमने GLM-5.3 को सभी GLM Coding Plan यूज़र्स के लिए रोल आउट कर दिया है। नया GLM Coding Plan अब पॉइंट-बेस्ड कोटा सिस्टम उपयोग करता है। पॉइंट यूसेज इनपुट, कैश्ड इनपुट और आउटपुट टोकन्स के लिए अलग-अलग कैलकुलेट किया जाता है। पीक आवर्स के बाहर किए गए मॉडल कॉल्स स्टैंडर्ड पॉइंट्स का 50% खपत करते हैं। पीक आवर्स सोमवार से शुक्रवार 14:00–18:00 (UTC+8) हैं; बाकी सभी घंटे, वीकेंड्स सहित, 50% ऑफ-पीक रेट पाते हैं। अभी बनाना शुरू करें: z.ai/subscribe
ZCode के साथ GLM-5.3 से ज़्यादा पाएं
- 98%+ कैश हिट रेट — रिपीटेड कॉन्टेक्स्ट कम कैश्ड रेट पर बिल्ड होता है, ~30% ज़्यादा एफ़ेक्टिव टोकन्स
- 1.5x लिमिटेड-टाइम कोटा बूस्ट — इसे कैश बचत के साथ जोड़ें और 31 अगस्त तक अपने स्टैंडर्ड कोटे का 180% तक पाएं
- लॉन्ग-होराइज़न महारत — Goal मोड प्लान, कोड, टेस्ट और वेरिफाई करता है जब तक लक्ष्य हासिल न हो
- Remote Control — WeChat या Feishu के ज़रिए अपने फोन से लॉन्ग-रनिंग टास्क्स को मॉनिटर और स्टीयर करें
ZCode आज़माएं: zcode.z.ai
GLM-5.3 को लोकली सर्व करें
GLM-5.3 के मॉडल वेट्स जल्द ही सार्वजनिक रूप से उपलब्ध होंगे, लॉन्च के दो हफ्ते के भीतर।