Claude Haiku 5.5-ն արդեն հասանելի է VEGA-ում
Anthropic-ը Claude Haiku 5.5-ը թողարկեց 2026 թվականի հոկտեմբերի 7-ին։ Այն ընկերության թողարկած ամենաարագ և ամենակարողունակ փոքր մոդելն է, իսկ դրա գործարկման միջին արժեքը Haiku 4.5-ի համեմատ մոտ 75%-ով ցածր է։
Haiku 5.5-ն արդեն աշխատում է VEGA-ի ներսում։ Այն auto, chat, code, web, extreme և memory ռեժիմների լռելյայն մոդելն է։
Ինչի համար է նախատեսված
Haiku 5.5-ը նախատեսված է մեծ ծավալի աշխատանքների համար, որտեղ արժեքն ու արագությունն ավելի կարևոր են, քան խորքային դատողությունը։ Anthropic-ը նշում է ամփոփումները, համատեքստի սեղմումը, տվյալների բազայի հարցումները և դասակարգումը։ Մոդելը հարմար է նաև հաճախորդների սպասարկման ուղիղ կապի և զննարկիչի օգտագործման համար, որտեղ արձագանքման ժամանակն է որոշում արտադրանքի տպավորությունը։
Կոդավորման միջավայրերում այն աշխատում է որպես ենթագործակալ՝ Opus 5.5-ի կամ Sonnet 5.5-ի կողքին։ Anthropic-ը հստակ նշում է, որ բարդ գործակալային կոդավորման համար այն լավագույն ընտրությունը չէ։ Terminal-Bench 4.0-ի նման առաջադրանքներում Sonnet 5.5-ը և Opus 5.5-ը դեռ առաջատար են։
Haiku 5.5-ը նաև Haiku դասի առաջին մոդելն է, որն ունի ջանքերի կարգավորվող մակարդակ։ Յուրաքանչյուր օգտագործման համար կարող եք ընտրել ավելի ցածր արժեքի և ավելի բարձր որակի միջև։
Բենչմարքներ
Աղյուսակում Haiku 5.5-ը համեմատվում է Haiku 4.5-ի, GPT-6 Luna-ի և Sonnet 5.5-ի հետ, որը ներառված է որպես հղման կետ։
| Բենչմարք | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (գիտելիքի վրա հիմնված աշխատանք) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (գիտելիքի վրա հիմնված աշխատանք) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, անցանց ենթաբազմություն (համակարգչի օգտագործում) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam, առանց գործիքների | 45.9% | 10.2% | n/a | 56.9% |
| Humanity's Last Exam, գործիքներով | 57.4% | 18.7% | n/a | 64.5% |
| Terminal-Bench 4.0 (գործակալային կոդավորում) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1, Main (գործակալային կոդավորում) | 46.4% | n/a | 42.4% | 52.1% (Xhigh) |
| Chartography, առանց գործիքների (տեսողական դատողություն) | 46.4% | 6.4% | 29.1% | 61.6% |
Ջանքերի մակարդակի կարգավորումը զգալիորեն փոխում է ցուցանիշները։ OSWorld 2.1-ում Haiku 5.5-ի արդյունքը Low մակարդակում ($0.07) 42.0%-ից բարձրանում է մինչև 72.4%՝ Max-ում ($0.61)։
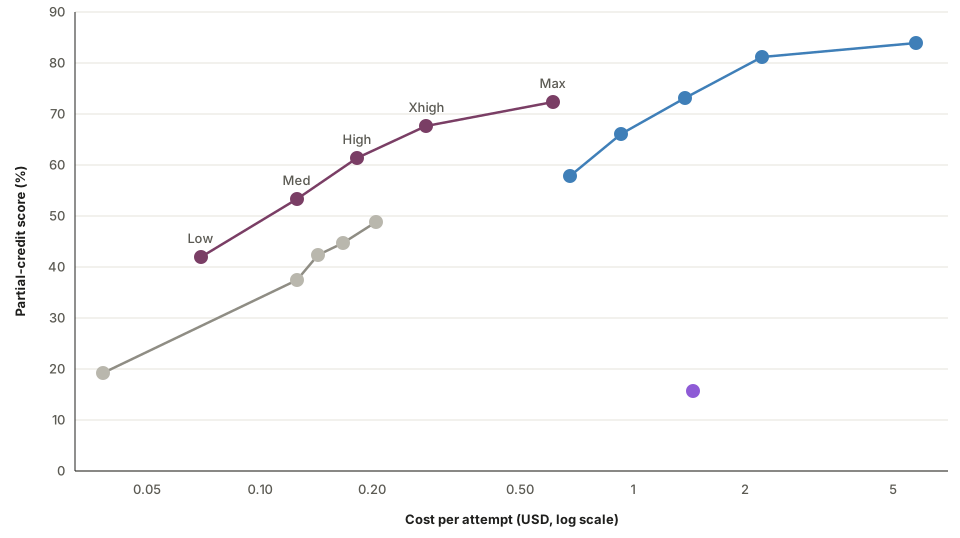
OSWorld 2.1-ը չափում է, թե գործակալները որքան լավ են գործածում իրական համակարգիչը՝ կատարելով երկար, մի քանի քայլից բաղկացած առաջադրանքներ։
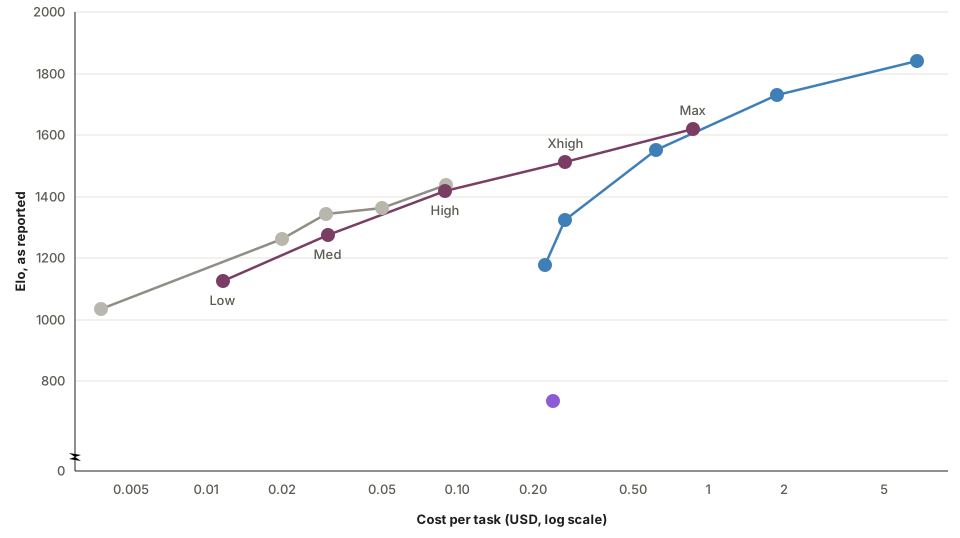
GDPval-AA v2.1-ն իրականացնում է Artificial Analysis-ը։ Այն ստուգում է գործակալներին 44 մասնագիտության իրական աշխատանքային առաջադրանքներում։ Haiku 5.5-ը Max-ում հասնում է 1620-ի՝ Haiku 4.5-ի 735-ի համեմատ։
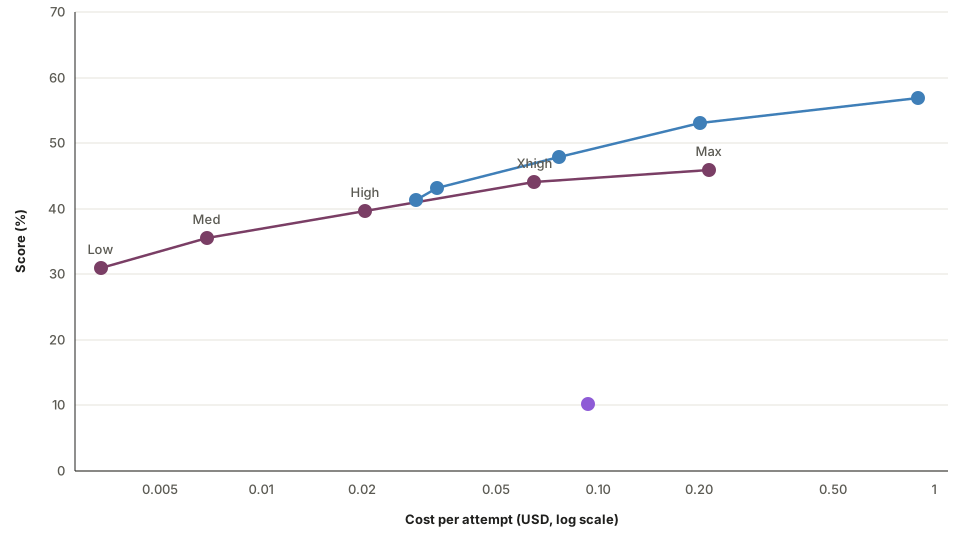
Humanity's Last Exam-ը ստուգում է փորձագիտական մակարդակի ակադեմիական գիտելիքներն ու դատողությունը։ Haiku 5.5-ն առանց գործիքների Max-ում ստանում է 45.9%, մինչդեռ Haiku 4.5-ը՝ 10.2%։
Հաճախորդների նախնական արդյունքները
Anthropic-ը հայտնում է, որ վաղ փորձարկողների արդյունքները համընկնում են վերևում ներկայացված թվերի հետ։
- Asana-ն գործարկեց իր AI Teammates-ի գնահատումը։ Այսօր օգտագործվող մոդելի համեմատ՝ Haiku 5.5-ը առաջադրանքների կատարման ուշացումը կրճատեց ավելի քան 30%-ով և յուրաքանչյուր գործակալի քայլի համար ապահովեց մինչև 2.5 անգամ ավելի արագ ինֆերենս։
- HubSpot-ը այն փորձարկեց CRM պորտալների նմանակված միջավայրերում։ Երեք փորձարկման ընթացքում Haiku 5.5-ի միջին արդյունքը 92.8% էր՝ HubSpot-ի՝ այդ թեստաշարում մինչ այժմ գրանցած լավագույն արդյունքը։ Այն նաև ամենաարագը կատարեց հնացած գրառումների աուդիտի առաջադրանքը՝ փորձարկված մոդելների շարքում ունենալով հայտնաբերման ամենաբարձր ցուցանիշը և կեղծ դրական արդյունքների ամենացածր մակարդակը։
- AlphaSense-ը Ask in Document գործառույթով կատարեց 400 հարցում։ Այս գործառույթը արտադրական միջավայրում շաբաթական մոտ 8 միլիոն հարցում է մշակում։ Haiku 5.5-ը ստացավ 0.84 արդյունք՝ Haiku 4.5-ի 0.76-ի դիմաց, ինչը վիճակագրորեն նշանակալի տարբերություն է։
- Box-ը հայտնել է, որ նախնական փորձարկումներում Haiku 5.5-ը Haiku 4.5-ից 11 միավորով բարձր արդյունք է ստացել՝ մոտ երկու անգամ ավելի ցածր ուշացման պայմաններում։
- Cognition-ը Haiku 5.5-ն ավելացրել է Devin Fusion-ի sidekick մոդելների շարքին։ Երբ առաջատար մոդելը Opus 5.5-ն է, Fusion-ը պահպանում է FrontierCode-ի 66.2 արդյունքը՝ միաժամանակ նվազեցնելով արժեքն ու ուշացումը։
Գներ
Գները ներկայացված են մեկ միլիոն տոկենի հաշվով։ Նախորդ Haiku մոդելին արված հարցումների մոտ 90%-ը մինչև 100,000 տոկեն էր, և հենց այդ հարցումներում է Haiku 5.5-ն ամենամեծ խնայողությունն ապահովում։
| Գին՝ 1 միլիոն տոկենի համար | Haiku 5.5 (մինչև 100k / ավելի քան 100k) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Քեշից ընթերցում | $0.01 / $0.05 | $0.10 | $0.10 |
| Քեշում գրանցում | $0.125 / $0.625 | $1.25 | $2.50 |
| Մուտքային տոկեններ | $0.10 / $0.50 | $1.00 | $2.00 |
| Ելքային տոկեններ | $0.50 / $2.50 | $5.00 | $10.00 |
Մինչև 100,000 տոկեն պարունակող հուշումների համար Haiku 5.5-ի գինը Haiku 4.5-ից 90%-ով ցածր է, իսկ ավելի երկար հուշումների համար՝ 50%-ով։ Միջին խնայողությունը մոտ 75% է։ Այս ցուցանիշը հաշվի է առնում նաև նոր տոկենիզատորը, որը նման է Sonnet 5.5-ում և Opus 5.5-ում օգտագործվողին և յուրաքանչյուր առաջադրանքի համար փոքր-ինչ ավելի շատ տոկեններ է արտադրում։
Գների այլ փոփոխություններ
Anthropic-ը փոխել է նաև իր մյուս մոդելների գները։ Sonnet 5.5-ի քեշից ընթերցման գինն այժմ 50%-ով ավելի էժան է՝ $0.20-ի փոխարեն մեկ միլիոն տոկենի համար $0.10։ Գործակալային աշխատանքների մեծ մասում դա Sonnet 5.5-ի արժեքը նվազեցնում է մոտ 20%-ով։ Ստորև ներկայացված գծապատկերում Terminal-Bench 4.0-ի համար ցուցադրված են քեշի երկու գնային կետերը։

Terminal-Bench 4.0-ը չափում է, թե մոդելը որքան լավ է կատարում բարդ, մի քանի քայլից բաղկացած մասնագիտական առաջադրանքներ հրամանային տողի միջերեսում։ Գծապատկերը նաև ցույց է տալիս, թե ինչու են Haiku 5.5-ն ու ավելի մեծ մոդելները նախատեսված տարբեր աշխատանքի համար։ Sonnet 5.5-ն ու Opus 5.5-ն ավելի լավ են կատարում բարդ գործակալային կոդավորման առաջադրանքներ, իսկ Haiku 5.5-ը հարմար է ավելի նեղ շրջանակի գործերի համար, օրինակ՝ համատեքստի սեղմման, ամփոփման և ենթագործակալի աշխատանքի։
Max և Team բաժանորդները նաև ամեն ամիս API-ի նոր վարկ են ստանում։ Max 5x օգտատերերին տրվում է ամսական $100, Max 20x օգտատերերին՝ $200, իսկ Team բաժանորդներին՝ մինչև $500, որը համատեղ օգտագործվում է նրանց օգտատերերի միջև։ Վարկերը հասանելի կդառնան այս շաբաթ և կաշխատեն Claude Platform-ի ցանկացած մոդելի հետ։
Python-ի և TypeScript-ի Claude SDK-ներն այժմ բետա տարբերակով աջակցում են համակարգչի և զննարկիչի օգտագործմանը։ Anthropic-ի խոսքով՝ Haiku 5.5-ը հարմար է այս առաջադրանքների համար՝ իր արագության, կարողությունների և գնի շնորհիվ։
Անվտանգություն
Haiku 5.5-ը համապատասխանեցման գրեթե բոլոր գնահատումներում բարելավվել է Haiku 4.5-ի համեմատ։ Մոդելն անհամապատասխան վարքագիծ շատ ավելի հազվադեպ է ցուցաբերում և ավելի քիչ է հակված աջակցելու չարաշահմանը։
Կիբերանվտանգության պաշտպանության միջոցները Haiku 4.5-ի միջոցներից ավելի խիստ են, բայց Sonnet 5.5-ի միջոցներից՝ ավելի թույլ։ Դրանք թույլ են տալիս ավելի շատ պաշտպանական աշխատանք կատարել, սակայն շարունակում են արգելափակել ներթափանցման թեստավորումն ու այլ մեթոդներ, որոնք հավանաբար կկիրառեն հարձակվողները։ Կենսաբանության ոլորտում դրա պաշտպանական միջոցները համապատասխանում են Sonnet 5-ին, Sonnet 5.5-ին և Opus 5-ին։ Թույլատրվում են կենսաբանության վերաբերյալ հետազոտական հարցերը, իսկ վնաս պատճառելու հավանականություն ունեցող գնահատված հարցումները սահմանափակվում են։ Կենսաբանության կամ կիբերանվտանգության ոլորտում ավելի լայն կարիքներ ունեցող կազմակերպությունները կարող են դիմել Anthropic-ի Life Sciences Verification Program-ին և Cyber Verification Program-ին։
Հասանելիություն
Haiku 5.5-ն արդեն հասանելի է ամպային բոլոր խոշոր հարթակներում, այդ թվում՝ Amazon Web Services-ում, Google Cloud-ում և Microsoft Azure-ում։ Claude Platform-ում մոդելի ID-ն claude-haiku-5-5 է։
Փորձեք այն VEGA-ում
Haiku 5.5-ը VEGA-ի auto, chat, code, web, extreme և memory ռեժիմների լռելյայն մոդելն է։ Այն հարմար է արագ պատասխանների, ամփոփումների և որոնումների համար, որտեղ արագությունն ամենակարևորն է։
Ամենաբարդ, բաց բնույթի աշխատանքների համար Opus 5.5-ը և Sonnet 5.5-ը շարունակում են մնալ ավելի լավ ընտրությունը, ինչպես նշում է նաև Anthropic-ը։
Կարդացեք Anthropic-ի սկզբնական հայտարարությունը՝ anthropic.com/claude-haiku-5-5։