Claude Haiku 5.5 უკვე ხელმისაწვდომია VEGA-ზე
Anthropic-მა Claude Haiku 5.5 2026 წლის 7 ოქტომბერს გამოუშვა. ეს კომპანიის მიერ გამოშვებული ყველაზე სწრაფი და შესაძლებლობებით გამორჩეული მცირე მოდელია, რომლის გამოყენებაც საშუალოდ Haiku 4.5-ზე დაახლოებით 75%-ით იაფია.
Haiku 5.5 უკვე მუშაობს VEGA-ში. ის auto, chat, code, web, extreme და memory რეჟიმების ნაგულისხმევი მოდელია.
რისთვის არის შექმნილი
Haiku 5.5 გათვლილია დიდი მოცულობის სამუშაოზე, სადაც ღრმა მსჯელობაზე მნიშვნელოვანი ფასი და სისწრაფეა. Anthropic მის გამოყენების სფეროებად ასახელებს შეჯამებას, კონტექსტის შემჭიდროებას, მონაცემთა ბაზის მოთხოვნებსა და კლასიფიკაციას. მოდელი ასევე გამოდგება მომხმარებელთა მხარდაჭერის პირდაპირი მომსახურებისა და ბრაუზერში მუშაობისთვის, სადაც პასუხის სისწრაფე განსაზღვრავს პროდუქტის აღქმას.
კოდის წერის გარემოში ის Opus 5.5-თან ან Sonnet 5.5-თან ერთად ქვეაგენტად მუშაობს. Anthropic პირდაპირ აღნიშნავს, რომ რთული აგენტური კოდის წერისთვის ის საუკეთესო არჩევანი არ არის. Terminal-Bench 4.0-ის მსგავსი ამოცანების შესრულებაში Sonnet 5.5 და Opus 5.5 კვლავ ლიდერობენ.
Haiku 5.5 ასევე პირველი Haiku-კლასის მოდელია, რომელსაც ძალისხმევის რეგულირებადი პარამეტრი აქვს. თითოეული გამოყენებისთვის შეგიძლიათ აირჩიოთ დაბალი ფასი ან უფრო მაღალი ხარისხი.
ბენჩმარკები
ცხრილში Haiku 5.5 შედარებულია Haiku 4.5-თან, GPT-6 Luna-სთან და Sonnet 5.5-თან, რომელიც საცნობარო მაჩვენებლადაა ჩართული.
| ბენჩმარკი | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (ცოდნაზე დაფუძნებული სამუშაო) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (ცოდნაზე დაფუძნებული სამუშაო) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, ოფლაინ ქვესიმრავლე (კომპიუტერის გამოყენება) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam, ხელსაწყოების გარეშე | 45.9% | 10.2% | n/a | 56.9% |
| Humanity's Last Exam, ხელსაწყოებით | 57.4% | 18.7% | n/a | 64.5% |
| Terminal-Bench 4.0 (აგენტური კოდის წერა) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1, Main (აგენტური კოდის წერა) | 46.4% | n/a | 42.4% | 52.1% (Xhigh) |
| Chartography, ხელსაწყოების გარეშე (ვიზუალური მსჯელობა) | 46.4% | 6.4% | 29.1% | 61.6% |
ძალისხმევის პარამეტრი მაჩვენებლებს მნიშვნელოვნად ცვლის. OSWorld 2.1-ზე Haiku 5.5-ის შედეგი Low პარამეტრზე 42.0%-ია ($0.07), Max-ზე კი 72.4%-ს აღწევს ($0.61).
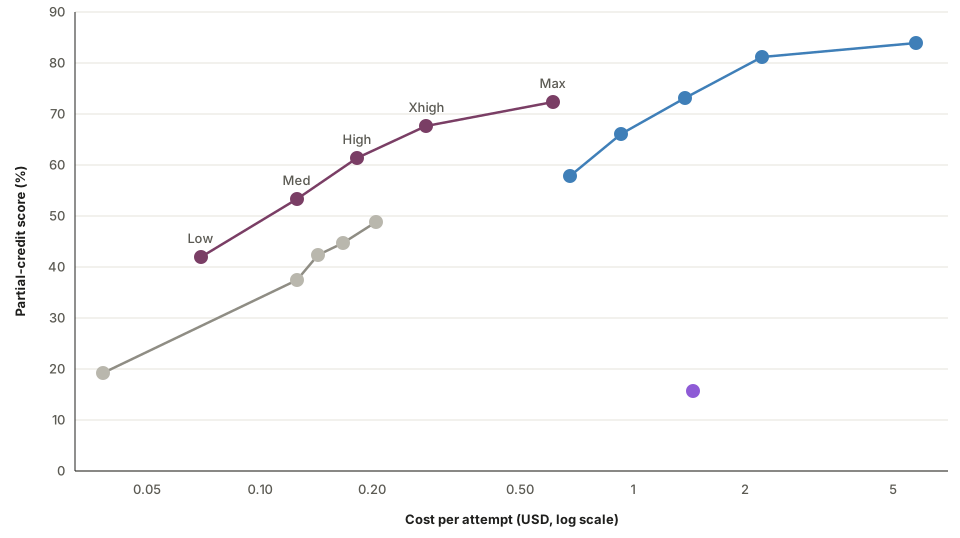
OSWorld 2.1 აფასებს, რამდენად კარგად მართავენ აგენტები რეალურ კომპიუტერს ხანგრძლივი, მრავალსაფეხურიანი ამოცანების შესრულებისას.
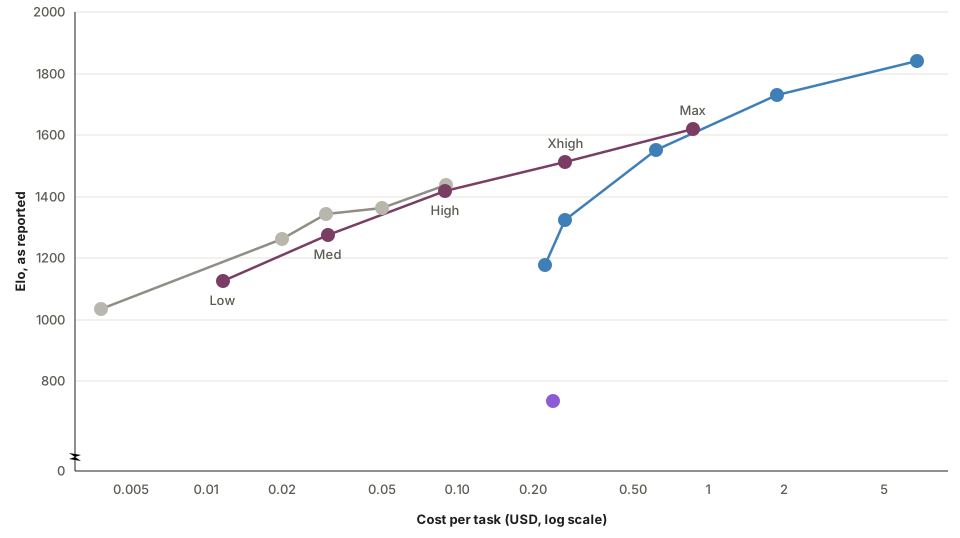
GDPval-AA v2.1-ს Artificial Analysis ატარებს. ის აგენტებს 44 პროფესიულ სფეროში რეალურ სამუშაო ამოცანებზე ამოწმებს. Max პარამეტრზე Haiku 5.5 1620 ქულას აღწევს, მაშინ როცა Haiku 4.5-ის შედეგი 735-ია.
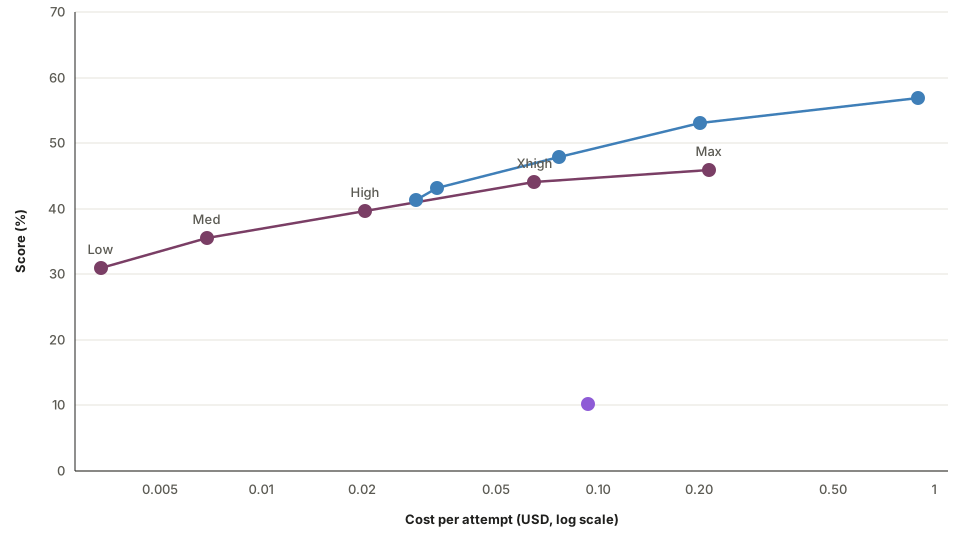
Humanity's Last Exam ექსპერტულ დონეზე აკადემიურ ცოდნასა და მსჯელობას ამოწმებს. Max პარამეტრზე, ხელსაწყოების გარეშე, Haiku 5.5-ის შედეგია 45.9%, Haiku 4.5-ისა კი — 10.2%.
მომხმარებლების ადრეული შედეგები
Anthropic-ის თქმით, ადრეულმა შემმოწმებლებმა ზემოთ მოცემულ მაჩვენებლებთან შესაბამისი შედეგები მიიღეს.
- Asana-მ თავისი AI Teammates-ის შეფასება ჩაატარა. ამჟამად გამოყენებულ მოდელთან შედარებით, Haiku 5.5-მა ამოცანის შესრულების დაყოვნება 30%-ზე მეტით შეამცირა და აგენტის თითოეულ სვლაზე ინფერენსი 2.5-ჯერ უფრო სწრაფად შეასრულა.
- HubSpot-მა ის CRM-ის სიმულირებულ პორტალებზე გამოსცადა. სამი გაშვების საშუალო შედეგი Haiku 5.5-ისთვის 92.8% იყო — ამ ნაკრებში HubSpot-ის მიერ დღემდე დაფიქსირებული საუკეთესო მაჩვენებელი. მან ასევე ყველაზე სწრაფად დაასრულა მოძველებული ჩანაწერების აუდიტის ამოცანა და ტესტირებულ მოდელებს შორის მიიღო ყველაზე მაღალი სწორი აღმოჩენისა და ყველაზე დაბალი ცრუ დადებითი შედეგების მაჩვენებლები.
- AlphaSense-მა Ask in Document-ის ფუნქციაში 400 მოთხოვნა გაუშვა. ეს ფუნქცია წარმოებაში კვირაში დაახლოებით 8 მილიონ მოთხოვნას ამუშავებს. Haiku 5.5-მა 0.84 ქულა მიიღო, Haiku 4.5-მა კი — 0.76; სხვაობა სტატისტიკურად მნიშვნელოვანია.
- Box-მა განაცხადა, რომ ადრეული ტესტირებისას Haiku 5.5-მა Haiku 4.5-ზე 11 ქულით მეტი მიიღო, დაახლოებით ნახევარი დაყოვნების პირობებში.
- Cognition-მა Haiku 5.5 Devin Fusion-ის sidekick მოდელების ნაკრებს დაამატა. Opus 5.5-თან ერთად, რომელიც წამყვან მოდელად მუშაობს, Fusion ინარჩუნებს FrontierCode-ის 66.2 ქულას და ამავდროულად ამცირებს ღირებულებასა და დაყოვნებას.
ფასი
ფასი მილიონ ტოკენზეა განსაზღვრული. წინა Haiku მოდელზე მოთხოვნების დაახლოებით 90% 100,000-მდე ტოკენს მოიცავდა — სწორედ ამ ფარგლებში Haiku 5.5 ყველაზე მეტ დანაზოგს იძლევა.
| ფასი 1 მილიონ ტოკენზე | Haiku 5.5 (100k-მდე / 100k-ზე მეტი) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| ქეშიდან წაკითხვა | $0.01 / $0.05 | $0.10 | $0.10 |
| ქეშში ჩაწერა | $0.125 / $0.625 | $1.25 | $2.50 |
| შეყვანის ტოკენები | $0.10 / $0.50 | $1.00 | $2.00 |
| გამოტანის ტოკენები | $0.50 / $2.50 | $5.00 | $10.00 |
100,000-მდე ტოკენის მქონე მოთხოვნებისთვის Haiku 5.5-ის ფასი Haiku 4.5-ზე 90%-ით დაბალია, ხოლო უფრო გრძელი მოთხოვნებისთვის — 50%-ით. საშუალო დანაზოგი დაახლოებით 75%-ია. ეს მაჩვენებელი ახალ ტოკენიზატორსაც ითვალისწინებს, რომელიც Sonnet 5.5-სა და Opus 5.5-ში გამოყენებულის მსგავსია და თითო ამოცანაზე ოდნავ მეტ ტოკენს წარმოქმნის.
ფასის სხვა ცვლილებები
Anthropic-მა სხვა მოდელების ფასებიც შეცვალა. Sonnet 5.5-ისთვის ქეშიდან წაკითხვის ფასი ახლა 50%-ით იაფია: მილიონ ტოკენზე $0.10, წინა $0.20-ის ნაცვლად. აგენტური სამუშაოების უმეტესობაზე ეს Sonnet 5.5-ის ღირებულებას დაახლოებით 20%-ით ამცირებს. ქვემოთ მოცემულ დიაგრამაში Terminal-Bench 4.0-ზე ქეშის ორივე ფასია ნაჩვენები.

Terminal-Bench 4.0 ზომავს, რამდენად კარგად ასრულებს მოდელი რთულ, მრავალსაფეხურიან პროფესიულ ამოცანებს ბრძანების სტრიქონის ინტერფეისში. დიაგრამა ასევე აჩვენებს, რატომ ასრულებენ Haiku 5.5 და უფრო დიდი მოდელები განსხვავებულ სამუშაოებს. Sonnet 5.5 და Opus 5.5 რთულ აგენტურ კოდის წერაში უკეთეს შედეგებს აჩვენებენ, Haiku 5.5 კი უფრო ვიწრო ამოცანებისთვისაა შესაფერისი — მაგალითად, კონტექსტის შემჭიდროებისთვის, შეჯამებისა და ქვეაგენტად მუშაობისთვის.
Max და Team-ის აბონენტები ასევე მიიღებენ API-ის ახალ ყოველთვიურ კრედიტს. Max 5x-ის მომხმარებლებს თვეში $100 ეკუთვნით, Max 20x-ის მომხმარებლებს — $200, ხოლო Team-ის აბონენტებს — მაქსიმუმ $500, რომელიც მათ მომხმარებლებს შორის ნაწილდება. კრედიტების გაცემა ამ კვირაში დაიწყება და მათი გამოყენება Claude Platform-ის ნებისმიერ მოდელთან იქნება შესაძლებელი.
Python-ისა და TypeScript-ის Claude SDK-ებს ახლა ბეტა რეჟიმში კომპიუტერისა და ბრაუზერის გამოყენების მხარდაჭერა აქვთ. Anthropic-ის თქმით, Haiku 5.5 ამ ამოცანებისთვის შესაფერისია თავისი სისწრაფის, შესაძლებლობებისა და ფასის გამო.
უსაფრთხოება
Haiku 5.5 თითქმის ყველა შესაბამისობის შეფასებაში Haiku 4.5-ს სჯობს. მოდელი გაცილებით იშვიათად ავლენს შეუსაბამო ქცევას და ბოროტად გამოყენებაში დახმარების სურვილიც ნაკლები აქვს.
მისი კიბერუსაფრთხოების დაცვის მექანიზმები Haiku 4.5-ისაზე მკაცრია, თუმცა Sonnet 5.5-ისაზე — ნაკლებად მკაცრი. ისინი მეტ თავდაცვით სამუშაოს უშვებს, თუმცა კვლავ ბლოკავს შეღწევადობის ტესტირებასა და სხვა მეთოდებს, რომელთა გამოყენებაც თავდამსხმელებს სავარაუდოდ შეეძლებათ. ბიოლოგიის სფეროში მისი დაცვის მექანიზმები Sonnet 5-ის, Sonnet 5.5-ისა და Opus 5-ის მსგავსია. ბიოლოგიის კვლევასთან დაკავშირებულ კითხვებზე პასუხის გაცემა დაშვებულია, ხოლო ზიანის მიყენების ალბათობის მქონე მოთხოვნები იზღუდება. ორგანიზაციებს, რომლებსაც ბიოლოგიისა თუ კიბერუსაფრთხოების სფეროში უფრო ფართო შესაძლებლობები სჭირდებათ, შეუძლიათ განაცხადი შეიტანონ Anthropic-ის Life Sciences Verification Program-სა და Cyber Verification Program-ში.
ხელმისაწვდომობა
Haiku 5.5 უკვე ხელმისაწვდომია ღრუბლოვან პლატფორმებზე, მათ შორის Amazon Web Services-ზე, Google Cloud-სა და Microsoft Azure-ზე. Claude Platform-ზე მოდელის ID-ია claude-haiku-5-5.
სცადეთ VEGA-ზე
Haiku 5.5 VEGA-ს auto, chat, code, web, extreme და memory რეჟიმების ნაგულისხმევი მოდელია. ის შესაფერისია სწრაფი პასუხების, შეჯამებისა და ინფორმაციის მოძიებისთვის — ამ ამოცანებში კი სისწრაფეს გადამწყვეტი მნიშვნელობა აქვს.
ყველაზე რთული, ღიად განსაზღვრული ამოცანებისთვის Opus 5.5 და Sonnet 5.5 კვლავ უკეთეს არჩევანად რჩება, რასაც Anthropic-იც აღნიშნავს.
Anthropic-ის თავდაპირველი განცხადება წაიკითხეთ აქ: anthropic.com/claude-haiku-5-5.