DeepSeek V4.1 Flash: ევოლუცია თუ რევოლუცია?
DeepSeek-მა V4.1-Flash 2026 წლის 10 სექტემბერს გამოუშვა. ეს არის 552B პარამეტრის მქონე მულტიმოდალური Mixture-of-Experts მოდელი, რომელსაც 1M-ტოკენიანი კონტექსტის ფანჯარა აქვს. DeepSeek-ის საკუთარი ბენჩმარკების მიხედვით, რამდენიმე აგენტურ ამოცანაში ის Opus-5.0-ს უტოლდება ან აღემატება. ამასთან, იაფიცაა: არაპიკის საათებში შეყვანა მილიონ ტოკენზე $0.15 ღირს, ხოლო გამოტანა — $0.60. ეს DeepSeek V4-Pro-ზე შეყვანისას დაახლოებით 4-ჯერ, ხოლო გამოტანისას 3-ჯერ იაფია.
მოდელი უკვე ხელმისაწვდომია vega.chat-ზე და api.vega.chat API-ის მეშვეობით.
არქიტექტურა
DeepSeek-V4.1-Flash იყენებს Causal Encoder-Decoder (CED) არქიტექტურას: 40-შრიან Transformer-ს, რომელიც 20-შრიან კაუზალურ ენკოდერად და 20-შრიან დეკოდერად იყოფა. დეკოდერის KV ქეში პროექტირდება ენკოდერის საბოლოო დამალული მდგომარეობებიდან და არა დეკოდერის თითოეული შრის საკუთარი დამალული მდგომარეობებიდან. ამის წყალობით, პრეფილინგის დროს მოდელი თითო ტოკენზე მხოლოდ 8B პარამეტრს ააქტიურებს, ხოლო დეკოდირებისას — 16B-ს.
MoE შრეს აქვს 1 გაზიარებული ექსპერტი და 384 მარშრუტიზებული ექსპერტი; თითო ტოკენზე აქტიურდება 6 მარშრუტიზებული ექსპერტი. მოდელი სურათებსა და ტექსტს ბუნებრივად ამუშავებს ხედვის ენკოდერის (DeepSeek-ViT, რომელიც ნულიდან 2D-RoPE-ით გაწვრთნეს) და ორშრიანი MLP პროექტორის მეშვეობით.
DeepSeek-მა მოდელი ნულიდან, 45T-ტოკენიან მულტიმოდალურ კორპუსზე გაწვრთნა. 64K მიმდევრობის სიგრძეზე გამოიყენეს მწირი ყურადღების მექანიზმი, ხოლო კონტექსტი 1M ტოკენამდე 34T ტოკენზე გააფართოეს. შემდგომი სწავლების პროცესი მიჰყვება SFT, RL და on-policy დისტილაციის ეტაპებს, ალგორითმული ცვლილებების გარეშე. მთავარი სამუშაო მონაცემთა დამუშავების პროცესს დაეთმო: აგენტური ამოცანებისა და გარემოების ფართომასშტაბიან ავტომატურ სინთეზს, მონაცემების, ამოცანებისა და rollout-ების თანდათანობითი მასშტაბირებით.
წარმადობა: Opus-ის დონის შედეგები Flash-ის ფასად
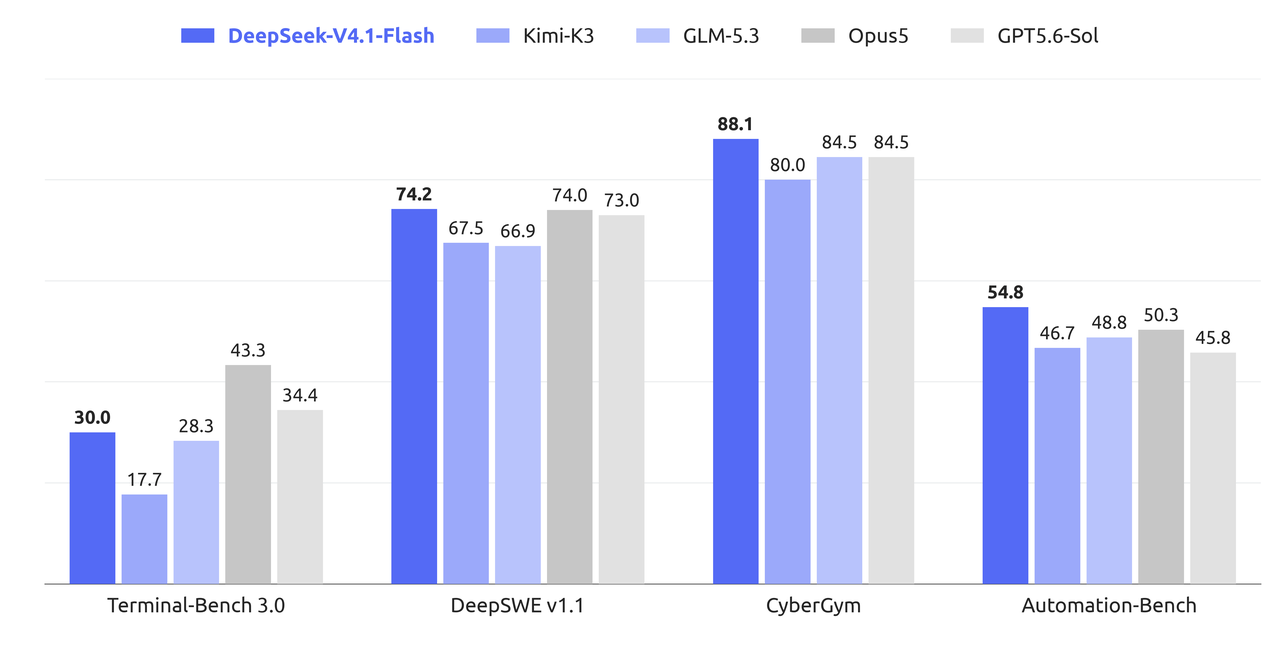
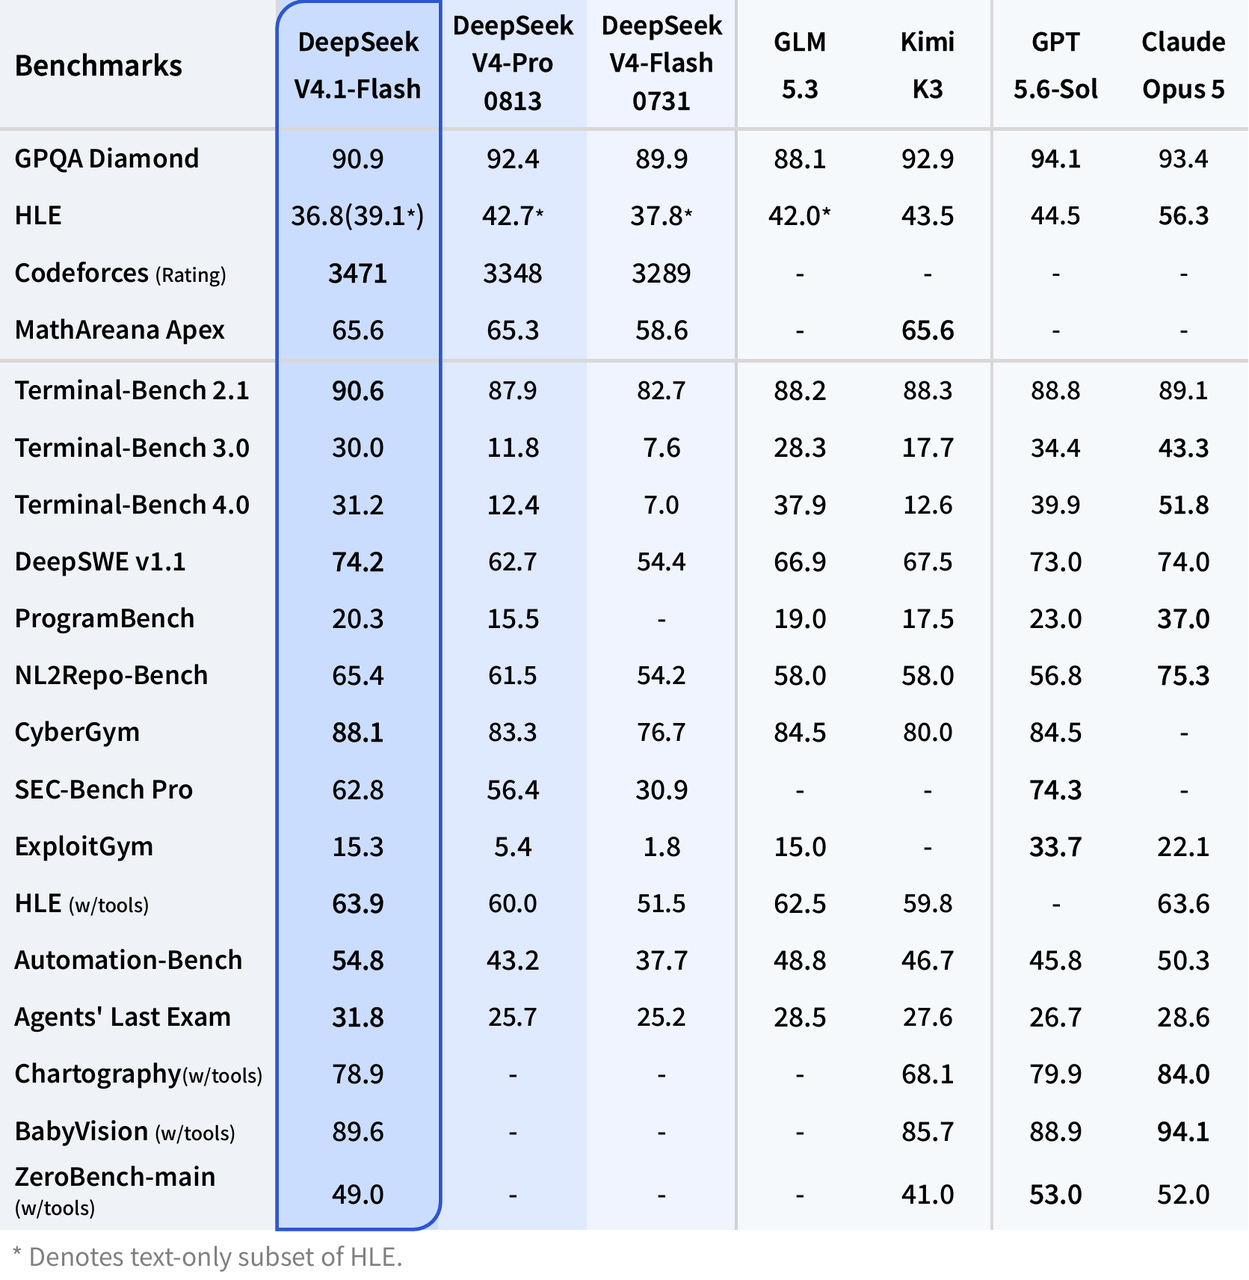
DeepSeek-ის საკუთარი ბენჩმარკების მიხედვით, V4.1-Flash Opus-5.0-ის დონეზეა და რამდენიმე აგენტურ ამოცანაში მასზე უკეთეს შედეგებს აჩვენებს. Terminal-Bench 2.1-ზე V4.1-Flash 90.6 ქულას იღებს და Opus-5.0-ის 89.1 ქულას აჭარბებს. DeepSWE v1.1-ზე ის 74.2 ქულას იღებს, Opus-ის 74.0 ქულასთან შედარებით. Agent's Last Exam-ზე მისი შედეგია 31.8 — საუკეთესო ყველა შედარებულ მოდელს შორის, მათ შორის Opus, GPT-5.6 Sol, K3, GLM-5.3 და V4-Pro. Codeforces-ზე ის 3471 რეიტინგს აღწევს, რაც შედარებაში ასევე ყველაზე მაღალი შედეგია. AutomationBench-ზე მისი ქულაა 54.8 — კვლავ საუკეთესო.
ბენჩმარკების სრული ცხრილი შვიდი მოდელის შედეგებს აჩვენებს მსჯელობის, აგენტურ და ვიზუალურ ამოცანებში. V4.1-Flash პირველ ადგილს იკავებს Terminal-Bench 2.1-ზე, DeepSWE v1.1-ზე, Codeforces-ზე, CyberGym-ზე, HLE with tools-ზე, AutomationBench-სა და Agent's Last Exam-ზე.
DeepSeek აღნიშნავს, რომ რამდენიმე მხარის მიერ ჩატარებულ ტესტებში V4.1-Flash V4-Pro-ს წარმადობით, ღირებულებით, სიჩქარითა და მუშაობის საერთო დროით უსწრებს. კომპანია V4-Pro-ს ეტაპობრივად აუქმებს. 2026 წლის 14 სექტემბრიდან ყველა deepseek-v4-pro API მოთხოვნა V4.1-Flash-ზე გადამისამართდება და V4.1-Flash-ის ტარიფებით დაირიცხება, სანამ V4.1-Pro გამოვა.
KV ქეში: 4-ჯერ უფრო მცირე
მოდელი იყენებს Compressed Sparse Attention 2 (CSA2)-ს, რომელიც ყურადღების თითოეულ შრეს სამიდან ერთ სტატიკურ რეჟიმს ანიჭებს: Full, Reindex ან Reuse. ეს შრეებს შორის ძირითად KV-სა და ინდექსატორის K-ს აზიარებს და ხელახლა იყენებს Top-K მწირი ყურადღების ინდექსებს. FP4 ძირითადი KV ქეშირებასთან ერთად (E2M1 ფორმატი, ერთი E4M3 მასშტაბი ყოველ 16 არხზე) გლობალური KV ქეშის მოცულობა ტოკენზე 890 ბაიტამდე მცირდება. ეს DeepSeek V4-Flash-ის დაახლოებით 1/4-ს, ხოლო DeepSeek V1-ის 1/437-ს შეადგენს.
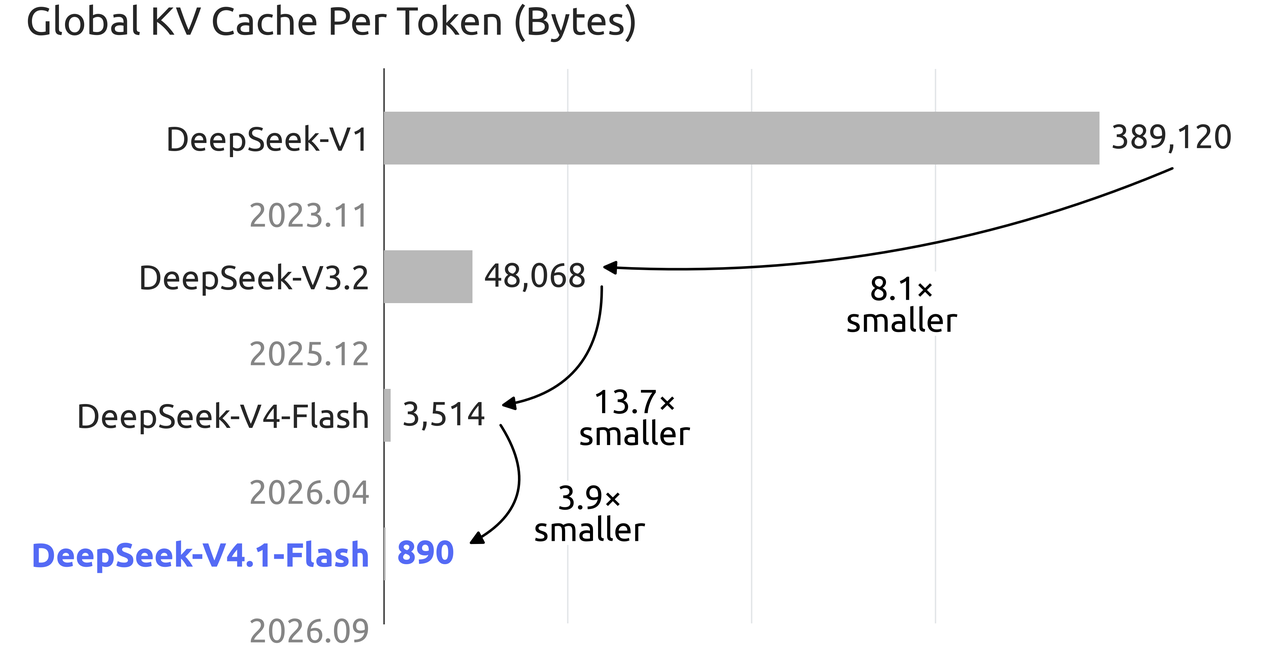
ქეშის დარტყმებზე დაწესებული გადასახადი ხშირად აგენტების ხარჯების დიდ ნაწილს შეადგენს. ქეშის შეკუმშვა ამ ხარჯებს პირდაპირ ამცირებს. წინა თაობასთან შედარებით, V4.1-Flash-ს KV ქეშისთვის 4-ჯერ ნაკლები HBM და 8-ჯერ ნაკლები SSD საცავი სჭირდება.
ფასები
V4.1-Flash პიკისა და არაპიკის ტარიფებს იყენებს. არაპიკის ტარიფები პიკის ტარიფების 50%-ია. ახალი ფასები ძალაში 2026 წლის 10 სექტემბერს, 04:00 UTC-ზე შევიდა.
| ტოკენის ტიპი | არაპიკის საათებში (1M-ზე) | პიკის საათებში (1M-ზე) |
|---|---|---|
| შეყვანა (ქეშის დარტყმა) | $0.003 | $0.006 |
| შეყვანა (ქეშის აცდენა) | $0.15 | $0.30 |
| გამოტანა | $0.60 | $1.20 |
შედარებისთვის, V4-Pro მილიონ შეყვანის ტოკენზე $0.66-ს (არაპიკის საათებში, ქეშის აცდენისას) და მილიონ გამოტანის ტოკენზე $1.98-ს (არაპიკის საათებში) იღებს. V4.1-Flash შეყვანისას დაახლოებით 4-ჯერ, ხოლო გამოტანისას 3-ჯერ იაფია და ბენჩმარკებში V4-Pro-ს უტოლდება ან აჭარბებს.

ყოველდღიური ამოცანები, აგენტები და vibe-coding
V4.1-Flash შექმნილია შეყვანაზე ორიენტირებული აგენტური დატვირთვებისთვის. პრეფილინგის დროს აქტიური 8B პარამეტრი გრძელი კონტექსტების დამუშავებას იაფს ხდის — სწორედ აქ გროვდება აგენტების ხარჯები. 1M-ტოკენიანი კონტექსტის ფანჯარა და მულტიმოდალური მხარდაჭერა (ტექსტი და სურათები) საშუალებას აძლევს, დიდი დოკუმენტები, კოდური ბაზები და ვიზუალური შეყვანა ერთ გავლაზე წაიკითხოს.
მოდელს აქვს მსჯელობის ინტენსივობის უწყვეტად რეგულირებადი პარამეტრი (მთელი რიცხვი 1-დან 100-მდე), რომელიც ინფერენსის ხარჯსა და სიზუსტეს შორის ბალანსს ცვლის. ინტენსივობის დაბალი დონე მარტივი შეკითხვებისთვის ტოკენების ზედმეტ ხარჯს ამცირებს. მაღალი დონე კი რთული პრობლემებისთვის მსჯელობის დამატებით ნაბიჯებს ამატებს. ეს მოდელს გამოსადეგს ხდის ყოველდღიური ჩატისა და სწრაფი შეკითხვებისთვისაც და არა მხოლოდ ხანგრძლივი აგენტური ციკლებისთვის.
აგენტურ ბენჩმარკებში მოდელი საუკეთესო შედეგებს აჩვენებს: Terminal-Bench 2.1 (90.6), DeepSWE v1.1 (74.2), Agent's Last Exam (31.8) და AutomationBench (54.8). მას აქვს ინსტრუმენტების გამოძახების, JSON ფორმატში პასუხის გაცემისა და Responses API-ის მხარდაჭერა. DeepSeek-ის ოფიციალური პარტნიორები WorkBuddy (მათ შორის CodeBuddy) და OpenCode ახლა სრულად უჭერენ მხარს V4.1-Flash-ს.
Vibe-coding-ისთვის Codeforces-ის 3471 რეიტინგი და DeepSWE v1.1-ზე მიღებული 74.2 ქულა V4.1-Flash-ს შედარებაში პირველ ადგილზე აყენებს, Opus-5.0-სა და GPT-5.6 Sol-ზე წინ. დაბალ ფასსა და 1M-ტოკენიან კონტექსტთან ერთად, ეს მას კოდირების აგენტებისთვის კარგ ნაგულისხმევ მოდელად აქცევს, განსაკუთრებით ხანგრძლივი სესიებისა და დიდი კონტექსტის დაგროვებისას.
სცადეთ DeepSeek V4.1-Flash vega.chat-ზე
DeepSeek V4.1-Flash უკვე ხელმისაწვდომია vega.chat-ზე და api.vega.chat API-ის მეშვეობით. შეგიძლიათ გამოსცადოთ ის ჩატის ინტერფეისში, სხვა მოდელების პასუხებს შეადაროთ ან api.vega.chat-ზე არსებული OpenRouter-თან თავსებადი API-ის მეშვეობით თქვენს აპლიკაციებში ჩააშენოთ.