GLM-5.3: კოდირებისა და კიბერუნარების ნახტომი
GLM-5.3-ისთვის მხოლოდ პოსტტრენინგის მასშტაბირება გავაკეთეთ. GLM-5.2-თან ერთად საფუძველი შევქმენით: IndexShare ხანგრძლივი კონტექსტის ეფექტიანი დამუშავებისთვის, SAO ხანგრძლივი ჰორიზონტის ამოცანებზე RL-ისთვის და slime მასშტაბური ასინქრონული ტრენინგისთვის — ეს ყველაფერი ხანგრძლივი ჰორიზონტის ამოცანების იმ გარემოებში მუშაობს, რომლებსაც თანდათან ვაგროვებთ. გასული თვის განმავლობაში ამ ტექნოლოგიურ ბაზაზე მასშტაბირებას ვაგრძელებდით: ვამატებდით გარემოებს, უფრო მრავალფეროვან ამოცანებს და მათზე ტრენინგისთვის მეტ გამოთვლით რესურსს ვხარჯავდით.
დღეს GLM-5.3-ს ვუშვებთ. ის GLM-5.2-ის იმავე საბაზო მოდელს იყენებს — ყველა გაუმჯობესება პოსტტრენინგის შედეგია. GLM-5.2-თან შედარებით, ის გაცილებით უკეთ უმკლავდება რთულ კოდირებასა და ხანგრძლივი ჰორიზონტის ამოცანებს:
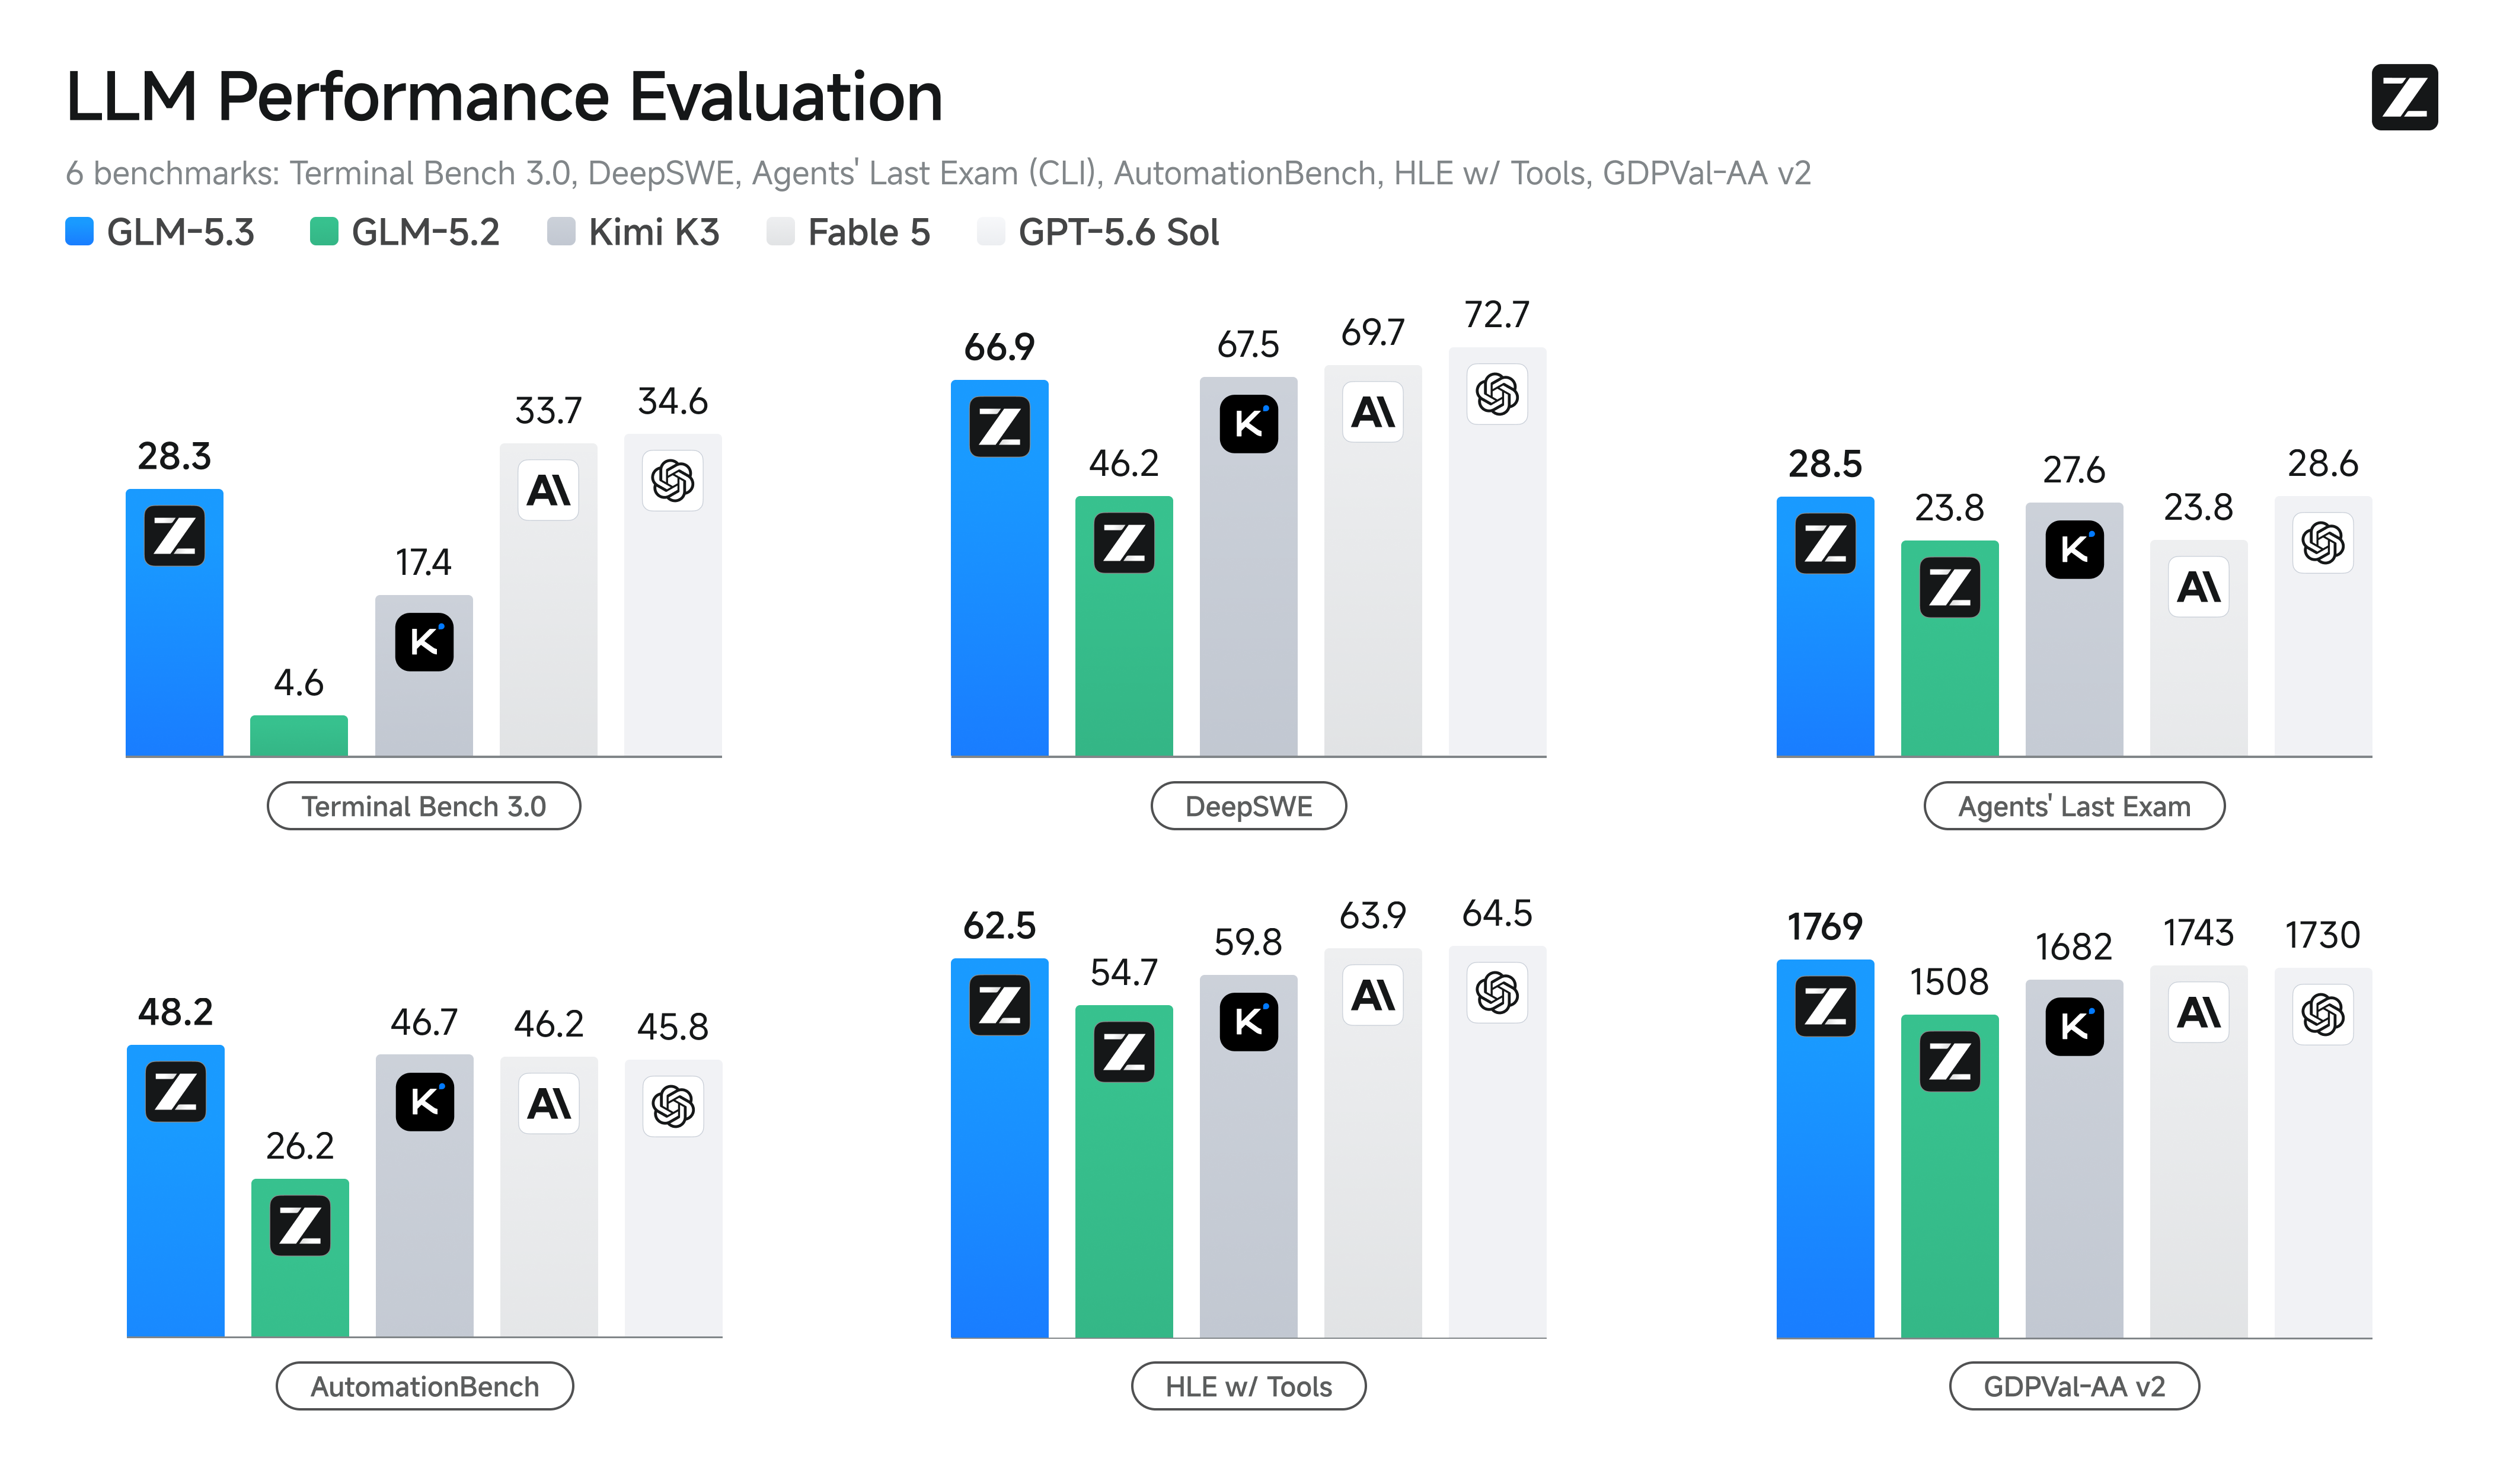
- უკეთესი კოდირება: GLM-5.3 კოდირებისთვის ყველაზე უნარიანი ღია წონების მქონე მოდელია; ჩვენს შიდა Z.ai Code Bench-ზე მისი შედეგი GLM-5.2-ისაზე 50%-ით უკეთესია. ღია კოდის მოდელებს შორის ის SOTA შედეგს აჩვენებს საჯარო ბენჩმარკებშიც, მათ შორის Terminal Bench 3.0-სა და Agents' Last Exam-ში.
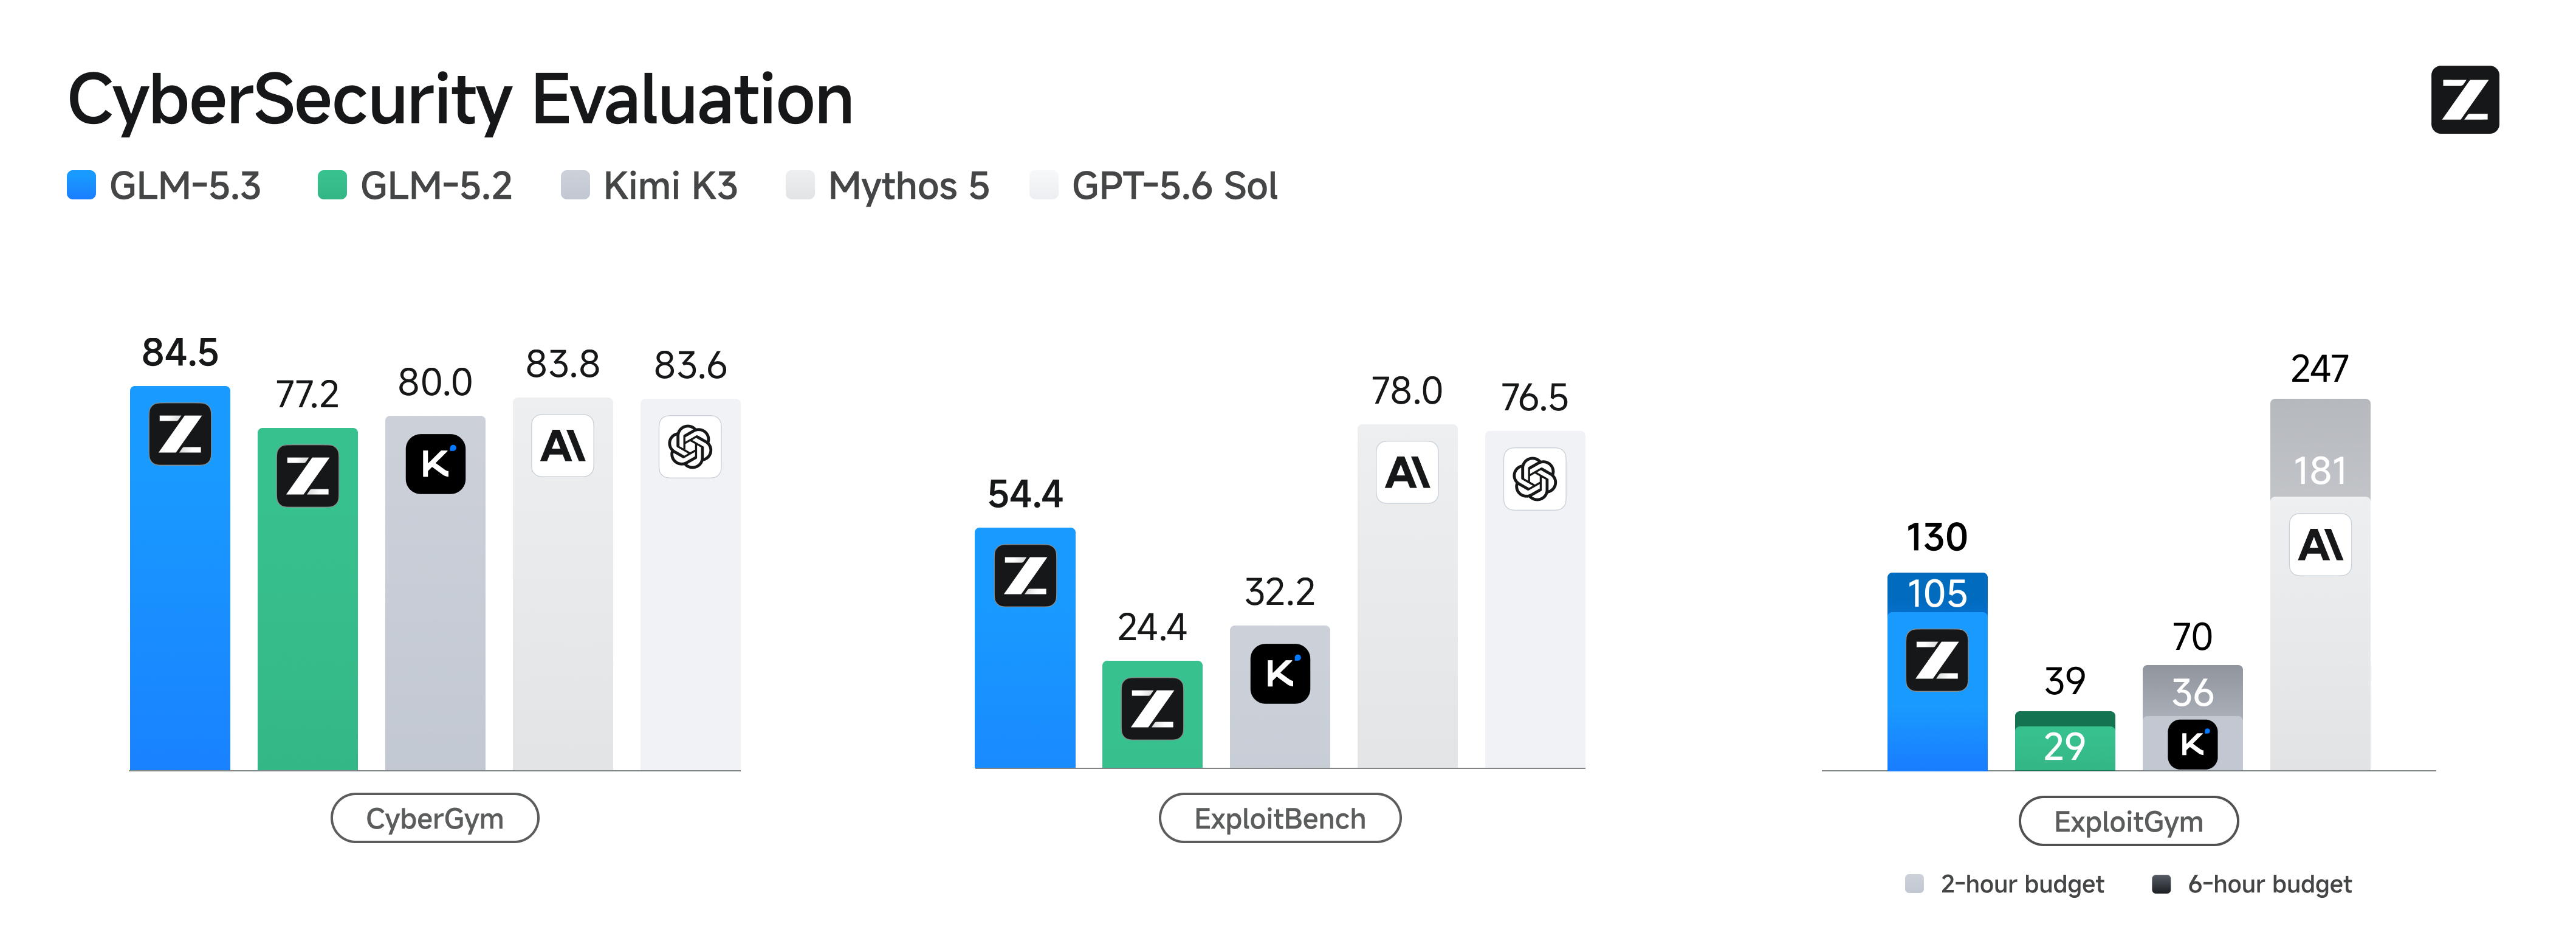
- აღმოცენებული კიბერშესაძლებლობა: პოსტტრენინგის მასშტაბირებასთან ერთად, კიბერშესაძლებლობები იმაზე სწრაფად განვითარდა, ვიდრე ველოდით. GLM-5.3 მოწყვლადობების აღმოჩენის მხრივ CyberGym-ზე საუკეთესო შედეგს აჩვენებს, ხოლო ყველაზე დიდი გაუმჯობესება ექსპლუატაციის ჯაჭვის უფრო მაღალ საფეხურებზე აქვს — ექსპლუატაციის ბენჩმარკებზე მისი შედეგი GLM-5.2-ისას ორჯერ აღემატება.
- ღია კოდი: წონებს გაშვებიდან ორ კვირაში გამოვუშვებთ, უსაფრთხოების შეფასებისა და გამყარების დასრულების შემდეგ.
აღმოცენებული კიბერშესაძლებლობა
პოსტტრენინგის ფარგლებში, ტრენინგის ნაკრებში მოწყვლადობების აღმოჩენის მონაცემები და გარემოები დავამატეთ. ველოდით, რომ ეს მოდელს მოწყვლადობების პოვნასა და მათზე მსჯელობაში გააუმჯობესებდა. ჩვენთვის მოულოდნელი კი ის აღმოჩნდა, თუ რამდენად გადააჭარბა ამ შესაძლებლობამ დასახულ მიზანს.
GLM-5.3-ს სამ ბენჩმარკზე ვაფასებთ, რომლებიც მოწყვლადობების ანალიზისა და ექსპლუატაციის სხვადასხვა ეტაპს მოიცავს. CyberGym-ში, რომელიც თეთრი ყუთის საწყისი კოდიდან იწყება და ამოწმებს, შეუძლია თუ არა მოდელს ხარვეზების გამოწვევით მოწყვლადობების აღმოჩენა და დადასტურება, GLM-5.3 84.5%-ს იღებს, GLM-5.2-ის 77.2%-თან შედარებით — ეს ბენჩმარკზე საუკეთესო შედეგია, რომელიც Mythos 5-ის (83.8%) და GPT-5.6 Sol-ის (83.6%) შედეგებს აღემატება. ExploitBench-ზე, რომელიც რეალურ მოწყვლადობებსა და მათ ექსპლუატაციაზე უფრო ღრმა მსჯელობას მოითხოვს, GLM-5.3 54.4%-ს აღწევს — GLM-5.2-ის 24.4%-ზე ორჯერ მეტს; Mythos 5-ისა და GPT-5.6 Sol-ის შედეგები კი, შესაბამისად, 78.0% და 76.5%-ია. ExploitGym-ზე, რომელიც ზომავს, რამდენი ექსპლუატაციის ამოცანის შესრულება შეუძლია მოდელს დროის ნორმალიზებული ბიუჯეტის ფარგლებში, GLM-5.3 ორ საათში 105 ამოცანას, ექვს საათში კი 130-ს ასრულებს; GLM-5.2-ის შესაბამისი შედეგებია 29 და 39. Mythos 5 კვლავ მნიშვნელოვნად წინ არის — 181 და 247 ამოცანით. სამივე ბენჩმარკზე ერთი და იგივე სურათი იკვეთება: რაც უფრო მაღალ საფეხურზეა ბენჩმარკი ექსპლუატაციის ჯაჭვში, მით უფრო დიდია GLM-5.2-თან შედარებით GLM-5.3-ის უპირატესობა — და მით უფრო დიდია მანძილი დახურულ მოწინავე მოდელებამდე. შესაძლებლობები ყველაზე სწრაფად სწორედ იქ იზრდება, სადაც ყველაზე მეტად ჩამოვრჩებით.
შემდეგ შევამოწმეთ, ვრცელდებოდა თუ არა ეს შესაძლებლობები კონტროლირებადი ბენჩმარკების ფარგლებს გარეთაც. GLM-5.2-ის გამოშვების შემდეგ ჩინეთში უსაფრთხოების რამდენიმე გუნდთან ვთანამშრომლობთ, რათა ჩვენი მოდელები რეალურ კოდურ ბაზებზე გამოგვეცადა. ექსპერტების მიერ გადამოწმების,筛რაციისა და დუბლიკატების მოცილების შემდეგ, მოდელმა 269 პროექტში 2,436 მოწყვლადობა აღმოაჩინა, მათ შორის საშუალო და მაღალი სიმძიმის 1,097 ხარვეზი. აღმოჩენები მოიცავს სისტემის ბირთვებს, ოპერაციულ სისტემებს, ბრაუზერის ძრავებს, ღია კოდის ინფრასტრუქტურას, ვებაპლიკაციებსა და ქსელურ პროტოკოლებს. ბევრი მათგანი წლებისა თუ ათწლეულების განმავლობაში შეუმჩნეველი რჩებოდა; უძველესი დაახლოებით 40 წლის წინანდელია.
ამ სამუშაოს შედეგად მოწყვლადობების გამჟღავნების მიმდინარე პროცესი ჩამოყალიბდა. აღმოჩენების საჯარო აღრიცხვისა და გამჟღავნების პროცესში მათი წინსვლის თვალყურის სადევნებლად შევქმენით Z.ai Security Disclosure Ledger. რეესტრი მუდმივად ახლდება, როდესაც ახალ მოწყვლადობებს განვიხილავთ და ვამჟღავნებთ; მასში გამიჯნულია უკვე გასაჯაროებული საკითხები და ისინი, რომელთა გამჟღავნების პროცესი ჯერ კიდევ მიმდინარეობს. გასაჯაროებული საკითხების შესახებ რეესტრში მოცემულია ინფორმაცია, მათ შორის დაზარალებული პროექტი, სიმძიმე, CVE — თუ ხელმისაწვდომია — და ის, რამდენ ხანს რჩებოდა მოწყვლადობა კოდურ ბაზაში.
slime: ხანგრძლივი ჰორიზონტის RL-ის მასშტაბირებისთვის შექმნილი სისტემა
ეს ყველაფერი slime-ზე მუშაობს — RL-ის მასშტაბირებისთვის განკუთვნილ ჩვენს ღია კოდის პოსტტრენინგის ჩარჩოზე; ტრენინგის მხარეს Megatron-ია, ხოლო rollout-ის მხარეს — SGLang. მისი არქიტექტურა ტრენინგს, rollout-სა და მონაცემთა ბუფერს მონაცემთა ერთ ნაკადში აერთიანებს, ამიტომ მათემატიკა, კოდი, sandbox-ები, ვერიფიკატორები და ხანგრძლივი ჰორიზონტის აგენტური გარემოები ტრენინგის ციკლის შესაცვლელად კი არა, მონაცემების გენერირების გზით ერთვება. სწორედ ამის წყალობით შევძელით GLM-5.2-სა და GLM-5.3-ს შორის გარემოების დამატება ისე, რომ ტრენინგის ტექნოლოგიური ბაზის თავიდან აწყობა არ დაგვჭირვებია.
GLM-5.3-ის შექმნისას სისტემა ორი მიმართულებით განვავითარეთ. ალგორითმულ მხარეს RL-ის კვლევისთვის განკუთვნილი შესაძლებლობები დავამატეთ: top-p mask, top-k და full-vocabulary OPD, აგრეთვე კონფიგურაციები, რომლებიც ტრენინგსა და rollout-ს შორის თანხვედრას აუმჯობესებს. მათ შორისაა R3-ის სტილის პარამეტრები და ტრენინგისა და rollout-ის გზებს შორის სრული რიცხვითი თანხვედრა. ეს გვაძლევს სინჯების აღების, ტრენინგისა და მასწავლებლის სიგნალების უფრო ზუსტად მართვის საშუალებას და კონტროლირებადი შედარებების სწრაფად ჩატარებას გვიადვილებს. ტრენინგსა და rollout-ს შორის თანხვედრის შეფასებისას, ლოგარითმულ ალბათობებს (logprob) შორის საშუალო სხვაობა 1e-7-ის დონეზე შევინარჩუნეთ, რაც წინა კონფიგურაციებთან შედარებით 99.99%-ზე მეტ შემცირებას წარმოადგენს.
ასევე ვიმუშავეთ რესურსების ეფექტიანობასა და მასშტაბური RL სისტემის გამტარუნარიანობაზე. ლოკალური საცავი ახლა ქეშირების დამატებით ფენად გამოიყენება და იერარქიულად ინახავს მოდელის მდგომარეობებსა და მონაცემებს, რომლებიც სხვაგვარად ჰოსტის მეხსიერებაში იქნებოდა. ეს განსაკუთრებით მნიშვნელოვანია მრავალმასწავლებლიანი OPD-ისთვის: ტრენინგის მხარეს მასწავლებლების დინამიკური გადართვისა და წინასწარი ჩატვირთვის წყალობით, შესაძლებელია რამდენიმე მასწავლებლის გამოყენება თითოეულისთვის ცალკე, მუდმივად გაშვებული დასკვნის სერვისის შექმნის გარეშე — მცირე დამატებითი დანახარჯითა და საგრძნობლად ნაკლები რესურსის მოხმარებით. აგენტური და ასინქრონული დატვირთვებისთვის, router-სა და slime-ს შორის ერთობლივი დაგეგმვა და დატვირთვის დაბალანსება გავაუმჯობესეთ, რათა სიგრძითა და დასრულების დროით ერთმანეთისგან მკვეთრად განსხვავებული rollout-მოთხოვნები დასკვნის რესურსებს უკეთ იყენებდეს. დავამატეთ დატვირთვის გათვალისწინებით მომუშავე ევრისტიკები, რომლებიც თითოეული rollout-გარემოს მახასიათებლების მიხედვით ადგენს გამტარუნარიანობაზე ორიენტირებულ კონფიგურაციებს — prefill/decode რესურსების თანაფარდობას, კონკურენტულობის პარამეტრებსა და სხვა გამტარუნარიანობისთვის კრიტიკულ პარამეტრებს. შედეგად, ხანგრძლივი ჰორიზონტის კოდირების RL-ამოცანებისთვის, ამ სისტემურმა ოპტიმიზაციებმა RL-ტრენინგის ბოლომდე გამტარუნარიანობა 2.3-ჯერ მეტად გაზარდა. ამან მოგვცა საშუალება, ტრენინგი უფრო ხანგრძლივ ტრაექტორიებსა და უფრო რთულ გარემოებზე გაცილებით ეფექტიანად გაგვემასშტაბირებინა.
ერთად აღებული, ეს ცვლილებები მეტ ექსპერიმენტულ მოქნილობას, ნაკლებ რესურსულ დანახარჯსა და მაღალ გამტარუნარიანობას გვაძლევს — სწორედ ეს გვაძლევს RL-ის მასშტაბირების პრაქტიკულად გაგრძელების საშუალებას.
GLM-5.3-ის გამოყენების დაწყება
API-ის ცვლილებები GLM-5.3-ში
GLM-5.3 მხარს უჭერს აზროვნების სამ ინტენსივობის დონეს: low, high და max. GLM-5.3-ში აზროვნების გამორთვა მხარდაჭერილი აღარ არის.
| პარამეტრი | მნიშვნელობები | ნაგულისხმევი | აღწერა |
|---|---|---|---|
| thinking.type | enabled | enabled | რთავს აზროვნებას. disabled მხარდაჭერილი აღარ არის. |
| reasoning_effort | low, high, max | max | low: მსუბუქი; high: გაძლიერებული; max: სიღრმისეული. კოდირების ამოცანებისთვის რეკომენდებულია max. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
აუცილებელია მიგრაცია: თუ თქვენი აპლიკაცია ამჟამად იყენებს thinking.type: "disabled"-ს, მოდელის ID-ის glm-5.3-ზე განახლებამდე შეცვალეთ ის enabled-ით და reasoning_effort დააყენეთ low-ზე. წინააღმდეგ შემთხვევაში, მოთხოვნა ვერ შესრულდება.
GLM-5.3-ის გამოყენება GLM Coding Plan-სა და ZCode-თან ერთად
სცადეთ GLM-5.3 თქვენთვის სასურველ კოდირების აგენტებში — ZCode-ში, Claude Code-ში, OpenCode-სა და სხვაგან. იხილეთ devpack-ის მიმოხილვა.
GLM Coding Plan-ის გამომწერებისთვის: GLM-5.3 უკვე ხელმისაწვდომია GLM Coding Plan-ის ყველა მომხმარებლისთვის. GLM Coding Plan-ის ახალი ვერსია ახლა ქულებზე დაფუძნებულ კვოტირების სისტემას იყენებს. ქულების მოხმარება ცალ-ცალკე ითვლება შემავალი, ქეშირებული შემავალი და გამომავალი ტოკენებისთვის. პიკის საათების მიღმა შესრულებული მოდელის გამოძახებები სტანდარტული ქულების 50%-ს მოიხმარს. პიკის საათებია ორშაბათიდან პარასკევის ჩათვლით, 14:00–18:00 (UTC+8); ყველა სხვა დროს, შაბათ-კვირის ჩათვლით, მოქმედებს პიკის გარეთ საათების 50%-იანი ტარიფი. დაიწყეთ მუშაობა ახლავე: z.ai/subscribe
მიიღეთ მეტი GLM-5.3-ისგან ZCode-ით
- ქეშის 98%+-იანი დამთხვევის მაჩვენებელი — განმეორებითი კონტექსტი ქეშირებული მონაცემებისთვის დაწესებული დაბალი ტარიფით ფასდება, რაც დაახლოებით 30%-ით მეტ ეფექტიან ტოკენს გაძლევთ
- შეზღუდული დროით კვოტის 1.5-ჯერ გაზრდა — შეუთავსეთ ქეშის ეკონომიას და 31 აგვისტომდე მიიღეთ სტანდარტულ კვოტაზე 180%-მდე მეტი
- ხანგრძლივი ჰორიზონტის ოსტატური მართვა — Goal mode გეგმავს, წერს კოდს, ტესტავს და ამოწმებს, სანამ მიზანი არ შესრულდება
- Remote Control — აკონტროლეთ და მართეთ ხანგრძლივი ამოცანები თქვენი ტელეფონიდან, WeChat-ის ან Feishu-ს საშუალებით
სცადეთ ZCode: zcode.z.ai
გაუშვით GLM-5.3 ლოკალურად
GLM-5.3-ის მოდელის წონები მალე, გაშვებიდან ორი კვირის განმავლობაში, საჯაროდ ხელმისაწვდომი გახდება.