Claude Haiku 5.5, 이제 VEGA에서 이용 가능
Anthropic은 2026년 10월 7일 Claude Haiku 5.5를 출시했습니다. 지금까지 회사가 선보인 소형 모델 중 가장 빠르고 성능이 뛰어나며, 평균적으로 Haiku 4.5보다 실행 비용이 약 75% 저렴합니다.
Haiku 5.5는 이미 VEGA에서 작동합니다. auto, chat, code, web, extreme, memory 모드의 기본 모델입니다.
어떤 작업을 위해 만들어졌나
Haiku 5.5는 심층적인 추론보다 비용과 속도가 중요한 대량 작업을 겨냥합니다. Anthropic은 요약, 컨텍스트 압축, 데이터베이스 쿼리, 분류를 활용 사례로 꼽습니다. 응답 시간이 제품의 사용감을 좌우하는 실시간 고객 지원과 브라우저 사용에도 적합합니다.
코딩 환경에서는 Opus 5.5 또는 Sonnet 5.5와 함께 서브에이전트로 작동합니다. Anthropic은 어려운 에이전트형 코딩 작업에는 Haiku 5.5를 선택하지 말라고 분명히 밝힙니다. Terminal-Bench 4.0과 같은 작업에서는 여전히 Sonnet 5.5와 Opus 5.5가 앞섭니다.
Haiku 5.5는 조정 가능한 effort 설정을 지원하는 최초의 Haiku 계열 모델이기도 합니다. 사용 목적에 따라 비용을 낮추거나 품질을 높이는 설정을 선택할 수 있습니다.
벤치마크
아래 표는 Haiku 5.5를 Haiku 4.5, GPT-6 Luna와 비교합니다. Sonnet 5.5는 참고용으로 포함했습니다.
| 벤치마크 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (지식 업무) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (지식 업무) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, 오프라인 하위 집합 (컴퓨터 사용) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam, 도구 미사용 | 45.9% | 10.2% | n/a | 56.9% |
| Humanity's Last Exam, 도구 사용 | 57.4% | 18.7% | n/a | 64.5% |
| Terminal-Bench 4.0 (에이전트형 코딩) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1, Main (에이전트형 코딩) | 46.4% | n/a | 42.4% | 52.1% (Xhigh) |
| Chartography, 도구 미사용 (시각적 추론) | 46.4% | 6.4% | 29.1% | 61.6% |
effort 설정에 따라 수치가 크게 달라집니다. OSWorld 2.1에서 Haiku 5.5의 점수는 Low 설정($0.07)의 42.0%부터 Max($0.61)의 72.4%까지 올라갑니다.
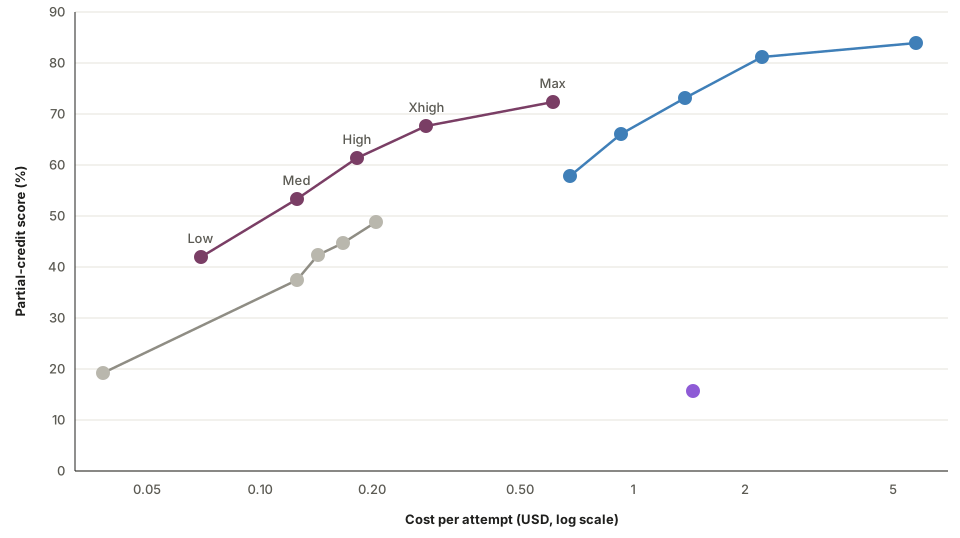
OSWorld 2.1은 에이전트가 실제 컴퓨터에서 여러 단계로 이뤄진 장시간 작업을 얼마나 잘 수행하는지 측정합니다.
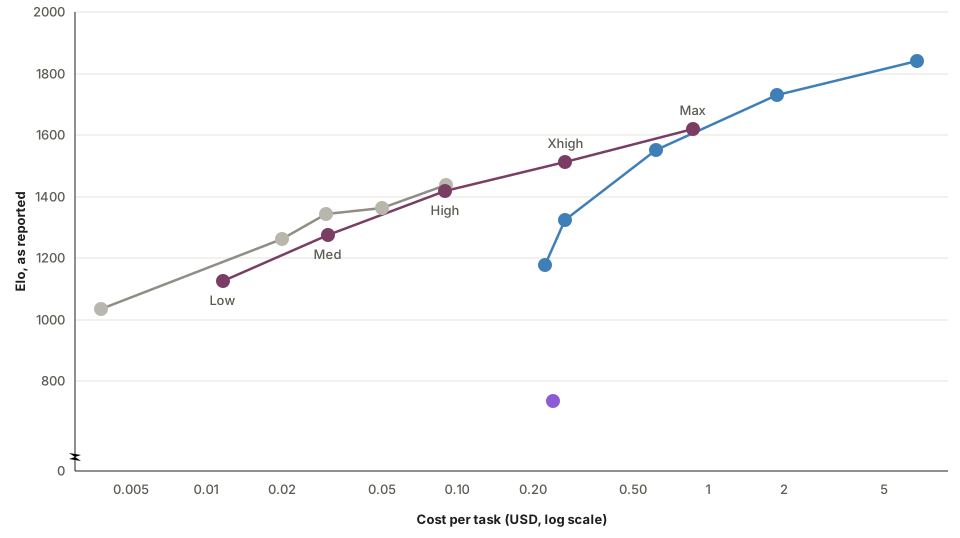
GDPval-AA v2.1은 Artificial Analysis가 진행하는 평가입니다. 44개 직종의 실제 전문 업무를 대상으로 에이전트를 테스트합니다. Haiku 5.5는 Max 설정에서 1620점을 기록해 Haiku 4.5의 735점보다 크게 앞섰습니다.
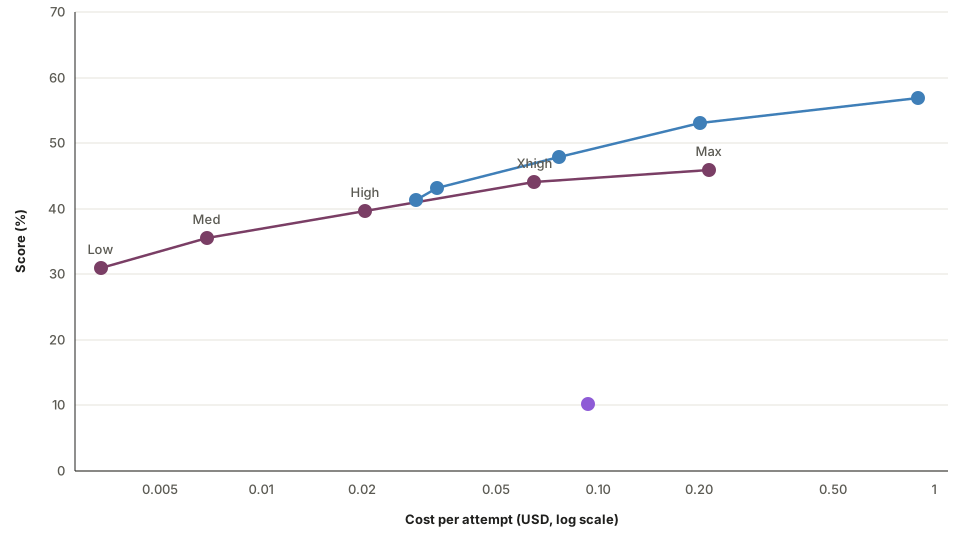
Humanity's Last Exam은 전문가 수준의 학술 지식과 추론 능력을 평가합니다. 도구를 사용하지 않을 때 Haiku 5.5는 Max 설정에서 45.9%를 기록한 반면, Haiku 4.5는 10.2%를 기록했습니다.
초기 고객 성과
Anthropic에 따르면 초기 테스터들은 위의 수치와 일치하는 성과를 확인했습니다.
- Asana는 AI Teammates 평가를 진행했습니다. 현재 사용하는 모델과 비교해 Haiku 5.5는 작업 완료 지연 시간을 30% 넘게 줄였고, 에이전트 턴당 추론 속도를 최대 2.5배 높였습니다.
- HubSpot은 시뮬레이션한 CRM 포털에서 Haiku 5.5를 테스트했습니다. 세 번의 실행에서 평균 92.8%를 기록해 HubSpot이 지금까지 해당 평가에서 확인한 점수 중 가장 높았습니다. 오래된 레코드를 감사하는 작업도 가장 빠르게 완료했으며, 테스트한 모델 가운데 적중률이 가장 높고 오탐률은 가장 낮았습니다.
- AlphaSense는 프로덕션 환경에서 주당 약 800만 건의 호출을 처리하는 기능인 Ask in Document를 통해 400개의 쿼리를 실행했습니다. Haiku 5.5는 0.84점을 기록해 Haiku 4.5의 0.76점보다 통계적으로 유의미하게 높은 점수를 얻었습니다.
- Box는 초기 테스트에서 Haiku 5.5가 Haiku 4.5보다 지연 시간은 약 절반으로 줄이면서 11점 더 높은 점수를 기록했다고 밝혔습니다.
- Cognition은 Devin Fusion의 사이드킥 구성에 Haiku 5.5를 추가했습니다. Opus 5.5를 리드 모델로 함께 사용한 Fusion은 비용과 지연 시간을 줄이면서 FrontierCode 점수 66.2를 유지합니다.
가격
가격은 토큰 100만 개당 기준입니다. 이전 Haiku 모델 요청의 약 90%는 10만 토큰 이하였으며, 이 구간에서 Haiku 5.5의 비용 절감 효과가 가장 큽니다.
| 토큰 100만 개당 가격 | Haiku 5.5 (10만 개 이하 / 10만 개 초과) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| 캐시 읽기 | $0.01 / $0.05 | $0.10 | $0.10 |
| 캐시 쓰기 | $0.125 / $0.625 | $1.25 | $2.50 |
| 입력 토큰 | $0.10 / $0.50 | $1.00 | $2.00 |
| 출력 토큰 | $0.50 / $2.50 | $5.00 | $10.00 |
Haiku 5.5의 가격은 프롬프트가 10만 토큰 이하일 때 Haiku 4.5보다 90% 낮고, 더 긴 프롬프트에서는 50% 낮습니다. 평균 절감률은 약 75%입니다. 이 수치에는 Sonnet 5.5와 Opus 5.5에서 사용하는 것과 비슷한 새 토크나이저의 영향도 반영되어 있습니다. 새 토크나이저는 작업당 토큰을 약간 더 많이 생성합니다.
기타 가격 변경
Anthropic은 다른 모델의 가격도 변경했습니다. Sonnet 5.5의 캐시 읽기 비용은 이제 토큰 100만 개당 $0.20에서 $0.10으로 50% 낮아졌습니다. 대부분의 에이전트형 작업에서 Sonnet 5.5의 비용이 약 20% 줄어듭니다. 아래 차트는 Terminal-Bench 4.0에서 두 가지 캐시 가격을 모두 보여줍니다.

Terminal-Bench 4.0은 명령줄 인터페이스에서 복잡한 다단계 전문 작업을 모델이 얼마나 잘 완료하는지 측정합니다. 이 차트는 Haiku 5.5와 더 큰 모델이 서로 다른 작업에 적합한 이유도 보여줍니다. Sonnet 5.5와 Opus 5.5는 복잡한 에이전트형 코딩에 더 뛰어나고, Haiku 5.5는 컨텍스트 압축, 요약, 서브에이전트 작업과 같은 범위가 좁은 작업에 적합합니다.
Max 및 Team 구독자에게는 새로운 월간 API 크레딧도 제공됩니다. Max 5x 사용자는 월 $100, Max 20x 사용자는 $200를 받으며, Team 구독자는 사용자 전체가 함께 사용할 수 있는 최대 $500의 크레딧을 받습니다. 크레딧은 이번 주부터 제공되며 Claude Platform의 모든 모델에 사용할 수 있습니다.
Python 및 TypeScript용 Claude SDK는 이제 베타 버전에서 컴퓨터 사용과 브라우저 사용을 지원합니다. Anthropic은 Haiku 5.5의 속도와 성능, 가격을 고려할 때 이러한 작업에 적합하다고 설명합니다.
안전성
Haiku 5.5는 거의 모든 정렬 평가에서 Haiku 4.5보다 개선된 성능을 보입니다. 정렬에 어긋나는 행동이 훨씬 적으며, 악용을 돕는 데도 덜 적극적입니다.
사이버 보안 보호 장치는 Haiku 4.5보다 엄격하지만 Sonnet 5.5보다는 덜 엄격합니다. 방어 목적의 작업은 더 폭넓게 허용하지만, 침투 테스트와 공격자가 사용할 가능성이 높은 다른 기법은 여전히 차단합니다. 생물학 관련 보호 장치는 Sonnet 5, Sonnet 5.5, Opus 5와 동일합니다. 연구 목적의 생물학 질문은 허용되며, 해를 끼칠 가능성이 높다고 판단되는 요청은 제한됩니다. 생물학 또는 사이버 분야에서 더 폭넓은 지원이 필요한 조직은 Anthropic의 Life Sciences Verification Program 및 Cyber Verification Program에 신청할 수 있습니다.
이용 가능 여부
Haiku 5.5는 Amazon Web Services, Google Cloud, Microsoft Azure를 비롯한 모든 주요 클라우드 플랫폼에서 지금 이용할 수 있습니다. Claude Platform에서 사용하는 모델 ID는 claude-haiku-5-5입니다.
VEGA에서 사용해 보기
Haiku 5.5는 VEGA의 auto, chat, code, web, extreme, memory 모드에서 기본 모델로 제공됩니다. 속도가 가장 중요한 빠른 답변, 요약, 정보 검색에 적합합니다.
Anthropic도 설명하듯, 가장 어렵고 개방형인 작업에는 여전히 Opus 5.5와 Sonnet 5.5가 더 나은 선택입니다.
Anthropic의 원문 발표는 anthropic.com/claude-haiku-5-5에서 확인할 수 있습니다.