GLM-5.3: 사이버 보안 역량이 부상한 차세대 코딩 모델
GLM-5.3에서 우리가 집중한 것은 오직 포스트트레이닝의 확장뿐이었습니다. GLM-5.2에서 우리는 기반 기술 스택을 구축했습니다. 효율적인 장문 컨텍스트 처리를 위한 IndexShare, 장기 과제에 대한 강화학습을 위한 SAO, 대규모 비동기 훈련을 위한 slime — 이 모든 것이 우리가 지속적으로 축적해온 장기 과제 환경 위에서 동작합니다. 지난 한 달간 우리는 이 스택 위에서 계속해서 확장해 나갔습니다. 더 많은 환경, 더 다양한 과제, 그리고 그에 대한 더 많은 컴퓨팅 자원을 투입했습니다.
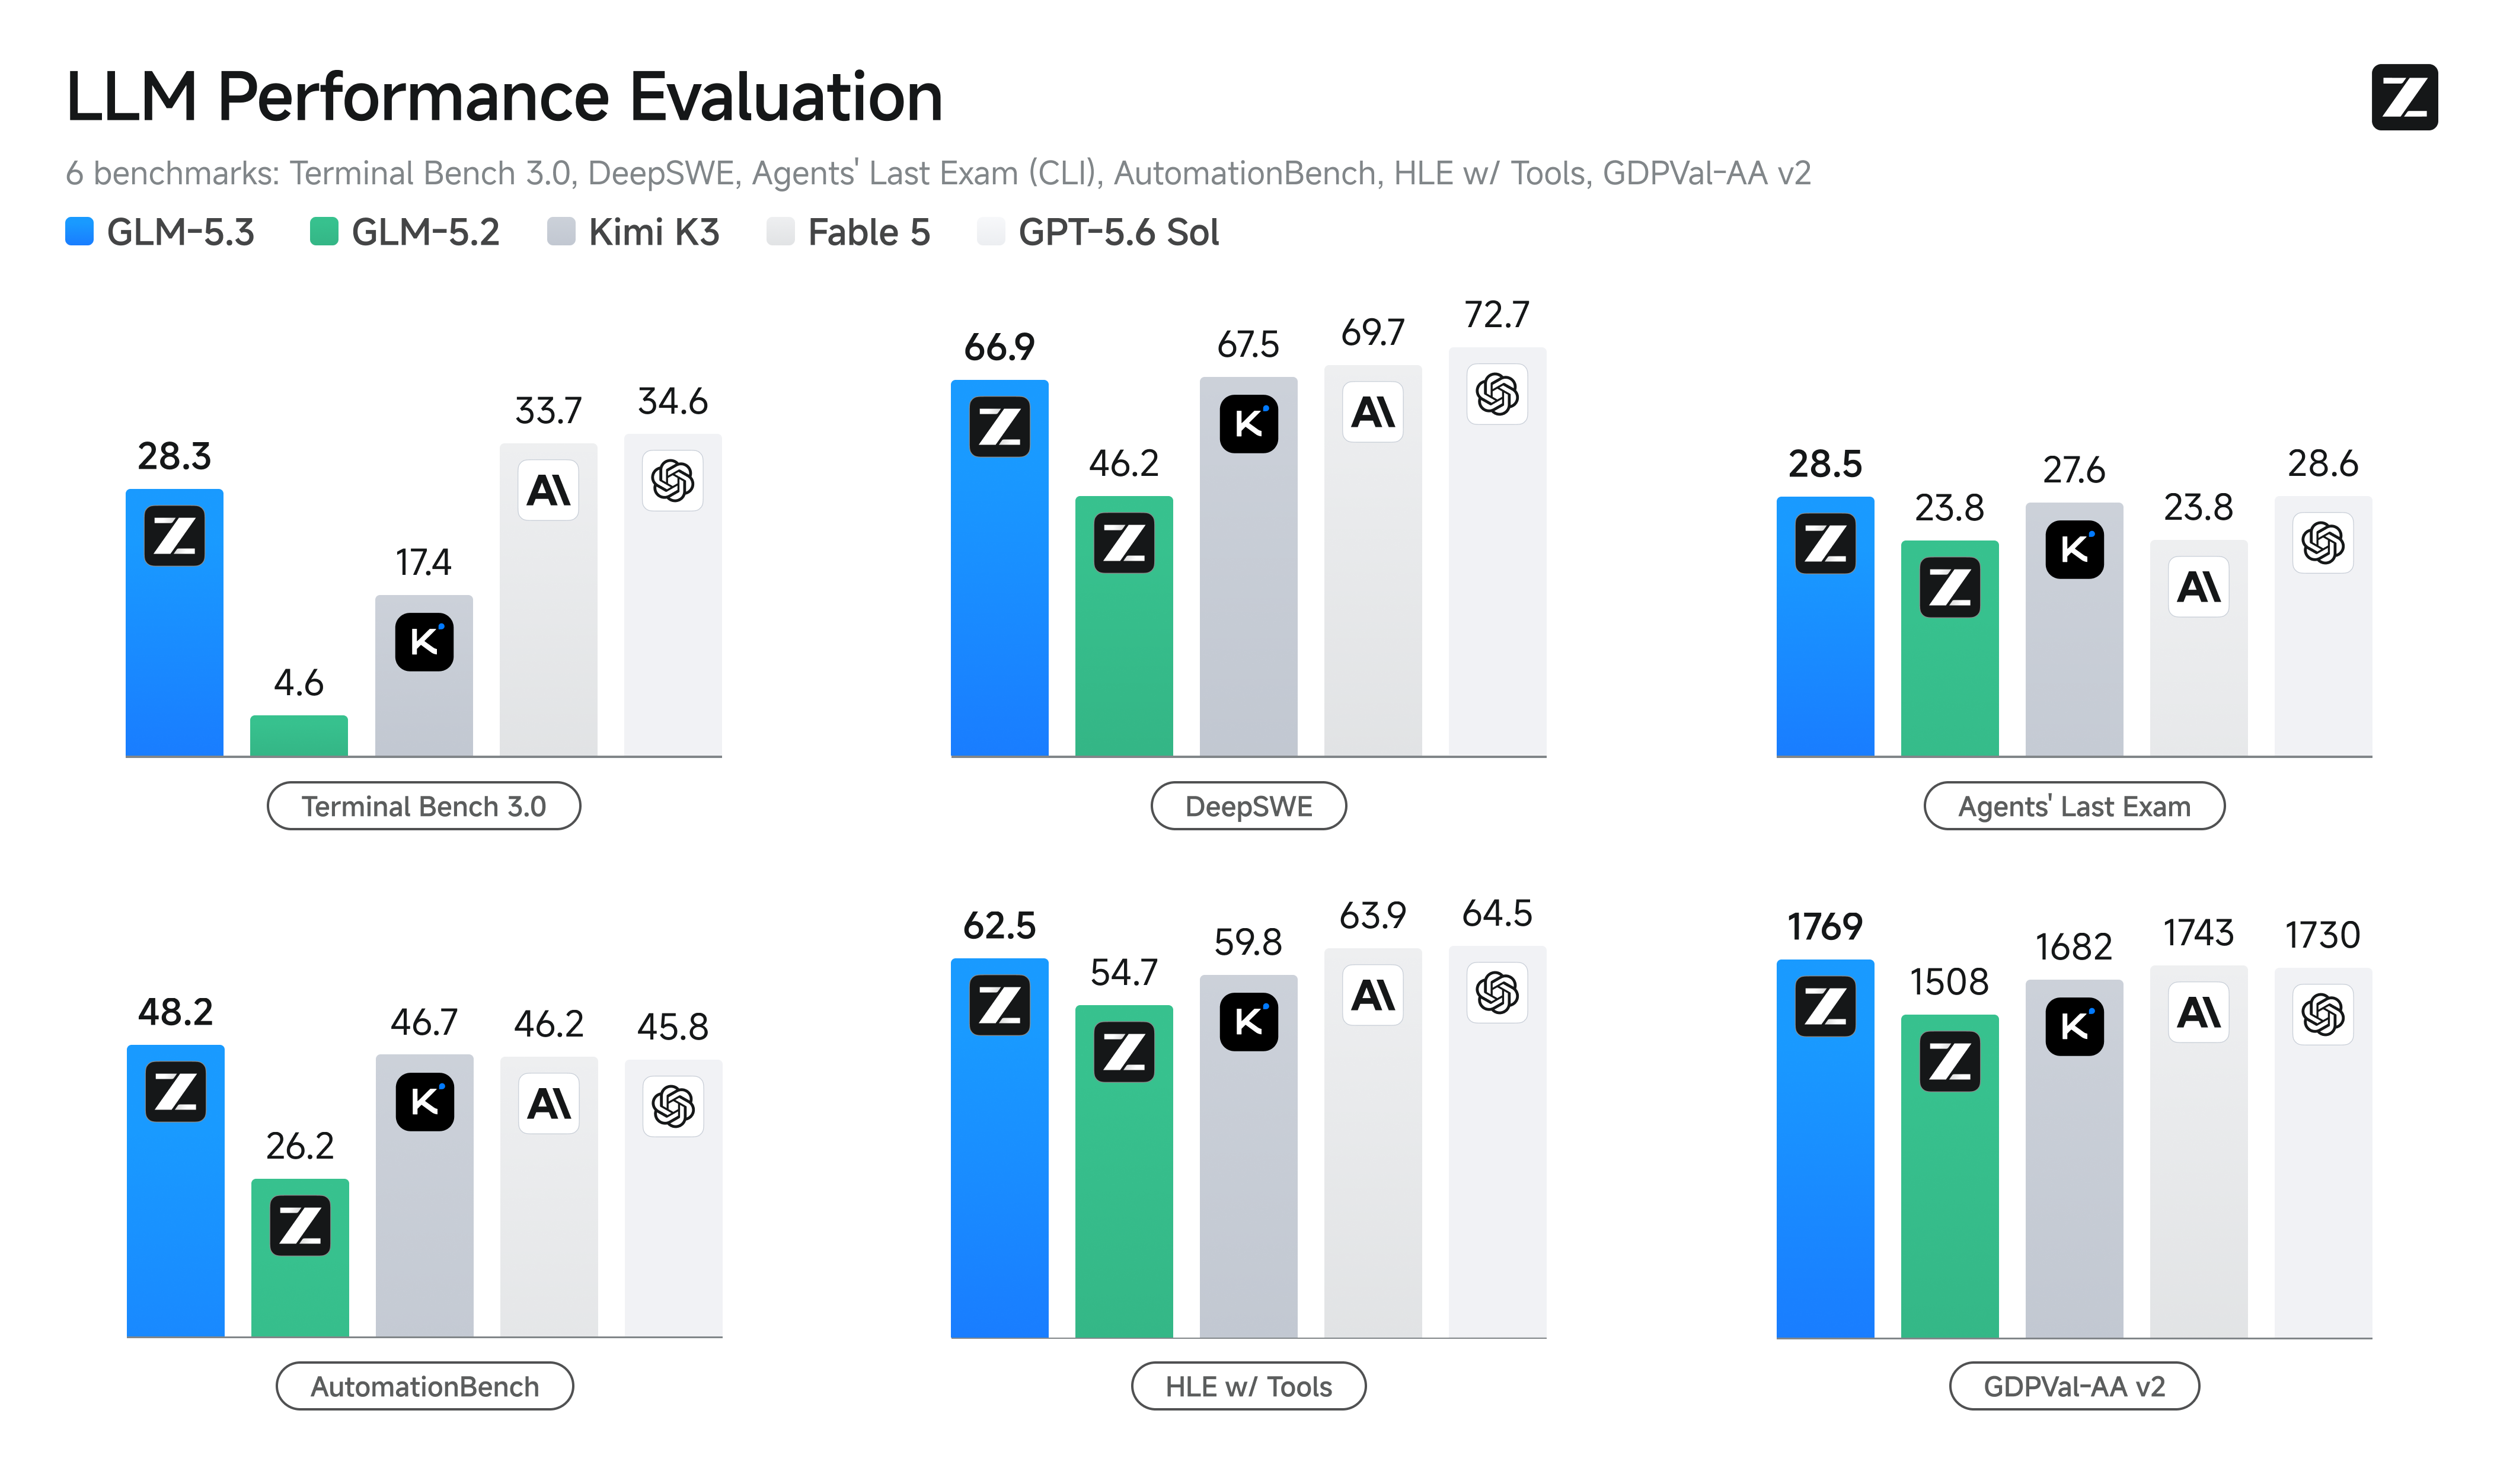
오늘, GLM-5.3을 공식 출시합니다. GLM-5.2와 동일한 베이스 모델을 사용하지만, 모든 성능 향상은 포스트트레이닝에서 비롯되었습니다. GLM-5.2와 비교했을 때 복잡한 코딩 및 장기 과제 처리 능력이 크게 향상되었습니다.
- 더 강력한 코딩 능력: GLM-5.3은 코딩 분야에서 가장 성능이 뛰어난 오픈웨이트 모델입니다. 자체 Z.ai Code Bench에서 GLM-5.2 대비 50% 향상을 달성했으며, Terminal Bench 3.0과 Agents' Last Exam 등 공개 벤치마크에서도 오픈소스 SOTA를 기록했습니다.
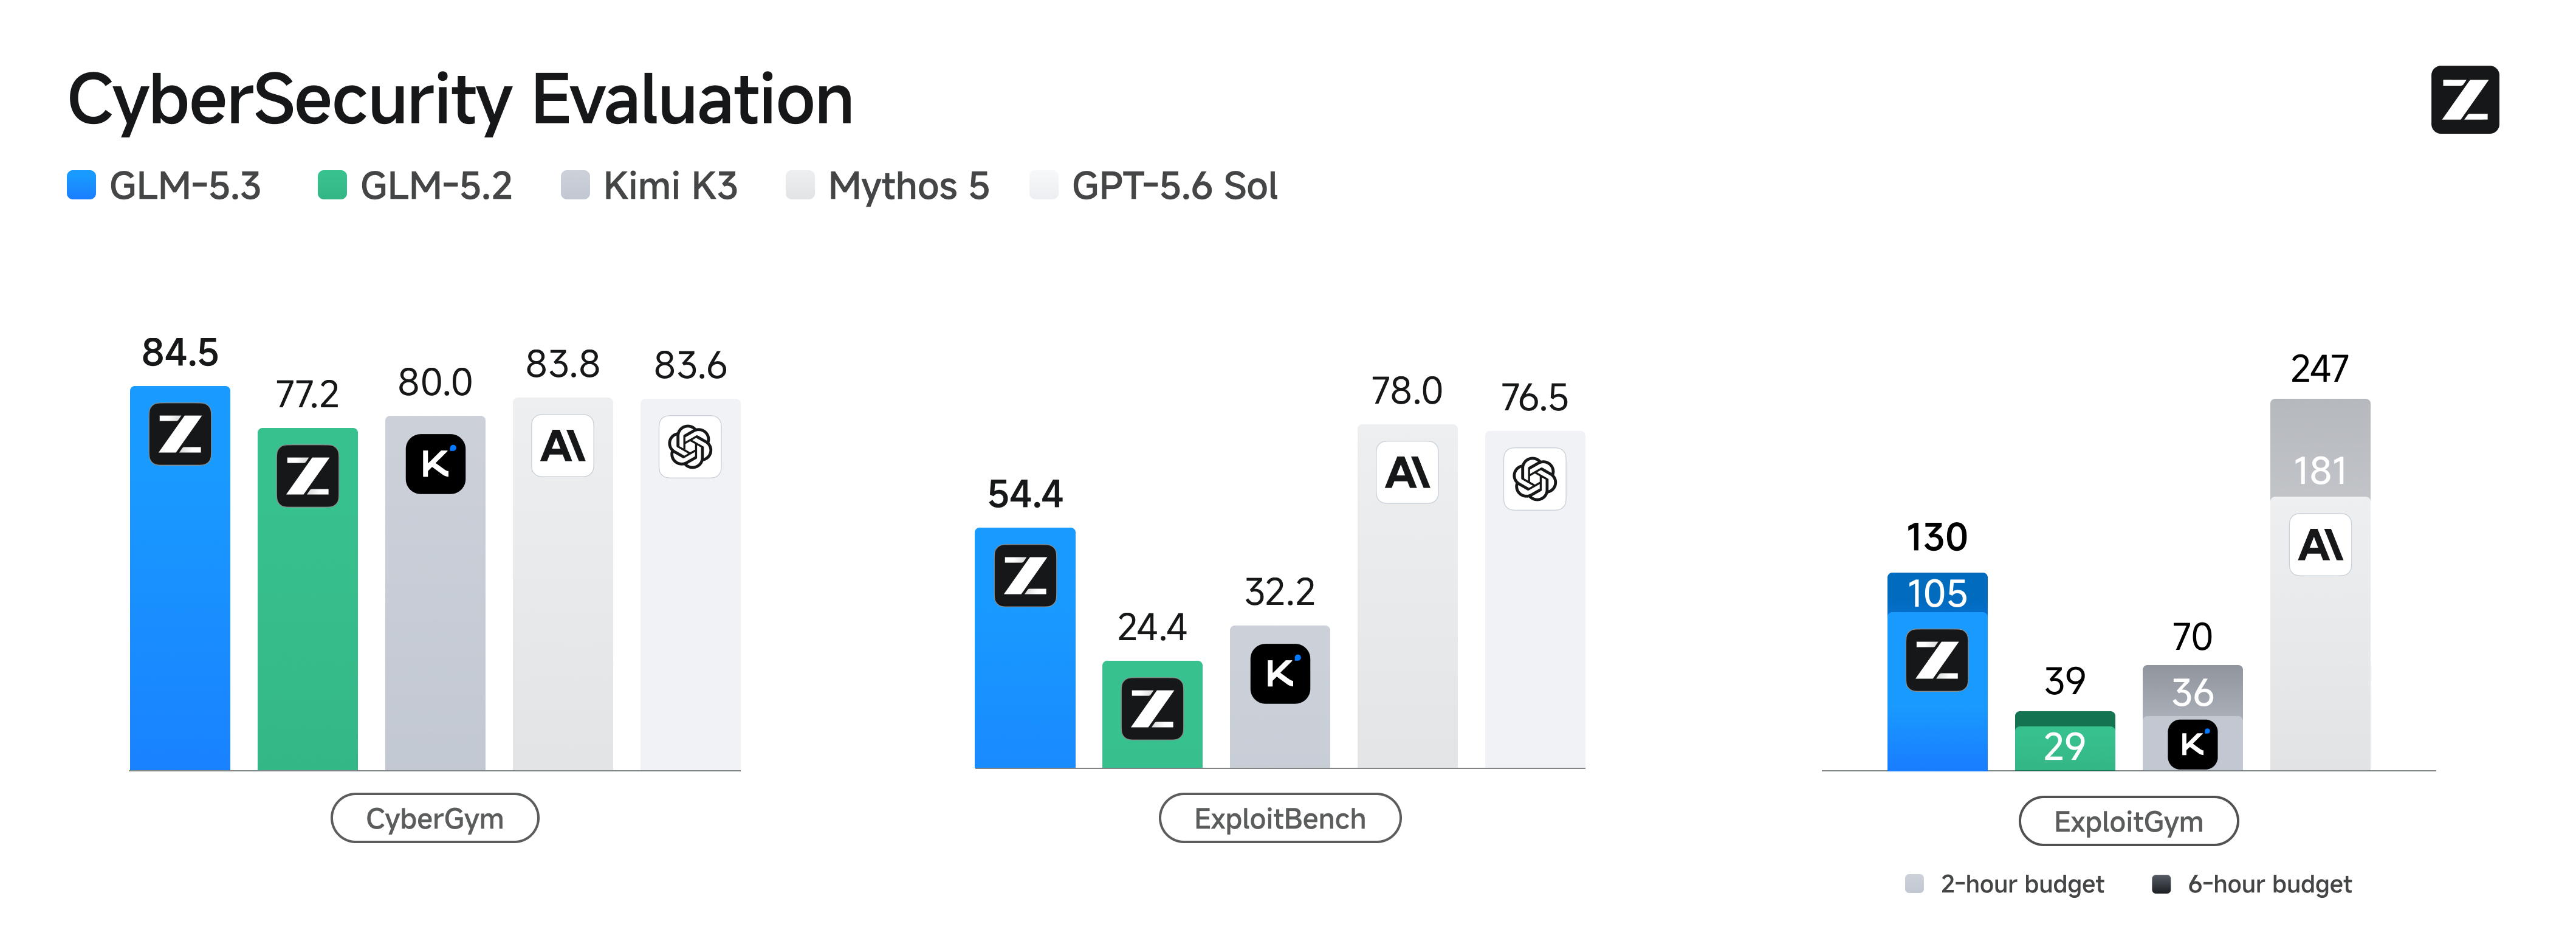
- 부상하는 사이버 보안 역량: 포스트트레이닝을 확장함에 따라 사이버 보안 역량이 예상보다 훨씬 빠르게 발전했습니다. GLM-5.3은 취약점 발견 분야의 CyberGym에서 SOTA를 달성했으며, 익스플로잇 체인 상위 단계로 갈수록 향상 폭이 더욱 커져 익스플로잇 벤치마크에서 GLM-5.2 대비 두 배 이상의 성능을 보여줍니다.
- 오픈소스: 출시 후 2주 내로 안전성 평가 및 하드닝 작업을 완료한 뒤 가중치를 공개할 예정입니다.
부상하는 사이버 보안 역량
포스트트레이닝의 일환으로, 훈련 데이터에 취약점 발견용 데이터와 환경을 도입했습니다. 이를 통해 모델이 취약점을 더 잘 찾고 추론할 수 있을 것으로 예상했습니다. 하지만 이 역량이 목표를 훨씬 뛰어넘어 발전한 것은 예상 밖이었습니다.
GLM-5.3을 취약점 분석 및 익스플로잇의 각 단계를 다루는 세 가지 벤치마크에서 평가했습니다. 화이트박스 소스코드에서 출발해 모델이 폴트를 트리거하여 취약점을 식별하고 검증할 수 있는지를 평가하는 CyberGym에서 GLM-5.3은 84.5%를 기록했습니다. 이는 GLM-5.2의 77.2%에서 크게 향상된 수치로, Mythos 5(83.8%)와 GPT-5.6 Sol(83.6%)을 제치고 벤치마크 최고 성적입니다. 실제 취약점과 그 익스플로잇에 대한 더 깊은 추론을 요구하는 ExploitBench에서는 GLM-5.3이 54.4%에 도달하여 GLM-5.2의 24.4%를 두 배 이상 뛰어넘었습니다. 같은 벤치마크에서 Mythos 5와 GPT-5.6 Sol은 각각 78.0%, 76.5%를 기록했습니다. 시간 정규화 예산 하에서 모델이 완료할 수 있는 익스플로잇 과제 수를 측정하는 ExploitGym에서는 GLM-5.3이 2시간 내 105개, 6시간 내 130개의 과제를 완료했습니다. GLM-5.2는 각각 29개, 39개에 그쳤습니다. Mythos 5는 181개, 247개로 여전히 크게 앞서 있습니다. 세 벤치마크에서 나타나는 패턴은 일관됩니다. 익스플로잇 체인의 상위 단계에 위치할수록 GLM-5.2 대비 향상 폭이 커지는 동시에, 클로즈드 프론티어 모델과의 격차도 더 넓어집니다. 우리가 가장 뒤처져 있는 영역에서 역량이 가장 빠르게 성장하고 있는 셈입니다.
이어서 이러한 역량이 통제된 벤치마크를 넘어 실제 환경으로 이전되는지 확인했습니다. GLM-5.2 시절부터 중국의 여러 보안 팀과 협력하여 실제 코드베이스에 모델을 적용해 왔습니다. 전문가 검토, 선별, 중복 제거를 거친 결과, 모델은 269개 프로젝트에서 2,436건의 취약점을 식별했으며, 그중 1,097건은 중간~고위험 등급이었습니다. 발견 사례는 시스템 커널, 운영체제, 브라우저 엔진, 오픈소스 인프라, 웹 애플리케이션, 네트워크 프로토콜 등 광범위한 영역에 걸쳐 있습니다. 많은 취약점이 수년은 물론 수십 년 동안이나 발견되지 않은 채 방치되어 있었으며, 가장 오래된 것은 약 40년 전으로 거슬러 올라갑니다.
이 작업은 현재 진행 중인 공개 취약점 정보 제공 노력으로 발전했습니다. 우리는 발견 사례가 공개 절차를 거치는 과정을 투명하게 기록하기 위해 Z.ai Security Disclosure Ledger를 구축했습니다. 이 원장은 새로운 취약점이 검토 및 공개될 때마다 지속적으로 갱신되며, 이미 공개된 문제와 아직 공개 절차가 진행 중인 문제를 명확히 구분합니다. 공개된 문제의 경우, 영향받는 프로젝트, 심각도, 가능한 경우 CVE 번호, 해당 취약점이 코드베이스에 존재했던 기간 등의 정보가 기록됩니다.
slime: 장기 강화학습 확장을 위해 설계되다
이 모든 것은 slime 위에서 동작합니다. slime은 훈련 측에 Megatron, 롤아웃 측에 SGLang을 사용하는 우리의 오픈소스 포스트트레이닝 RL 확장 프레임워크입니다. 핵심 설계는 훈련, 롤아웃, 데이터 버퍼를 단일 데이터플로우 위에 유지하는 것입니다. 덕분에 수학, 코드, 샌드박스, 검증기, 장기 에이전트 환경 등이 훈련 루프를 변경하는 대신 데이터 생성의 형태로 플러그인처럼 연결됩니다. 이 덕분에 GLM-5.2에서 GLM-5.3에 이르기까지 매번 훈련 스택을 재구축할 필요 없이 환경을 계속 추가할 수 있었습니다.
GLM-5.3에 이르기까지 우리는 두 가지 방향에서 slime을 발전시켰습니다. 알고리즘 측면에서는 RL 연구를 겨냥한 기능을 추가했습니다. top-p mask, top-k 및 전체 어휘 OPD, 그리고 훈련-롤아웃 일관성을 높이는 구성 — R3 스타일 설정과 훈련/롤아웃 경로 간의 완전한 수치 정렬 — 을 도입했습니다. 이를 통해 샘플링, 훈련, 티처 신호에 대한 더 정밀한 제어가 가능해졌고, 통제된 비교 실험을 빠르게 실행할 수 있게 되었습니다. 훈련-롤아웃 일관성 평가에서 로그 확률(logprob)의 평균 차이는 1e-7 수준으로 제어되었으며, 이는 기존 설정 대비 99.99% 이상의 감소를 의미합니다.
또한 대규모 RL을 위한 자원 효율성과 시스템 처리량 개선에도 힘을 쏟았습니다. 이제 로컬 스토리지가 추가 캐싱 계층으로 작동하여, 기존에는 호스트 메모리에 있던 모델 상태와 데이터를 계층적으로 보관합니다. 이는 다중 티처 OPD에서 특히 중요합니다. 훈련 측에서 동적 티처 전환과 프리페칭을 적용함으로써, 각 티처마다 전용 장기 추론 서비스를 띄울 필요 없이 여러 티처를 사용할 수 있게 되었습니다. 추가 오버헤드는 제한적이면서도 자원 소모는 대폭 줄었습니다. 에이전트 및 비동기 워크로드의 경우, 라우터와 slime 간의 공동 스케줄링과 부하 분산을 개선하여 길이와 완료 시간이 크게 다른 롤아웃 요청이 추론 자원을 더 효율적으로 활용하도록 했습니다. 각 롤아웃 환경의 특성으로부터 처리량 중심 구성 — prefill/decode 자원 비율, 동시성 설정 등 처리량에 결정적인 파라미터 — 을 도출하는 워크로드 인식 휴리스틱도 추가했습니다. 그 결과, 장기 코딩 RL 과제에서 이러한 시스템 수준의 최적화가 엔드투엔드 RL 훈련 처리량을 2.3배 이상 향상시켰으며, 더 긴 궤적과 더 복잡한 환경에 걸쳐 훈련을 훨씬 더 효율적으로 확장할 수 있게 되었습니다.
종합하면, 이러한 개선은 더 높은 실험 유연성, 더 낮은 자원 비용, 더 높은 처리량을 제공합니다 — 바로 이것이 RL 확장을 실용적으로 만드는 요소들입니다.
GLM-5.3 시작하기
GLM-5.3의 API 변경 사항
GLM-5.3은 세 가지 사고 강도 수준을 지원합니다: low, high, max. GLM-5.3에서는 사고 기능 비활성화가 더 이상 지원되지 않습니다.
| Parameter | Values | Default | Description |
|---|---|---|---|
| thinking.type | enabled | enabled | Enables thinking. disabled is no longer supported. |
| reasoning_effort | low, high, max | max | low: light; high: enhanced; max: deep. max is recommended for coding tasks. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
마이그레이션 필요: 현재 애플리케이션에서 thinking.type: "disabled"를 사용 중이라면, 모델 ID를 glm-5.3으로 업데이트하기 전에 enabled로 변경하고 reasoning_effort를 low로 설정하십시오. 그렇지 않으면 요청이 실패합니다.
GLM Coding Plan & ZCode로 GLM-5.3 사용하기
GLM-5.3을 ZCode, Claude Code, OpenCode 등 익숙한 코딩 에이전트에서 사용해 보세요. 자세한 내용은 devpack overview를 참조하세요.
GLM Coding Plan 구독자분들께: GLM-5.3을 모든 GLM Coding Plan 사용자에게 롤아웃했습니다. 새로운 GLM Coding Plan은 이제 포인트 기반 할당량 시스템을 사용합니다. 포인트 사용량은 입력, 캐시된 입력, 출력 토큰에 대해 각각 별도로 계산됩니다. 피크 시간 외의 모델 호출은 표준 포인트의 50%만 소모합니다. 피크 시간은 월요일~금요일 14:00~18:00(UTC+8)이며, 주말을 포함한 나머지 시간에는 모두 50% 할인된 비피크 요율이 적용됩니다. 지금 바로 시작하세요: z.ai/subscribe
ZCode로 GLM-5.3을 더 활용하기
- 98% 이상의 캐시 적중률 — 반복되는 컨텍스트는 더 낮은 캐시 요율로 청구되어, 유효 토큰이 약 30% 더 많아집니다
- 1.5배 한정 할당량 증가 — 캐시 절감과 함께 적용하면 8월 31일까지 표준 할당량의 최대 180%까지 사용 가능
- 장기 과제 마스터리 — Goal 모드가 목표 달성까지 계획, 코딩, 테스트, 검증을 수행합니다
- Remote Control — WeChat이나 Feishu를 통해 휴대폰에서 장기 실행 과제를 모니터링하고 조종하세요
ZCode 사용해 보기: zcode.z.ai
GLM-5.3 로컬 서빙
GLM-5.3의 모델 가중치는 출시 후 2주 이내에 공개될 예정입니다.