DeepSeek V4.1 Flash: evolução ou revolução?
A DeepSeek lançou o V4.1-Flash em 10 de setembro de 2026. É um modelo multimodal Mixture-of-Experts com 552B de parâmetros e uma janela de contexto de 1M tokens. De acordo com os próprios benchmarks da DeepSeek, ele iguala ou supera o Opus-5.0 em várias tarefas de agentes. Também é barato: a entrada custa US$ 0,15 por milhão de tokens fora do horário de pico, e a saída custa US$ 0,60. Isso é aproximadamente 4x mais barato que o DeepSeek V4-Pro para entrada e 3x mais barato para saída.
O modelo está disponível agora em vega.chat e pela API api.vega.chat.
Arquitetura
O DeepSeek-V4.1-Flash usa uma arquitetura Causal Encoder-Decoder (CED): um Transformer de 40 camadas dividido entre um codificador causal de 20 camadas e um decodificador de 20 camadas. O cache KV do decodificador é projetado a partir dos estados ocultos finais do codificador, em vez de partir dos estados ocultos de cada camada do próprio decodificador. Isso permite que o modelo ative apenas 8B parâmetros por token durante o prefill e 16B durante a decodificação.
A camada MoE tem 1 especialista compartilhado e 384 especialistas roteados, ativando 6 especialistas roteados por token. O modelo processa imagens e texto nativamente por meio de um codificador visual (DeepSeek-ViT, treinado do zero com 2D-RoPE) e um projetor MLP de duas camadas.
A DeepSeek treinou o modelo do zero com um corpus multimodal de 45T tokens, usando atenção esparsa com comprimento de sequência de 64K e ampliando o contexto para 1M tokens com 34T tokens. O pipeline de pós-treinamento segue SFT, RL e destilação on-policy, sem mudanças algorítmicas. O trabalho substancial foi direcionado ao pipeline de dados: síntese automatizada em grande escala de tarefas e ambientes para agentes, com escalonamento progressivo de dados, tarefas e rollouts.
Desempenho: nível Opus a preços de Flash
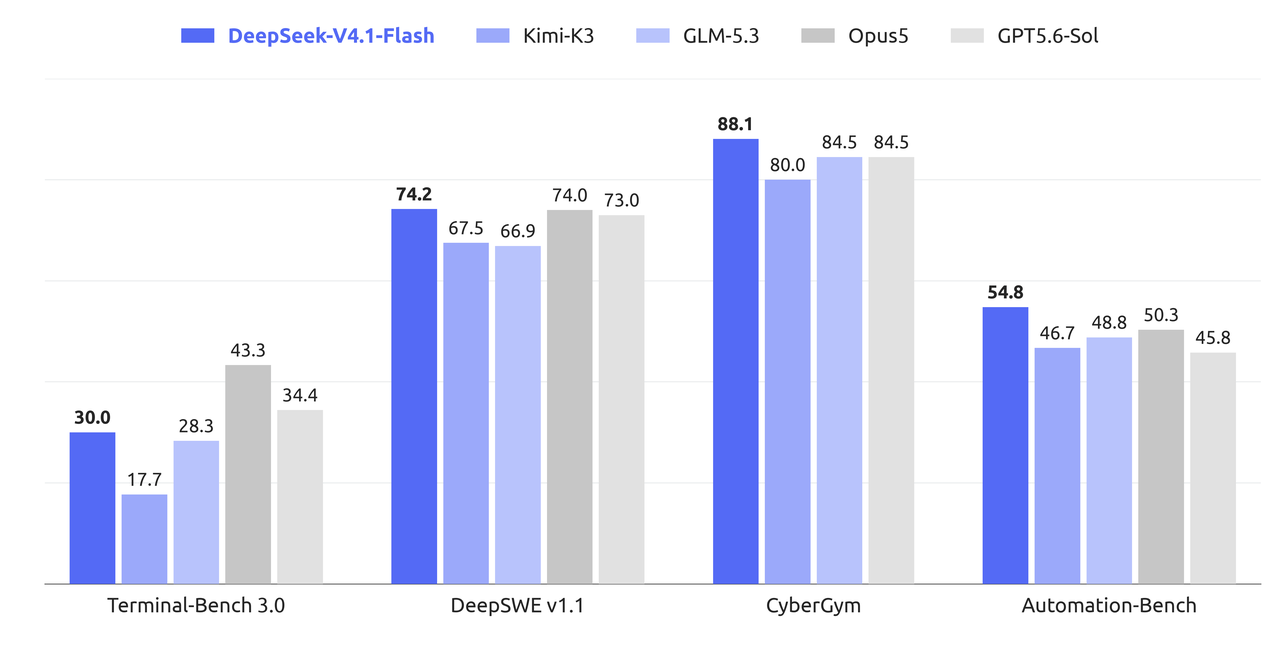
Os benchmarks da própria DeepSeek colocam o V4.1-Flash no nível do Opus-5.0 e à frente dele em várias tarefas de agentes. No Terminal-Bench 2.1, o V4.1-Flash obtém 90.6, superando os 89.1 do Opus-5.0. No DeepSWE v1.1, obtém 74.2, à frente dos 74.0 do Opus. No Agent's Last Exam, obtém 31.8, o melhor resultado entre todos os modelos comparados, incluindo Opus, GPT-5.6 Sol, K3, GLM-5.3 e V4-Pro. No Codeforces, alcança uma classificação de 3471, também a mais alta da comparação. No AutomationBench, obtém 54.8, novamente o melhor resultado.
A tabela completa de benchmarks abrange tarefas de raciocínio, de agentes e visuais em sete modelos. O V4.1-Flash ocupa o primeiro lugar no Terminal-Bench 2.1, DeepSWE v1.1, Codeforces, CyberGym, HLE com ferramentas, AutomationBench e Agent's Last Exam.
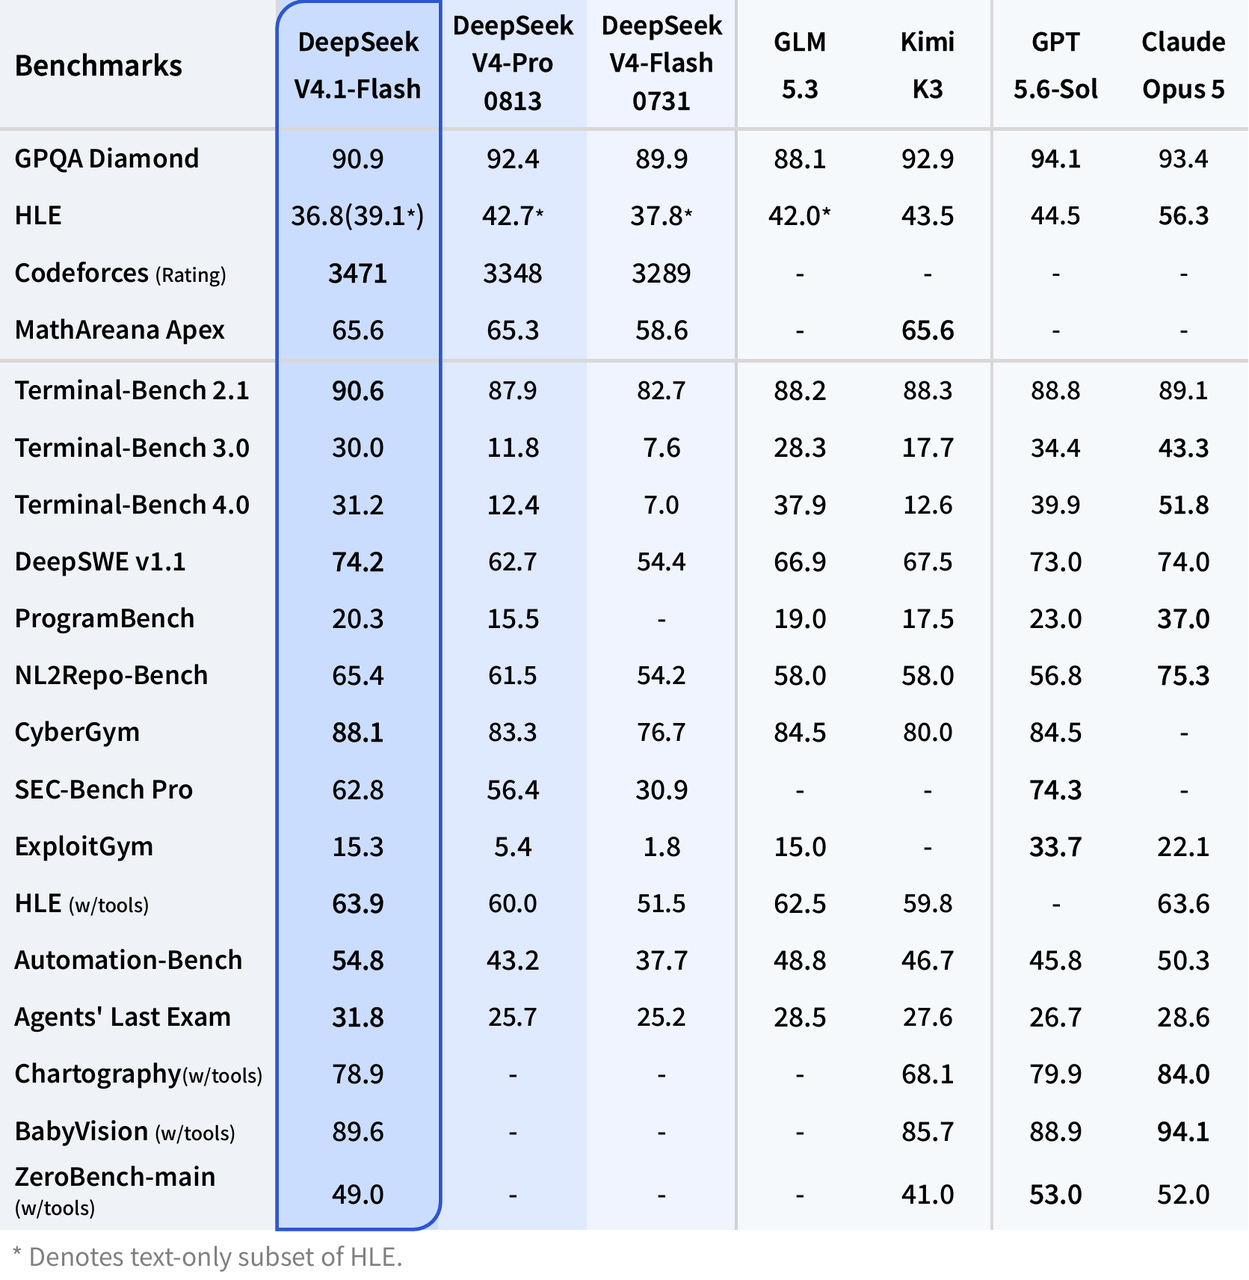
A DeepSeek observa que testes realizados por várias partes colocam o V4.1-Flash à frente do V4-Pro em desempenho, custo, velocidade e tempo total de execução. A empresa está descontinuando gradualmente o V4-Pro. A partir de 14 de setembro de 2026, todas as solicitações à API deepseek-v4-pro serão encaminhadas ao V4.1-Flash, com as tarifas do V4.1-Flash, até o lançamento do V4.1-Pro.
Cache KV: 4x menor
O modelo usa Compressed Sparse Attention 2 (CSA2), que atribui a cada camada de atenção um de três modos estáticos: Full, Reindex ou Reuse. Isso compartilha o KV principal e o K do indexador entre camadas e reutiliza os índices de atenção esparsa Top-K. Combinado com o cache KV principal em FP4 (formato E2M1, uma escala E4M3 a cada 16 canais), o espaço ocupado pelo cache KV global cai para 890 bytes por token. Isso corresponde a aproximadamente 1/4 do DeepSeek V4-Flash e 1/437 do DeepSeek V1.
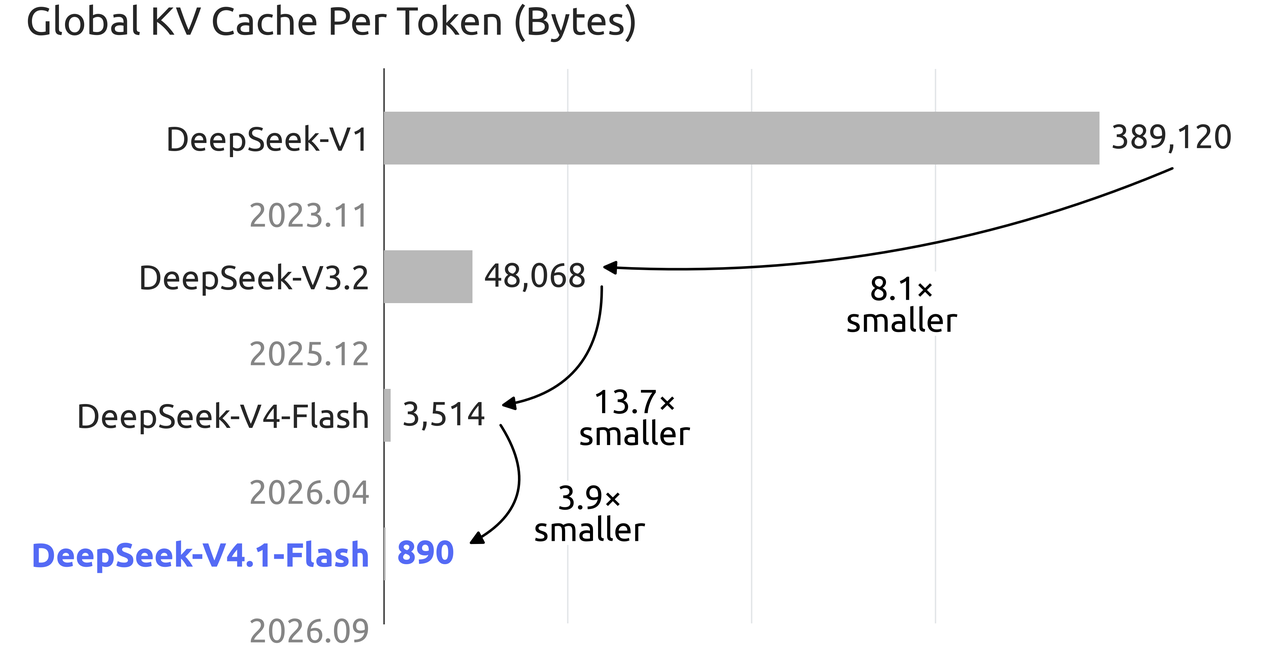
As cobranças por acerto de cache costumam representar uma grande parte dos custos dos agentes. Comprimir o cache reduz esses custos diretamente. Em comparação com a geração anterior, o V4.1-Flash precisa de 1/4 da HBM e 1/8 do armazenamento SSD para seu cache KV.
Preços
O V4.1-Flash adota preços de pico e fora do pico. As tarifas fora do pico correspondem a 50% das tarifas de pico. Os novos preços entraram em vigor às 04:00 UTC de 10 de setembro de 2026.
| Tipo de token | Fora do pico (por 1M) | Pico (por 1M) |
|---|---|---|
| Entrada (acerto de cache) | $0.003 | $0.006 |
| Entrada (erro de cache) | $0.15 | $0.30 |
| Saída | $0.60 | $1.20 |
Para comparação, o V4-Pro cobra US$ 0,66 por 1M de tokens de entrada (fora do pico, erro de cache) e US$ 1,98 por 1M de tokens de saída (fora do pico). O V4.1-Flash é aproximadamente 4x mais barato para entrada e 3x mais barato para saída, enquanto iguala ou supera o V4-Pro nos benchmarks.

Tarefas do dia a dia, agentes e vibe-coding
O V4.1-Flash foi desenvolvido para cargas de trabalho de agentes com alto volume de entrada. Os 8B parâmetros ativos durante o prefill tornam barato processar contextos longos, onde se acumulam os custos dos agentes. A janela de contexto de 1M tokens e o suporte multimodal nativo (texto e imagens) permitem que ele leia documentos extensos, bases de código e entradas visuais de uma só vez.
O modelo oferece uma configuração de esforço de raciocínio ajustável continuamente (inteiro de 1 a 100), que equilibra o custo de inferência e a precisão. Níveis de esforço mais baixos reduzem a quantidade de tokens para consultas mais simples. Níveis mais altos acrescentam etapas de raciocínio para problemas complexos. Isso o torna prático para conversas do dia a dia e perguntas rápidas, não apenas para ciclos intensivos de agentes.
Nos benchmarks de agentes, o modelo registra seus melhores resultados: Terminal-Bench 2.1 (90.6), DeepSWE v1.1 (74.2), Agent's Last Exam (31.8) e AutomationBench (54.8). Ele oferece suporte a chamadas de ferramentas, saída JSON e à Responses API. Os parceiros oficiais da DeepSeek, WorkBuddy (incluindo CodeBuddy) e OpenCode, agora oferecem suporte completo ao V4.1-Flash.
Para vibe-coding, a classificação de 3471 no Codeforces e a pontuação de 74.2 no DeepSWE v1.1 colocam o V4.1-Flash no topo da comparação, à frente do Opus-5.0 e do GPT-5.6 Sol. Combinado ao preço baixo e ao contexto de 1M, isso faz dele um forte modelo padrão para agentes de programação que operam por longas sessões e acumulam grandes janelas de contexto.
Experimente o DeepSeek V4.1-Flash em vega.chat
O DeepSeek V4.1-Flash está disponível agora em vega.chat e pela API api.vega.chat. Você pode testá-lo na interface de chat, comparar suas respostas lado a lado com as de outros modelos ou integrá-lo às suas aplicações pela API compatível com OpenRouter em api.vega.chat.