GLM-5.3: Código de Fronteira com Capacidades Cibernéticas Emergentes
No GLM-5.3, o que fizemos foi escalar o pós-treinamento — e nada mais. Com o GLM-5.2 montamos a stack: IndexShare para processamento eficiente de contexto longo, SAO para RL em tarefas de horizonte longo e slime para treinamento assíncrono em larga escala — tudo rodando sobre os ambientes de tarefas de horizonte longo que vínhamos acumulando. No último mês continuamos escalando essa stack: mais ambientes, tarefas mais diversificadas e mais compute dedicado ao treinamento.
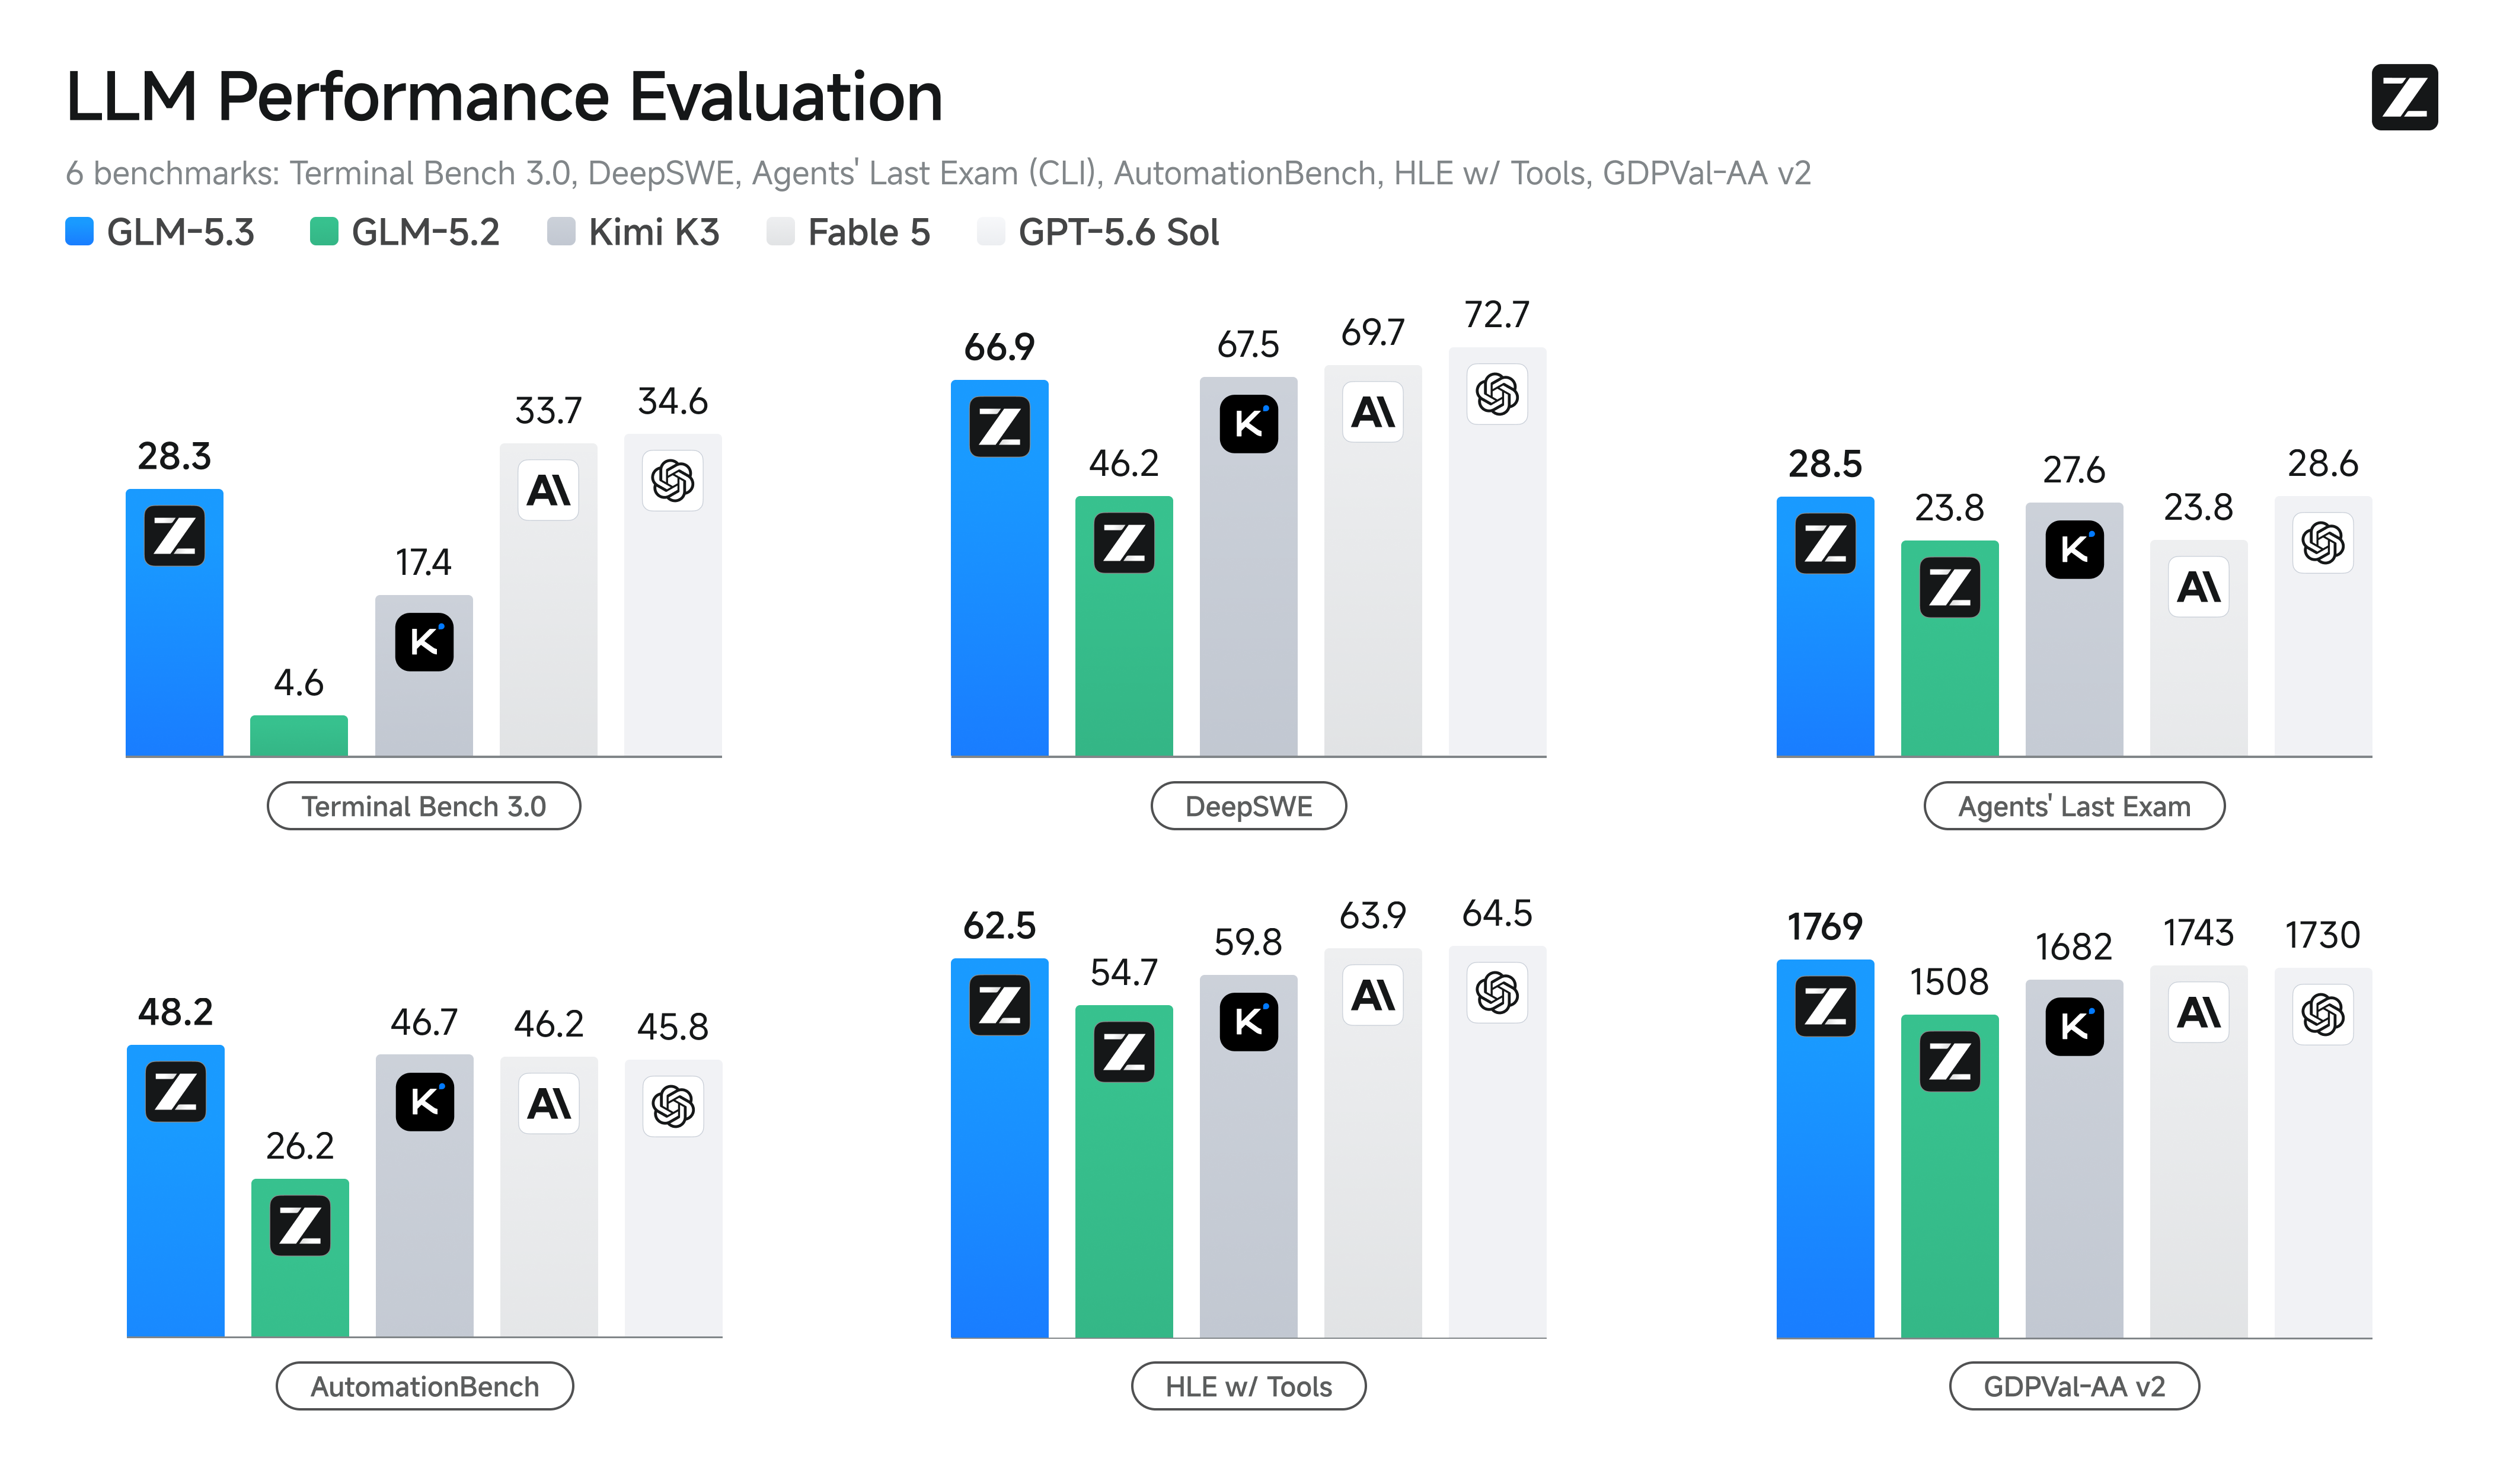
Hoje estamos lançando o GLM-5.3. Ele usa exatamente o mesmo modelo-base do GLM-5.2 — todo ganho vem do pós-treinamento. Em comparação com o GLM-5.2, está bem melhor em coding complexo e tarefas de horizonte longo:
- Coding mais robusto: O GLM-5.3 é o modelo open-weights mais capaz para código que existe hoje, com uma melhoria de 50% sobre o GLM-5.2 no nosso Z.ai Code Bench interno. Também alcança SOTA open-source em benchmarks públicos como Terminal Bench 3.0 e Agents' Last Exam.
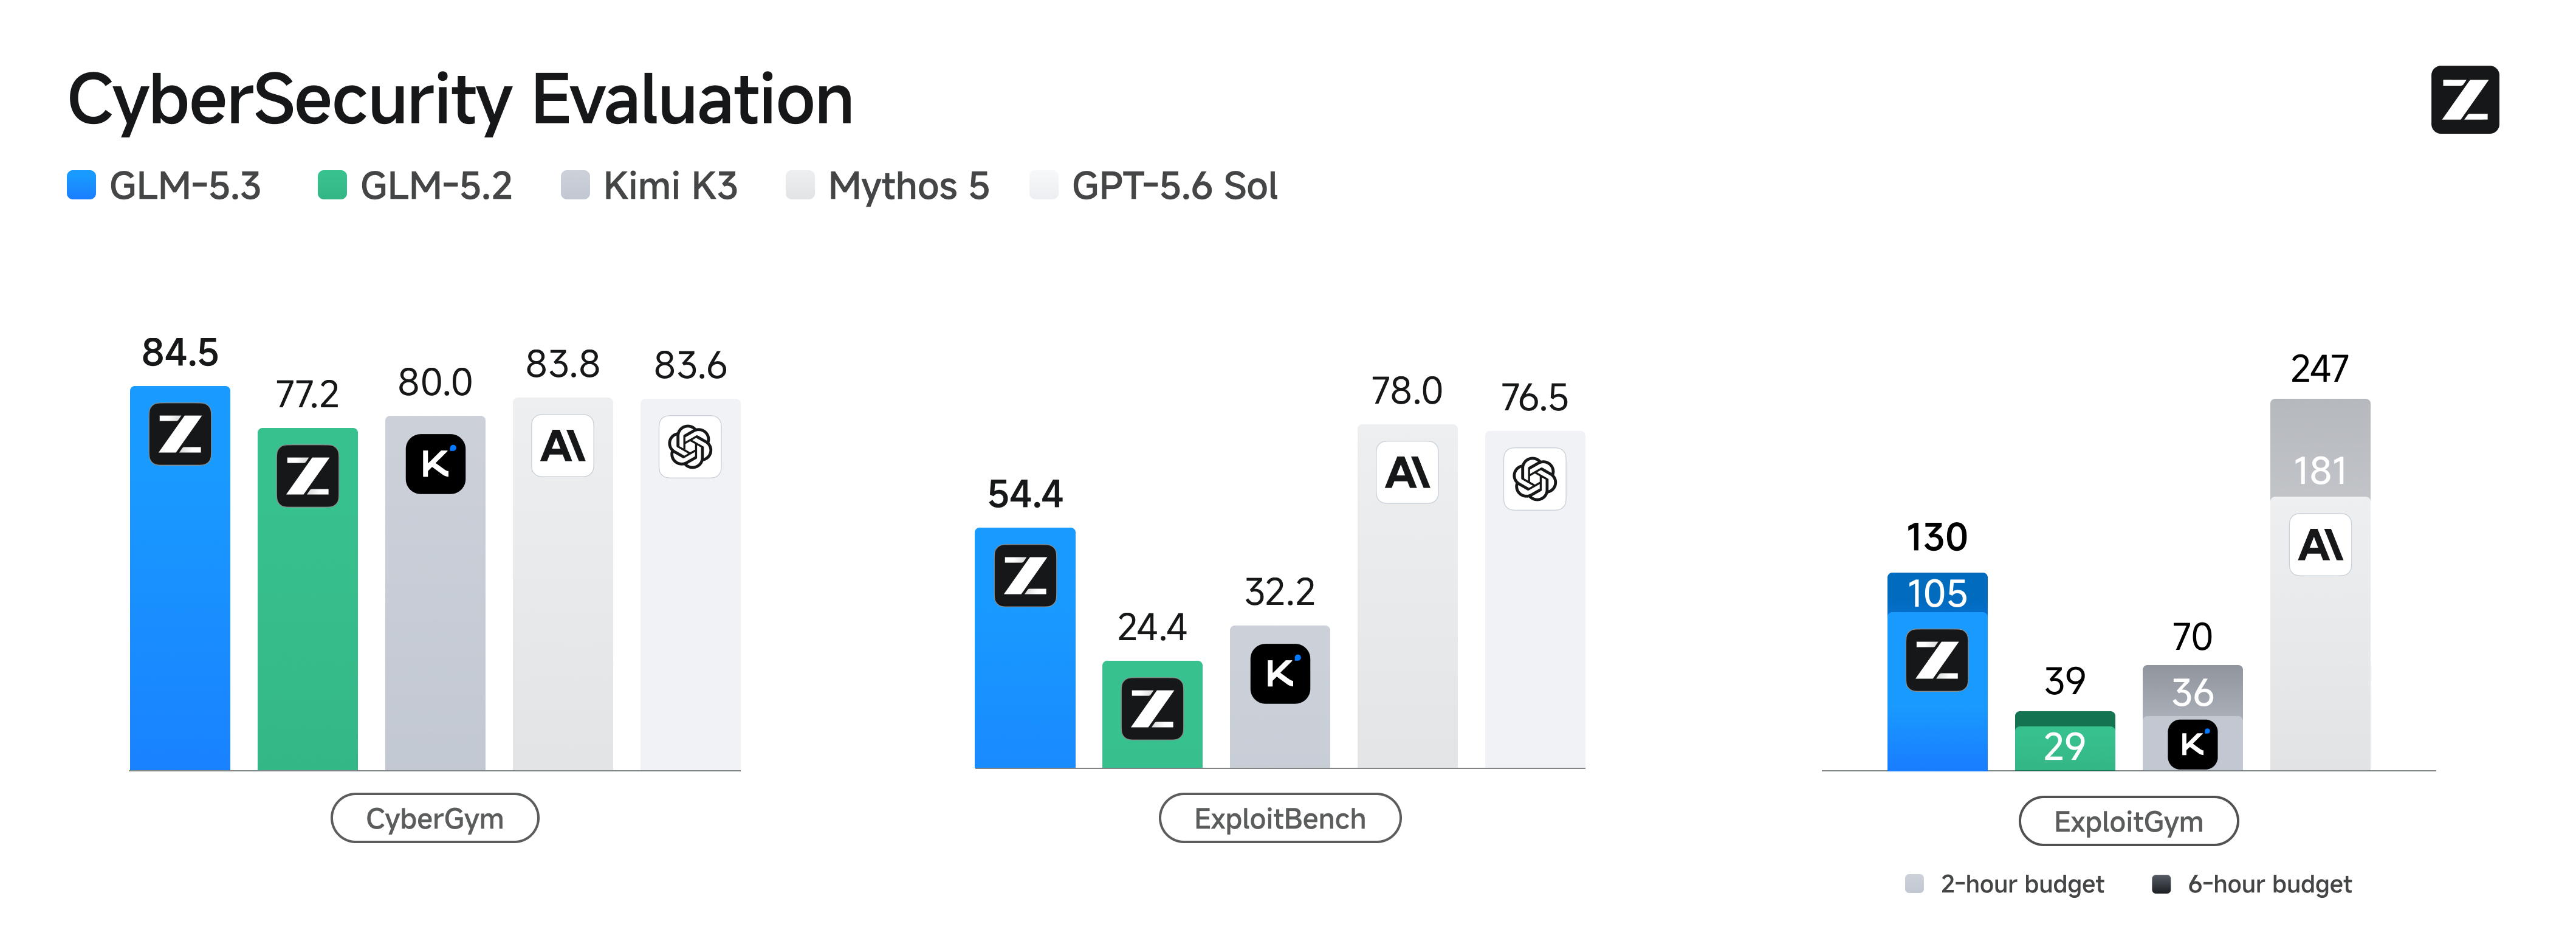
- Capacidade cibernética emergente: Conforme escalamos o pós-treinamento, a capacidade cibernética se desenvolveu mais rápido do que esperávamos. O GLM-5.3 é estado da arte no CyberGym para descoberta de vulnerabilidades, e os ganhos são maiores quanto mais adiante na cadeia de exploração — onde chega a mais que dobrar o GLM-5.2 em benchmarks de exploração.
- Open Source: Vamos liberar os pesos em duas semanas após o lançamento, assim que a avaliação de segurança e o hardening estiverem concluídos.
Capacidade Cibernética Emergente
Como parte do pós-treinamento, introduzimos dados e ambientes de descoberta de vulnerabilidades no mix de treinamento. A expectativa era tornar o modelo melhor em encontrar e raciocinar sobre vulnerabilidades. O que nos surpreendeu foi o quanto essa capacidade ultrapassou a meta.
Avaliamos o GLM-5.3 em três benchmarks que cobrem diferentes estágios da análise e exploração de vulnerabilidades. No CyberGym, que parte de código-fonte white-box e testa se o modelo consegue identificar e validar vulnerabilidades disparando falhas, o GLM-5.3 marca 84,5%, ante 77,2% do GLM-5.2 — o melhor resultado do benchmark, à frente do Mythos 5 (83,8%) e do GPT-5.6 Sol (83,6%). No ExploitBench, que exige raciocínio mais profundo sobre vulnerabilidades reais e sua exploração, o GLM-5.3 chega a 54,4%, mais que dobrando os 24,4% do GLM-5.2, enquanto Mythos 5 e GPT-5.6 Sol marcam 78,0% e 76,5%, respectivamente. No ExploitGym, que mede quantas tarefas de exploração um modelo consegue completar dentro de orçamentos normalizados por tempo, o GLM-5.3 completa 105 tarefas em duas horas e 130 em seis horas, contra 29 e 39 do GLM-5.2. O Mythos 5 segue bem à frente, com 181 e 247 tarefas. O padrão entre os três é consistente: quanto mais adiante na cadeia de exploração um benchmark está, maior o ganho sobre o GLM-5.2 — e também maior a distância restante até a fronteira fechada. A capacidade está crescendo mais rápido justamente onde estamos mais atrás.
Depois testamos se essas capacidades se transferem para além de benchmarks controlados. Desde o GLM-5.2, temos trabalhado com várias equipes de segurança na China para rodar nossos modelos contra codebases reais. Após revisão por especialistas, triagem e deduplicação, o modelo identificou 2.436 vulnerabilidades em 269 projetos, incluindo 1.097 problemas de severidade média a alta. Os achados abrangem kernels de sistema, sistemas operacionais, motores de navegador, infraestrutura open-source, aplicações web e protocolos de rede. Muitas permaneceram despercebidas por anos ou até décadas, com a mais antiga remontando a cerca de 40 anos.
Esse trabalho desde então se transformou num esforço contínuo de disclosure. Construímos o Z.ai Security Disclosure Ledger para manter um registro público dos achados conforme avançam pelo processo de disclosure. O ledger é atualizado continuamente à medida que novas vulnerabilidades são revisadas e divulgadas, distinguindo problemas já tornados públicos daqueles que ainda estão em disclosure. Para problemas divulgados, registra informações como o projeto afetado, severidade, CVE quando disponível e por quanto tempo a vulnerabilidade permaneceu na codebase.
slime: Feito para Escalar RL de Horizonte Longo
Tudo isso roda no slime, nosso framework open-source de pós-treinamento para escalonamento de RL, com Megatron do lado do treinamento e SGLang do lado do rollout. Seu design mantém treinamento, rollout e o buffer de dados num único dataflow, de modo que matemática, código, sandboxes, verificadores e ambientes agênticos de horizonte longo se conectam como geração de dados em vez de mudanças no loop de treinamento. Foi isso que nos permitiu continuar adicionando ambientes ao longo do GLM-5.2 e do GLM-5.3 sem reconstruir a stack de treinamento a cada vez.
No GLM-5.3 seguimos desenvolvendo o slime em duas frentes. No lado algorítmico, adicionamos capacidades voltadas à pesquisa em RL: top-p mask, OPD com top-k e vocabulário completo, além de configurações que melhoram a consistência entre treinamento e rollout — incluindo setups no estilo R3 e alinhamento numérico total entre os caminhos de treinamento e rollout. Isso nos dá controle mais fino sobre sampling, treinamento e sinais de teacher, e torna rápido rodar comparações controladas. Na nossa avaliação de consistência treinamento–rollout, a diferença média nas log probabilities (logprob) ficou controlada no nível de 1e-7, uma redução de mais de 99,99% em comparação com setups anteriores.
Também trabalhamos em eficiência de recursos e throughput do sistema para RL em larga escala. O armazenamento local agora funciona como uma camada adicional de cache, mantendo estados do modelo e dados de forma hierárquica que de outra forma ficariam na memória do host. Isso importa mais para OPD multi-teacher: com troca dinâmica de teachers e prefetching do lado do treinamento, vários teachers podem ser usados sem levantar um serviço de inferência dedicado e de longa duração para cada um, com overhead adicional limitado e consumo de recursos consideravelmente menor. Para workloads agênticos e assíncronos, melhoramos o escalonamento conjunto e o balanceamento de carga entre o router e o slime, de forma que requisições de rollout com comprimentos e tempos de conclusão bastante variados aproveitem melhor os recursos de inferência. Adicionamos heurísticas workload-aware que derivam configurações orientadas a throughput — razão de recursos prefill/decode, configurações de concorrência e outros parâmetros críticos para throughput — a partir das características de cada ambiente de rollout. Como resultado, para tarefas de RL de coding de horizonte longo, essas otimizações em nível de sistema melhoraram o throughput de treinamento RL end-to-end em mais de 2,3×, permitindo escalar o treinamento sobre trajetórias mais longas e ambientes mais complexos com eficiência bem maior.
No conjunto, tudo isso nos dá mais flexibilidade experimental, menor custo de recursos e throughput mais alto — o que torna prático continuar escalando RL.
Começando com o GLM-5.3
Mudanças na API do GLM-5.3
O GLM-5.3 suporta três níveis de thinking effort: low, high e max. Desativar o thinking não é mais suportado pelo GLM-5.3.
| Parameter | Values | Default | Description |
|---|---|---|---|
| thinking.type | enabled | enabled | Enables thinking. disabled is no longer supported. |
| reasoning_effort | low, high, max | max | low: light; high: enhanced; max: deep. max is recommended for coding tasks. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
Migração necessária: Se sua aplicação usa atualmente thinking.type: "disabled", altere para enabled e defina reasoning_effort como low antes de atualizar o ID do modelo para glm-5.3. Caso contrário, a requisição vai falhar.
Use o GLM-5.3 com o GLM Coding Plan & ZCode
Experimente o GLM-5.3 nos seus agentes de coding favoritos — ZCode, Claude Code, OpenCode e outros. Veja a visão geral do devpack.
Para assinantes do GLM Coding Plan: Já liberamos o GLM-5.3 para todos os usuários do GLM Coding Plan. O novo GLM Coding Plan agora usa um sistema de cota baseado em pontos. O consumo de pontos é calculado separadamente para tokens de input, input em cache e output. Chamadas de modelo feitas fora do horário de pico consumem 50% dos pontos padrão. Os horários de pico são 14:00–18:00 (UTC+8), de segunda a sexta-feira; todos os demais horários, incluindo finais de semana, recebem a taxa de 50% fora do pico. Comece a construir agora: z.ai/subscribe
Tire mais do GLM-5.3 com o ZCode
- Cache hit rate de 98%+ — contexto repetido faturado na tarifa de cache mais baixa, ~30% mais tokens efetivos
- Bônus de cota por tempo limitado de 1,5× — combine com a economia de cache para até 180% da sua cota padrão até 31 de agosto
- Domínio de horizonte longo — o modo Goal planeja, codifica, testa e verifica até que o alvo seja atingido
- Remote Control — monitore e conduza tarefas de longa duração pelo seu celular via WeChat ou Feishu
Experimente o ZCode: zcode.z.ai
Sirva o GLM-5.3 Localmente
Os pesos do modelo do GLM-5.3 estarão disponíveis publicamente em breve, dentro de duas semanas a partir do lançamento.