GPT Image 2.5: imagens mais nítidas e rápidas
Toda semana, as pessoas criam mais de 3 bilhões de imagens no ChatGPT Images e nos modelos GPT Image disponíveis na API. Em 8 de setembro de 2026, a OpenAI lançou o ChatGPT Images 2.5, a nova versão do seu modelo de imagens. Ele produz iluminação mais natural e texturas mais ricas, preserva com mais confiabilidade os elementos principais de fotos de referência e segue melhor as instruções de edição ao longo de várias interações. A latência caiu até 50% em comparação com o Images 2.0.
Para desenvolvedores, a API ganha dois novos modelos. GPT Image 2.5 Flare é o modelo pequeno, otimizado para velocidade, com qualidade de imagem comparável à do GPT Image 2. GPT Image 2.5 Sunburst é o modelo base, otimizado para qualidade, com qualidade de imagem superior à do GPT Image 2. Ambos compartilham as melhorias em edição precisa e preservação dos elementos principais.
O que mudou na qualidade da geração
O Images 2.5 trabalha melhor com fotos de referência. Quando você fornece uma imagem de uma pessoa, de um lugar ou de um objeto, o modelo mantém as características reconhecíveis em novos cenários e estilos com mais consistência. A iluminação e as texturas parecem mais naturais, e há mais chances de que os detalhes distintivos permaneçam após a transformação.
O modelo também lida melhor com instruções visuais complexas. Imagens que incluem informações do mundo real têm conteúdo mais preciso. Ele consegue trabalhar com layouts mais complexos, inclusive fundos transparentes, e reproduz os estilos visuais com mais fidelidade, mantendo os resultados mais próximos do que você pediu.
Edição precisa e consistência em várias interações
É na edição que o Images 2.5 apresenta os maiores ganhos práticos. O modelo é melhor em alterar apenas o que você pediu, mantendo o restante intacto, mesmo com elementos principais e fundos complexos. Na API, isso permite atualizar um único elemento (um produto, um fundo, um texto publicitário) preservando o elemento principal, a composição e a identidade visual da marca ao redor.
Em conversas mais longas no ChatGPT, as alterações feitas anteriormente têm mais chances de continuar consistentes. Cada nova edição se baseia no trabalho anterior sem degradar a qualidade da imagem ao longo do tempo. O guia de prompting da OpenAI observa uma ressalva: edições repetidas ainda podem alterar detalhes que você pretendia preservar. Reafirme essas restrições a cada interação e inspecione todos os resultados. Se uma região precisar permanecer idêntica em nível de pixel, componha a edição aprovada na imagem original em vez de confiar apenas no prompt.
Novos recursos no ChatGPT
Sketch é um novo recurso que permite desenhar diretamente no ChatGPT e usar o desenho como guia visual. Você pode esboçar a planta de um cômodo, o contorno de uma roupa ou um rabisco simples, e o ChatGPT transforma isso em uma imagem completa. Adicione uma descrição do estilo e dos detalhes que quiser. Para experimentar, digite "@Sketch" no ChatGPT. Você não precisa ser um artista profissional; é apenas mais uma maneira de chegar mais perto da imagem que tem em mente.
Os modelos prontos abrangem formatos criativos populares, como pôsteres e produtos promocionais. Em vez de começar com uma tela em branco, você escolhe um modelo e adiciona as informações, os elementos de design e os estilos que quiser.
Agora você pode compartilhar uma imagem junto com o prompt que a criou. Outra pessoa pode partir da mesma ideia, incluir suas próprias fotos e detalhes e criar uma versão com a sua cara.
Os dois modelos da API
GPT Image 2.5 Flare é a opção padrão para a maioria dos aplicativos. Ele produz imagens de qualidade superior à do GPT Image 2 com 50% menos latência. É ideal para conteúdo de criadores e redes sociais, experiências com produtos, busca visual, prototipagem rápida e geração em grande volume.
GPT Image 2.5 Sunburst foi desenvolvido para fluxos de trabalho visuais premium que se beneficiam de um controle mais preciso durante as edições. Use-o para criar peças de campanha prontas para produção ou imagens refinadas de produtos. A geração leva mais tempo.
O guia da OpenAI apresenta uma regra simples para escolher. Comece com Flare quando a velocidade for a prioridade. Comece com Sunburst quando os requisitos de qualidade forem exigentes. Quando Sunburst atingir seu padrão de qualidade, teste Flare com os mesmos prompts e entradas. Mude para Flare se ele também atingir esse padrão e melhorar a latência. Continue usando Sunburst quando sua vantagem de qualidade for necessária para o seu fluxo de trabalho.
Parâmetros da API
| Parâmetro | Configurações |
|---|---|
model | gpt-image-2.5-flare (small) ou gpt-image-2.5-sunburst (base) |
quality | auto (padrão), low, medium, high, xhigh ou max |
size | auto ou uma resolução personalizada. Comuns: 1024x1024, 1536x1024, 1024x1536, 2048x2048, 2048x1152, 3840x2160, 2160x3840 |
background | auto, opaque ou transparent |
Para resoluções personalizadas, use WIDTHxHEIGHT. Cada lado deve ter no máximo 3.840 pixels. Ambos os lados devem ser múltiplos de 16. A proporção entre o lado maior e o menor não deve exceder 3:1. O total de pixels deve ficar entre 655.360 e 8.294.400. As saídas com mais de 3.686.400 pixels no total (2560x1440) são experimentais.
Escolha o modelo antes de ajustar quality. Para a primeira comparação, mantenha inalterados o nível de qualidade, o prompt, as imagens de referência e as dimensões. O mesmo rótulo de qualidade não significa a mesma qualidade de imagem nem o mesmo tempo de resposta entre os modelos. Se o resultado não for satisfatório, teste um nível de qualidade mais alto. Quando atender aos seus requisitos, teste níveis mais baixos para ver se mantêm uma qualidade aceitável e reduzem a latência. Use xhigh ou max apenas quando resolverem um requisito de qualidade não atendido dentro do seu orçamento de latência. Uma configuração mais alta não garante um resultado melhor para todos os prompts.
Para recursos com transparência, solicite explicitamente background="transparent" e use PNG ou WebP. Verifique o canal alfa decodificado, incluindo cabelo, vidro, sombras e bordas dos objetos. Use output_compression apenas para JPEG ou WebP, não para PNG.
Fundamentos de prompting
O guia de prompting da OpenAI apresenta oito práticas que funcionam com os dois modelos.
- Defina o resultado. Identifique o elemento principal e o uso pretendido (fotografia de produto, anúncio, diagrama). Especifique a composição, a proporção e as restrições de posicionamento. Para solicitações complexas, organize o prompt em cena, elemento principal, detalhes e restrições.
- Escolha um formato fácil de manter. Prompts curtos, parágrafos descritivos, estruturas semelhantes a JSON, instruções e tags podem expressar a mesma intenção. Escolha o formato que facilite a leitura e a atualização dos requisitos.
- Descreva detalhes visíveis. Identifique materiais, iluminação, cores e o meio visual. Peça explicitamente um resultado "fotorrealista" ou uma "fotografia real" quando esse for o objetivo. Trate as especificações de câmera como indicações de aparência, não como garantia de uma simulação física exata.
- Especifique as pessoas e as ações. Descreva o enquadramento do corpo, a escala relativa, o olhar e a interação com objetos. Instruções como "corpo inteiro visível, incluindo os pés" ou "mãos segurando o guidão naturalmente" deixam a pose mais clara.
- Especifique o texto exato. Coloque entre aspas as palavras que precisam aparecer e descreva sua posição e tipografia. Soletre letras incomuns ou nomes de marcas, uma a uma, quando necessário. Peça para não incluir texto adicional e depois confira a ortografia e a legibilidade do resultado.
- Separe as alterações das restrições. Para edições, diga "altere apenas X" e liste os detalhes que devem ser preservados: identidade, geometria, layout, iluminação, rótulos. Indique o que deve ser excluído, como texto indesejado, logotipos ou marcas d'água.
- Defina o papel das referências. Identifique cada entrada por número e finalidade: elemento principal, estilo, roupa, fundo. Explique como as entradas devem ser combinadas e quais elementos devem ser movidos para cada lugar.
- Itere de forma deliberada. Use o resultado anterior como entrada para a próxima edição, solicite uma alteração e repita os detalhes que devem ser preservados. Compare os resultados antes de acrescentar mais instruções.
Exemplo: controlar o estilo e a iluminação
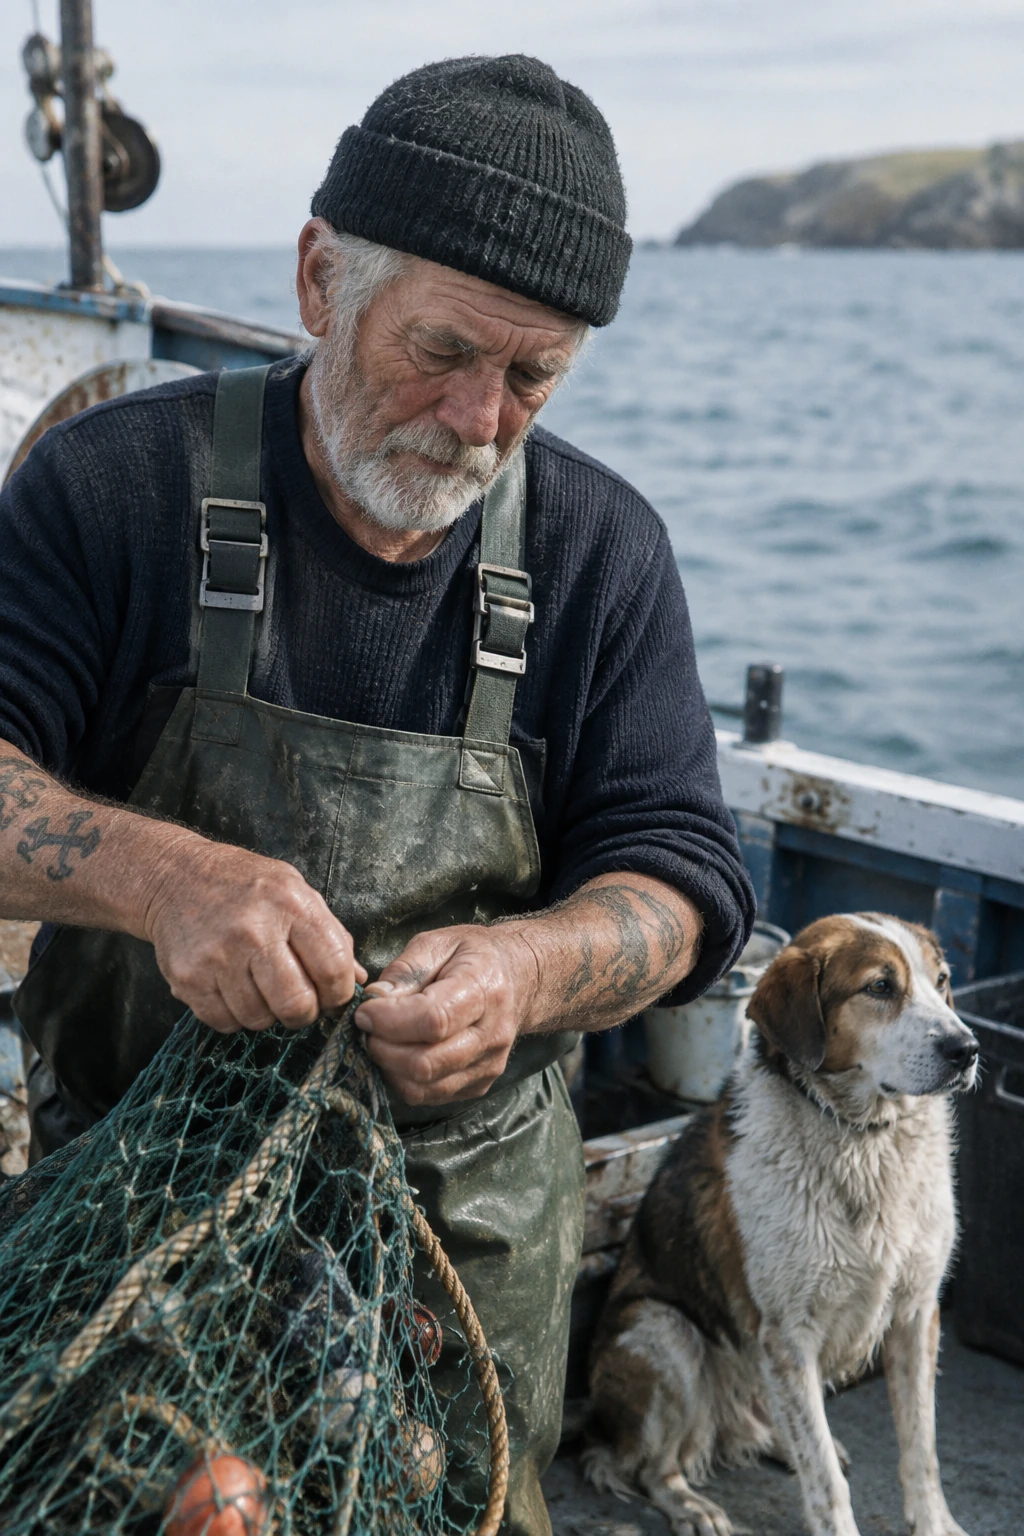
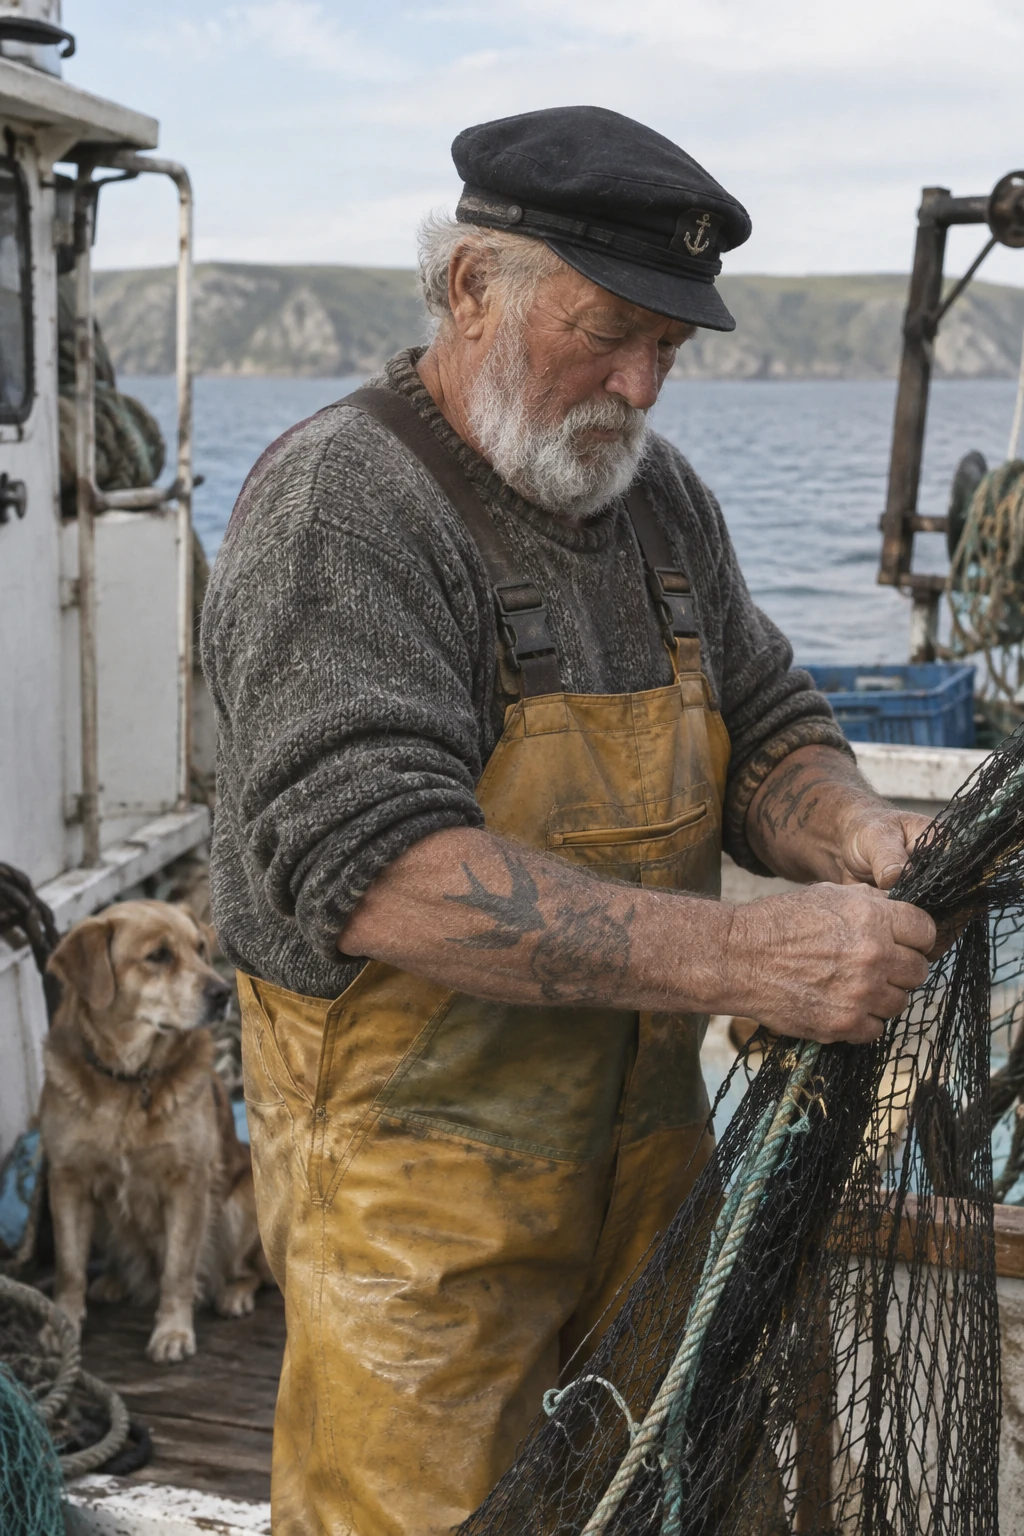
Este prompt pede uma fotografia espontânea e exclui explicitamente retoques pesados. Configurações de geração: size="1024x1536", quality="medium".
Create a photorealistic candid photograph of an elderly sailor standing on a small fishing boat.
He has weathered skin with visible wrinkles, pores, and sun texture, and a few faded traditional sailor tattoos on his arms.
He is calmly adjusting a net while his dog sits nearby on the deck. Shot like a 35mm film photograph, medium close-up at eye level, using a 50mm lens.
Soft coastal daylight, shallow depth of field, subtle film grain, natural color balance.
The image should feel honest and unposed, with real skin texture, worn materials, and everyday detail. No glamorization, no heavy retouching.
Resultado do GPT Image 2.5 Flare:
Resultado do GPT Image 2.5 Sunburst:
Exemplo: renderizar o texto exato
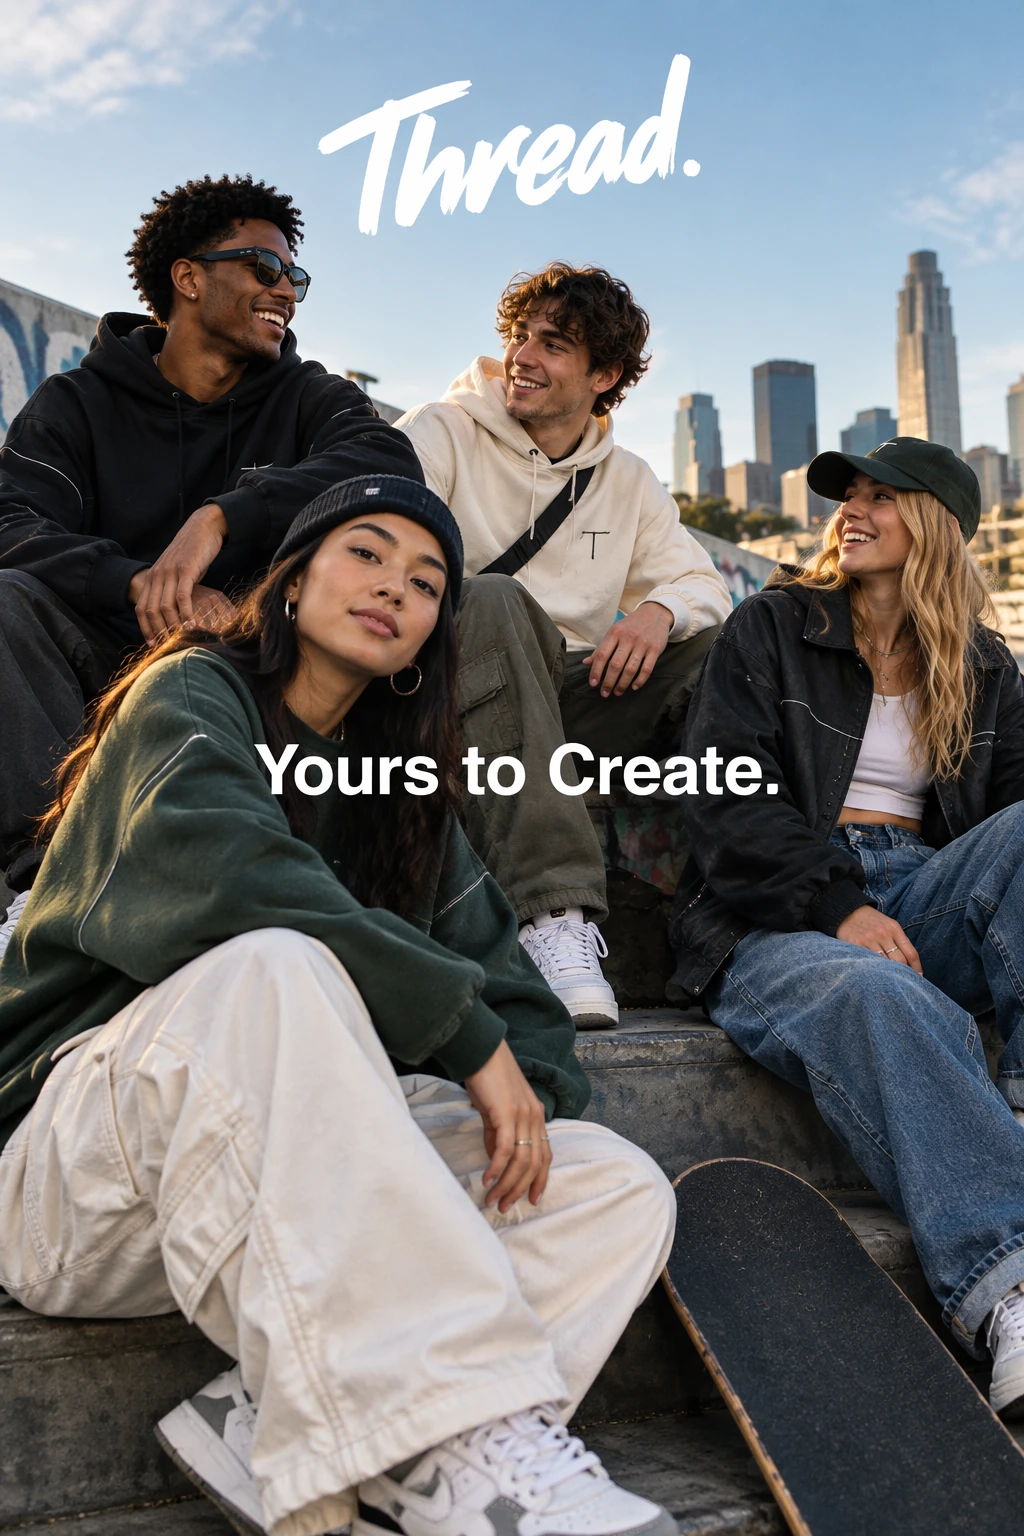
Este prompt pede uma imagem de campanha de moda urbana com um slogan específico, renderizado exatamente uma vez. Configurações de geração: size="1024x1536", quality="medium".
Give me a cool in culture ad / fashion shot for a brand called Thread.
It's a hip young street brand. The ad shows a group of friends hanging out together with the tagline "Yours to Create."
Make it feel like a polished campaign image for a youth streetwear audience: stylish, contemporary, energetic, and tasteful.
Use clean composition, strong color direction, natural poses, and premium fashion photography cues.
Render the tagline exactly once, clearly and legibly, integrated into the ad layout.
No extra text, no watermarks, no unrelated logos.
Resultado do GPT Image 2.5 Flare:
Exemplo: logotipo transparente com background="transparent"
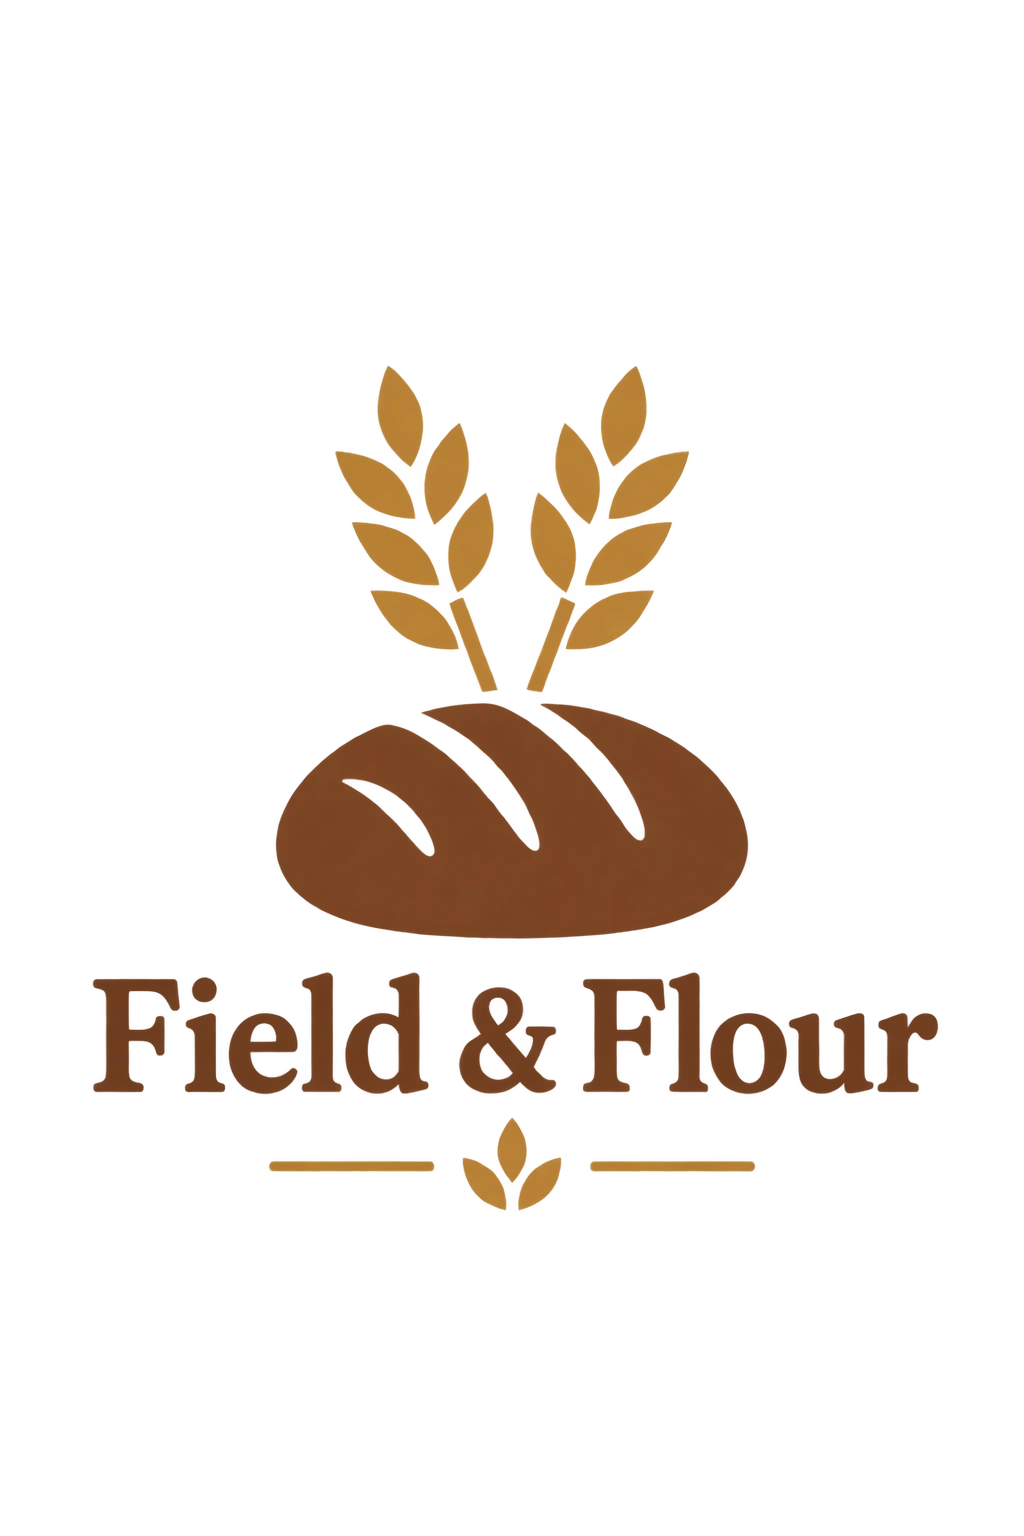
Para recursos com transparência, solicite background="transparent" na API e use PNG ou WebP. Este prompt pede um logotipo de padaria simples sobre um fundo totalmente transparente. Configurações de geração: size="1024x1536", quality="medium", background="transparent", output_format="png", n=1.
Create an original, non-infringing logo for a company called Field & Flour, a local bakery.
The logo should feel warm, simple, and timeless. Use clean, vector-like shapes, a strong silhouette, and balanced negative space.
Favor simplicity over detail so it reads clearly at small and large sizes. Flat design, minimal strokes, no gradients unless essential.
Fully transparent background. Deliver a single centered logo with generous padding, clean alpha edges, and no solid backdrop, scenery, checkerboard, or watermark.
Resultado do GPT Image 2.5 Flare:
Exemplo: manter um personagem consistente em várias cenas
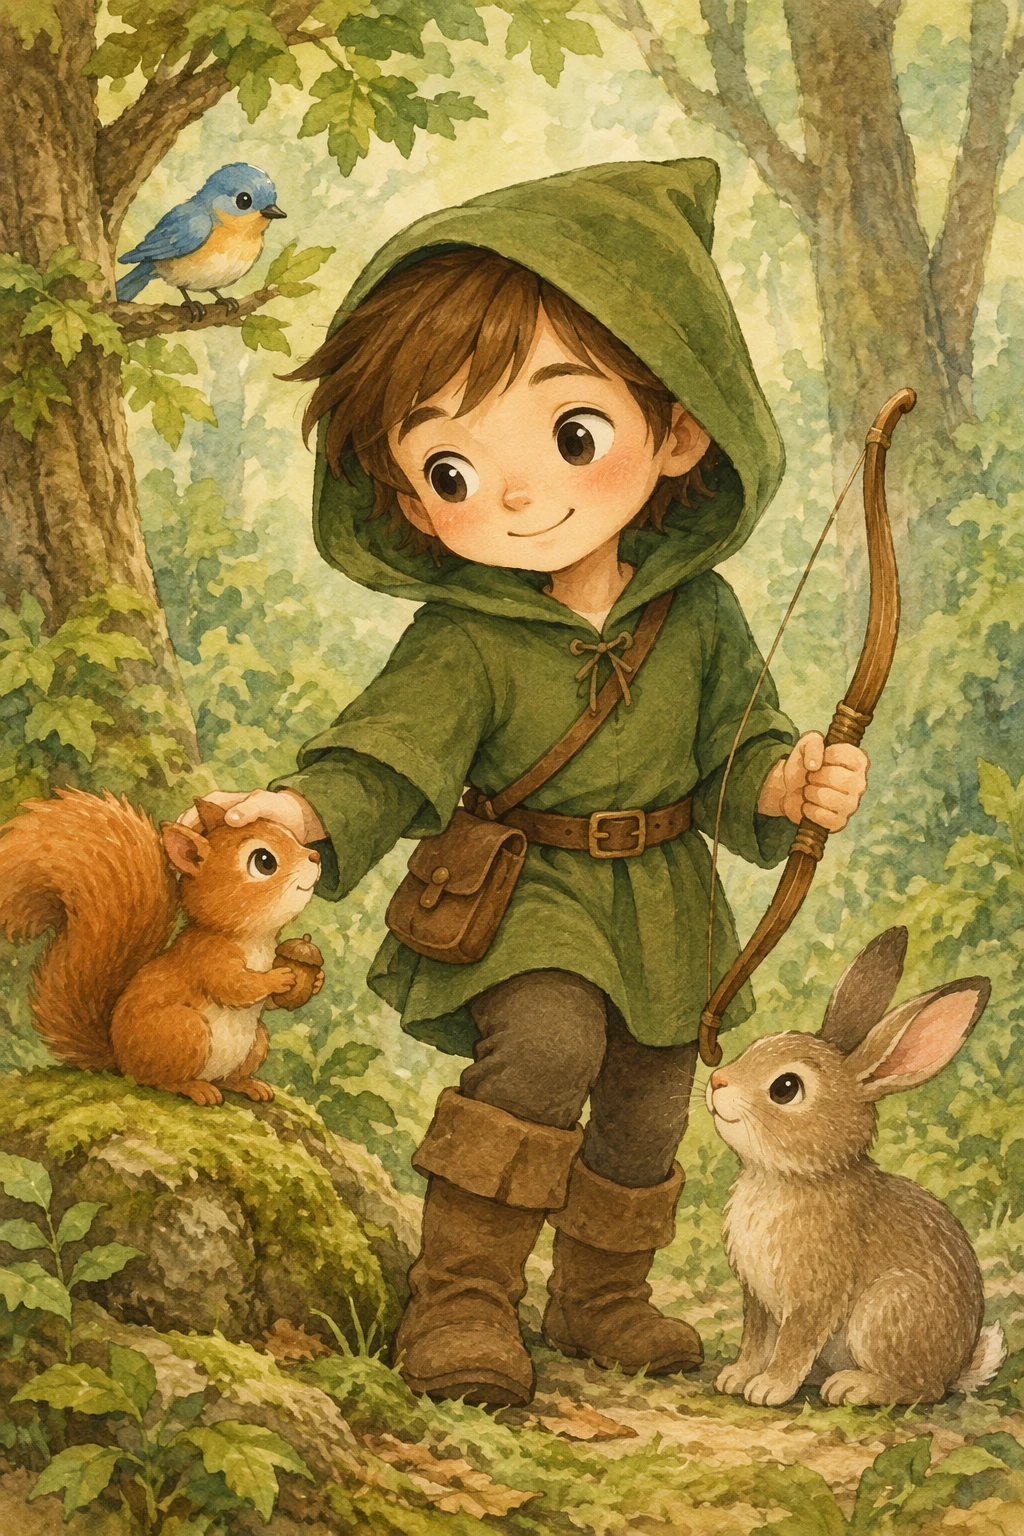
Para um livro com várias ilustrações, crie uma referência reutilizável do personagem e repita os detalhes que o definem a cada interação. Este prompt apresenta o personagem. Configurações de geração: size="1024x1536", quality="medium".
Create a children's book illustration introducing a main character.

Character:
A young, storybook-style hero inspired by a little forest outlaw,
wearing a simple green hooded tunic, soft brown boots, and a small belt pouch.
The character has a kind expression, gentle eyes, and a brave but warm demeanor.
Carries a small wooden bow used only for helping, never harming.

Theme:
The character protects and rescues small forest animals like squirrels, birds, and rabbits.

Style:
Children's book illustration, hand-painted watercolor look,
soft outlines, warm earthy colors, whimsical and friendly.
Proportions suitable for picture books (slightly oversized head, expressive face).

Constraints:
- Original character (no copyrighted characters)
- No text
- No watermarks
- Plain forest background to clearly showcase the character
Resultado do GPT Image 2.5 Flare:
Resultado do GPT Image 2.5 Sunburst:
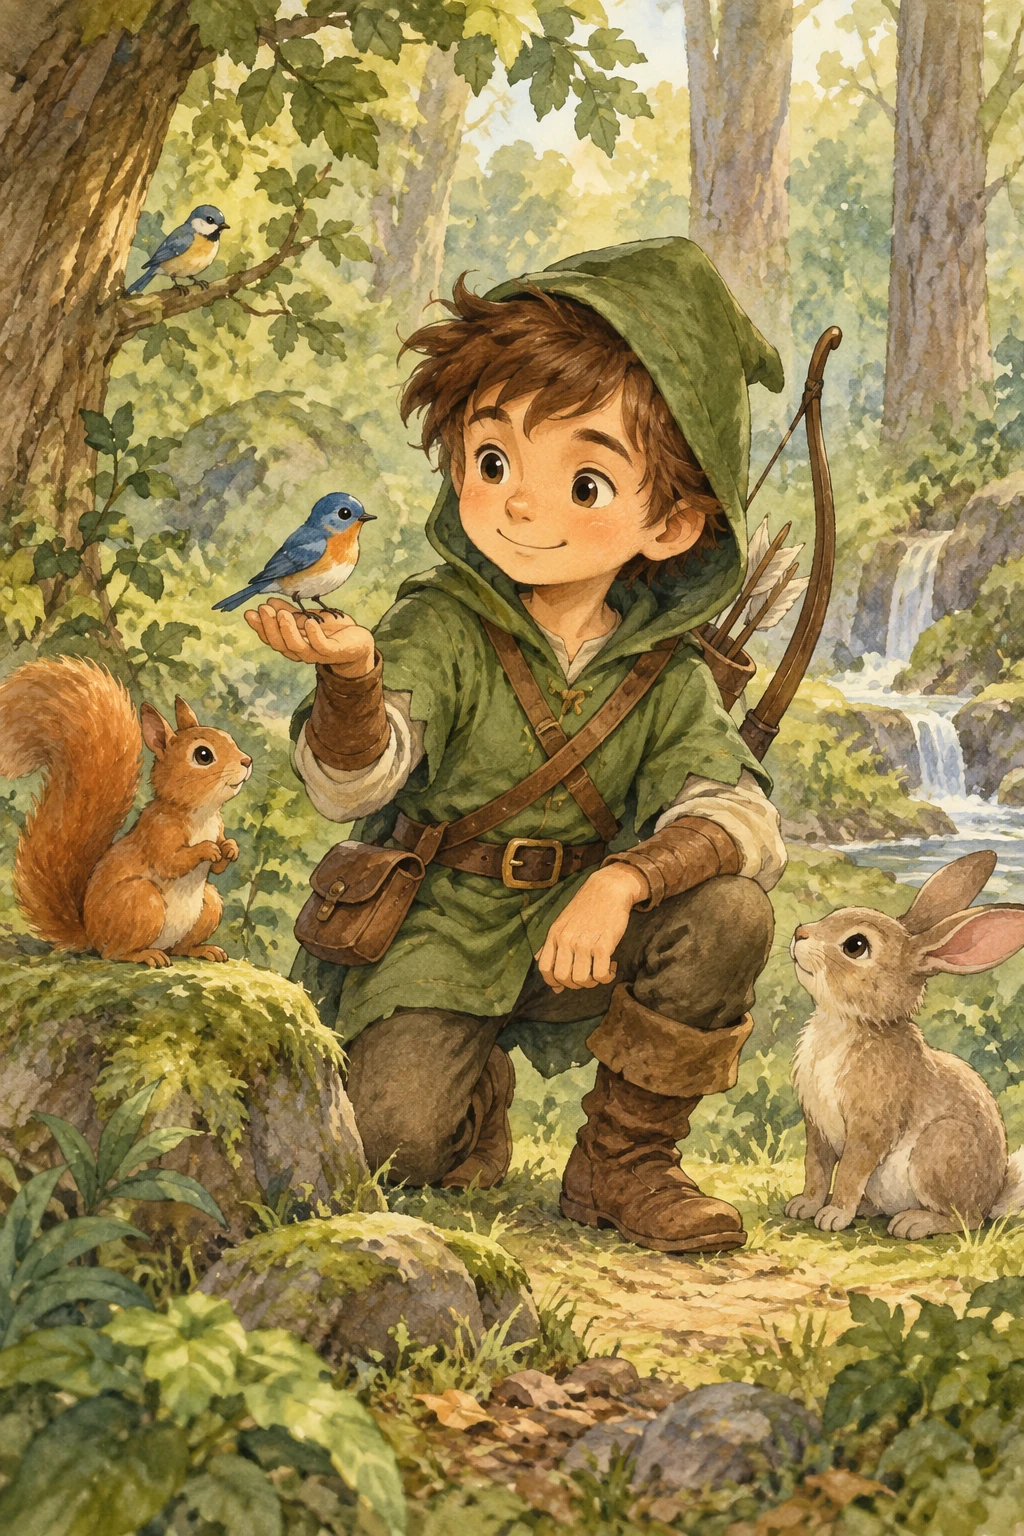
Para continuar a história, use a imagem do personagem gerada como entrada para a próxima edição. Descreva uma nova cena e repita as restrições de aparência para manter a consistência do personagem. O exemplo abaixo mantém o mesmo herói, mas o coloca em uma cena de resgate no inverno.
Continue the children's book story using the same character.

Scene:
The same young forest hero is gently helping a frightened squirrel
out of a fallen tree after a winter storm.
The character kneels beside the squirrel, offering reassurance.

Character Consistency:
- Same green hooded tunic
- Same facial features, proportions, and color palette
- Same gentle, heroic personality

Style:
Children's book watercolor illustration,
soft lighting, snowy forest environment,
warm and comforting mood.

Constraints:
- Do not redesign the character
- No text
- No watermarks
Exemplo: inserir uma pessoa em uma cena
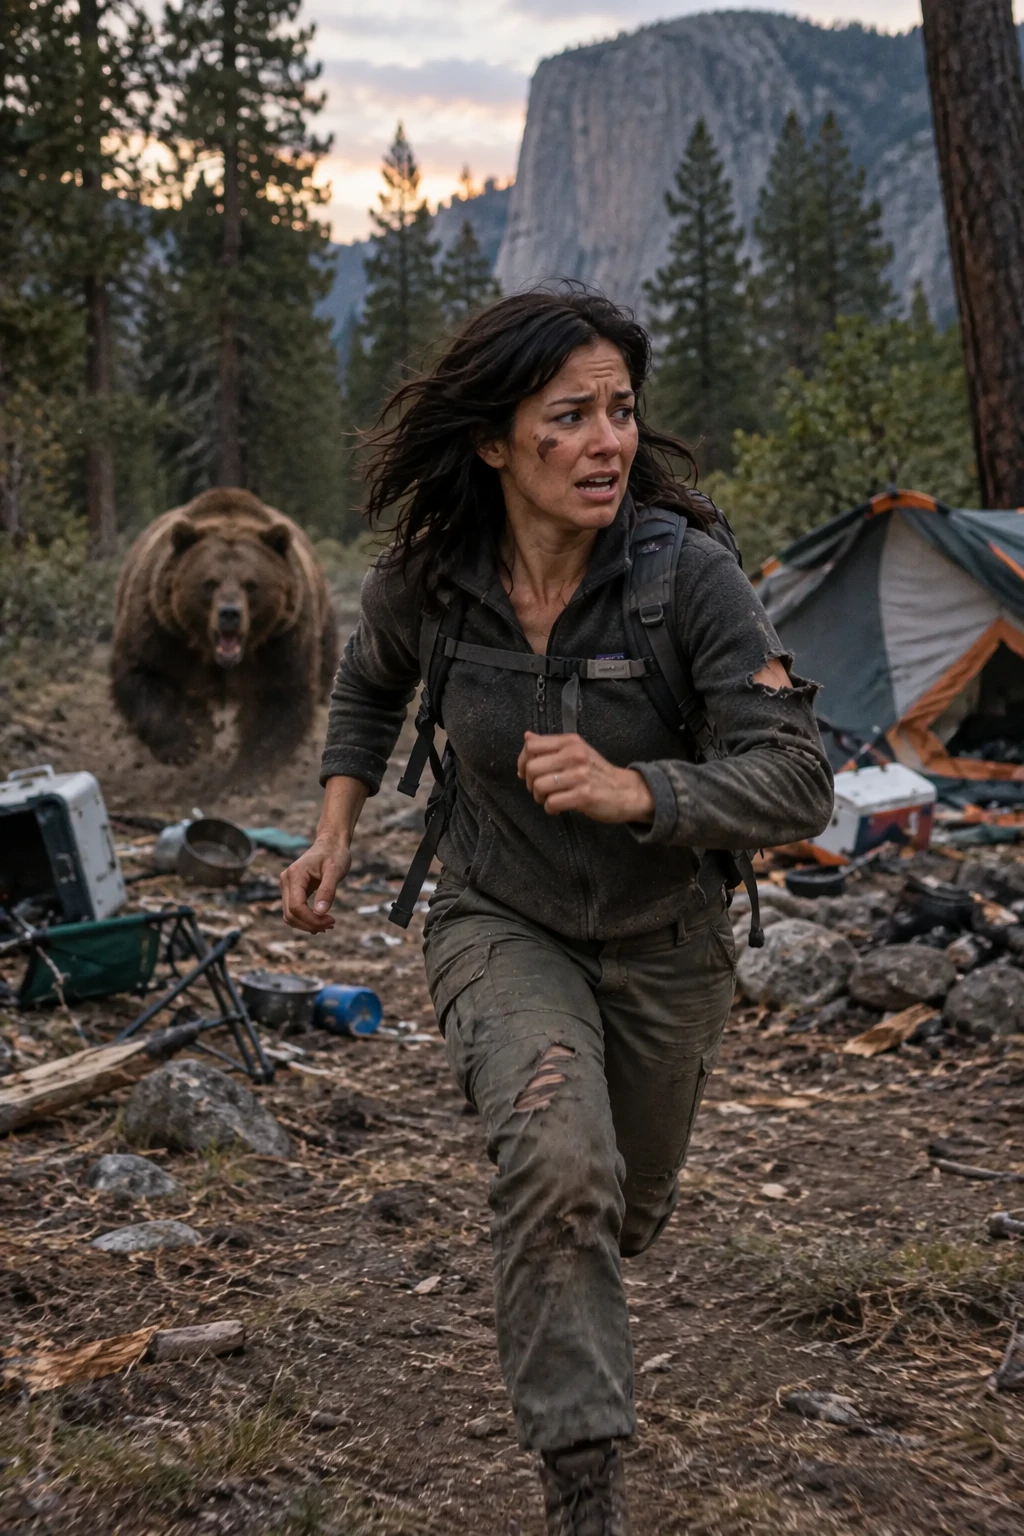
Este prompt insere uma pessoa em uma nova cena preservando sua identidade. Ele especifica iluminação natural, detalhes verossímeis, enquadramento do corpo, olhar e interação com a cena. Configurações de edição: size="1024x1536", quality="medium".
Generate a highly realistic action scene where this person is running away from a large, realistic brown bear attacking a campsite. The image should look like a real photograph someone could have taken, not an overly enhanced or cinematic movie-poster image.
She is centered in the image but looking away from the camera, wearing outdoorsy camping attire, with dirt on her face and tears in her clothing. She is clearly afraid but focused on escaping, running away from the bear as it destroys the campsite behind her.
The campsite is in Yosemite National Park, with believable natural details. The time of day is dusk, with natural lighting and realistic colors. Everything should feel grounded, authentic, and unstyled, as if captured in a real moment. Avoid cinematic lighting, dramatic color grading, or stylized composition.
Resultado do GPT Image 2.5 Flare:
Migração do GPT Image 2
O guia da OpenAI recomenda um processo de migração em seis etapas.
- Salve uma referência inicial. Reúna prompts representativos de produção e imagens de referência, incluindo edições difíceis, texto exato, rostos, geometria de produtos e recursos transparentes. Registre o modelo atual, as configurações da solicitação e os resultados.
- Escolha o primeiro candidato. Se o GPT Image 2 já atender aos seus requisitos de qualidade, comece com Flare e teste se há uma melhoria na latência. Se o GPT Image 2 não atender aos requisitos em um caso de uso complexo, comece com Sunburst e verifique primeiro se ele atende aos requisitos de qualidade. Mantenha inalterados o prompt, as referências, as dimensões e o formato de saída na primeira comparação.
- Confira o resultado completo. Compare o cumprimento das instruções, a preservação da identidade e do produto, a precisão do texto, as alterações indesejadas e a transparência. Repita as solicitações para medir a consistência. Em fluxos de trabalho de edição, teste a sequência completa de edições, além das etapas individuais.
- Teste o ganho de latência depois de atingir a qualidade desejada. Se começou com Sunburst e ele atende aos seus requisitos de qualidade, avalie Flare com os mesmos requisitos. Mude apenas se a qualidade continuar aceitável e a latência melhorar.
- Ajuste uma configuração por vez. Compare os níveis de qualidade antes de reescrever o prompt. Meça os tempos de resposta típicos e mais lentos, as falhas, as novas tentativas e o custo por imagem aceita. Confirme os preços atuais em vez de presumir que o modelo mais rápido custa menos.
- Faça a implementação por fluxo de trabalho. Quando o candidato atender aos seus critérios de aceitação, migre uma pequena parcela do tráfego, monitore as mesmas métricas e amplie gradualmente. Mantenha o modelo anterior disponível para reversão enquanto ele continuar sendo compatível.
Segurança
O ChatGPT Images 2.5 se baseia nas proteções existentes da OpenAI, com verificações de prompts e imagens para ajudar a evitar resultados nocivos. A OpenAI continua usando metadados C2PA e marcas d'água invisíveis para ajudar a identificar imagens criadas com suas ferramentas. O cartão do sistema está disponível no site de segurança de implantação da OpenAI.