Qwen 4 Max: colega de 2,4T parâmetros para trabalho longo
Qwen 4 Max é o novo modelo carro-chefe da Alibaba para trabalho profissional, produção criativa e pesquisa. Anunciado pela equipe Qwen em 16 de novembro de 2026, Qwen4-Max combina uma janela de contexto de 1M, visão e linguagem nativas e um fluxo de trabalho que permite revisar a saída de um agente de IA enquanto ele ainda está trabalhando.
Qwen 4 Max: contexto de 1M e arquitetura esparsa
Qwen4-Max usa uma nova arquitetura esparsa de mistura de especialistas com 2,4 trilhões de parâmetros no total, ativando 71 bilhões por token, além de 328 bilhões de parâmetros N-gram Embedding. A arquitetura combina camadas Gated DeltaNet com atenção esparsa em microblocos e quatro ramificações Gated Residual paralelas.
A especificação de destaque para projetos grandes é a janela de contexto de 1.000.000 de tokens — espaço para uma base de código inteira ou um arquivo documental completo em uma única execução.
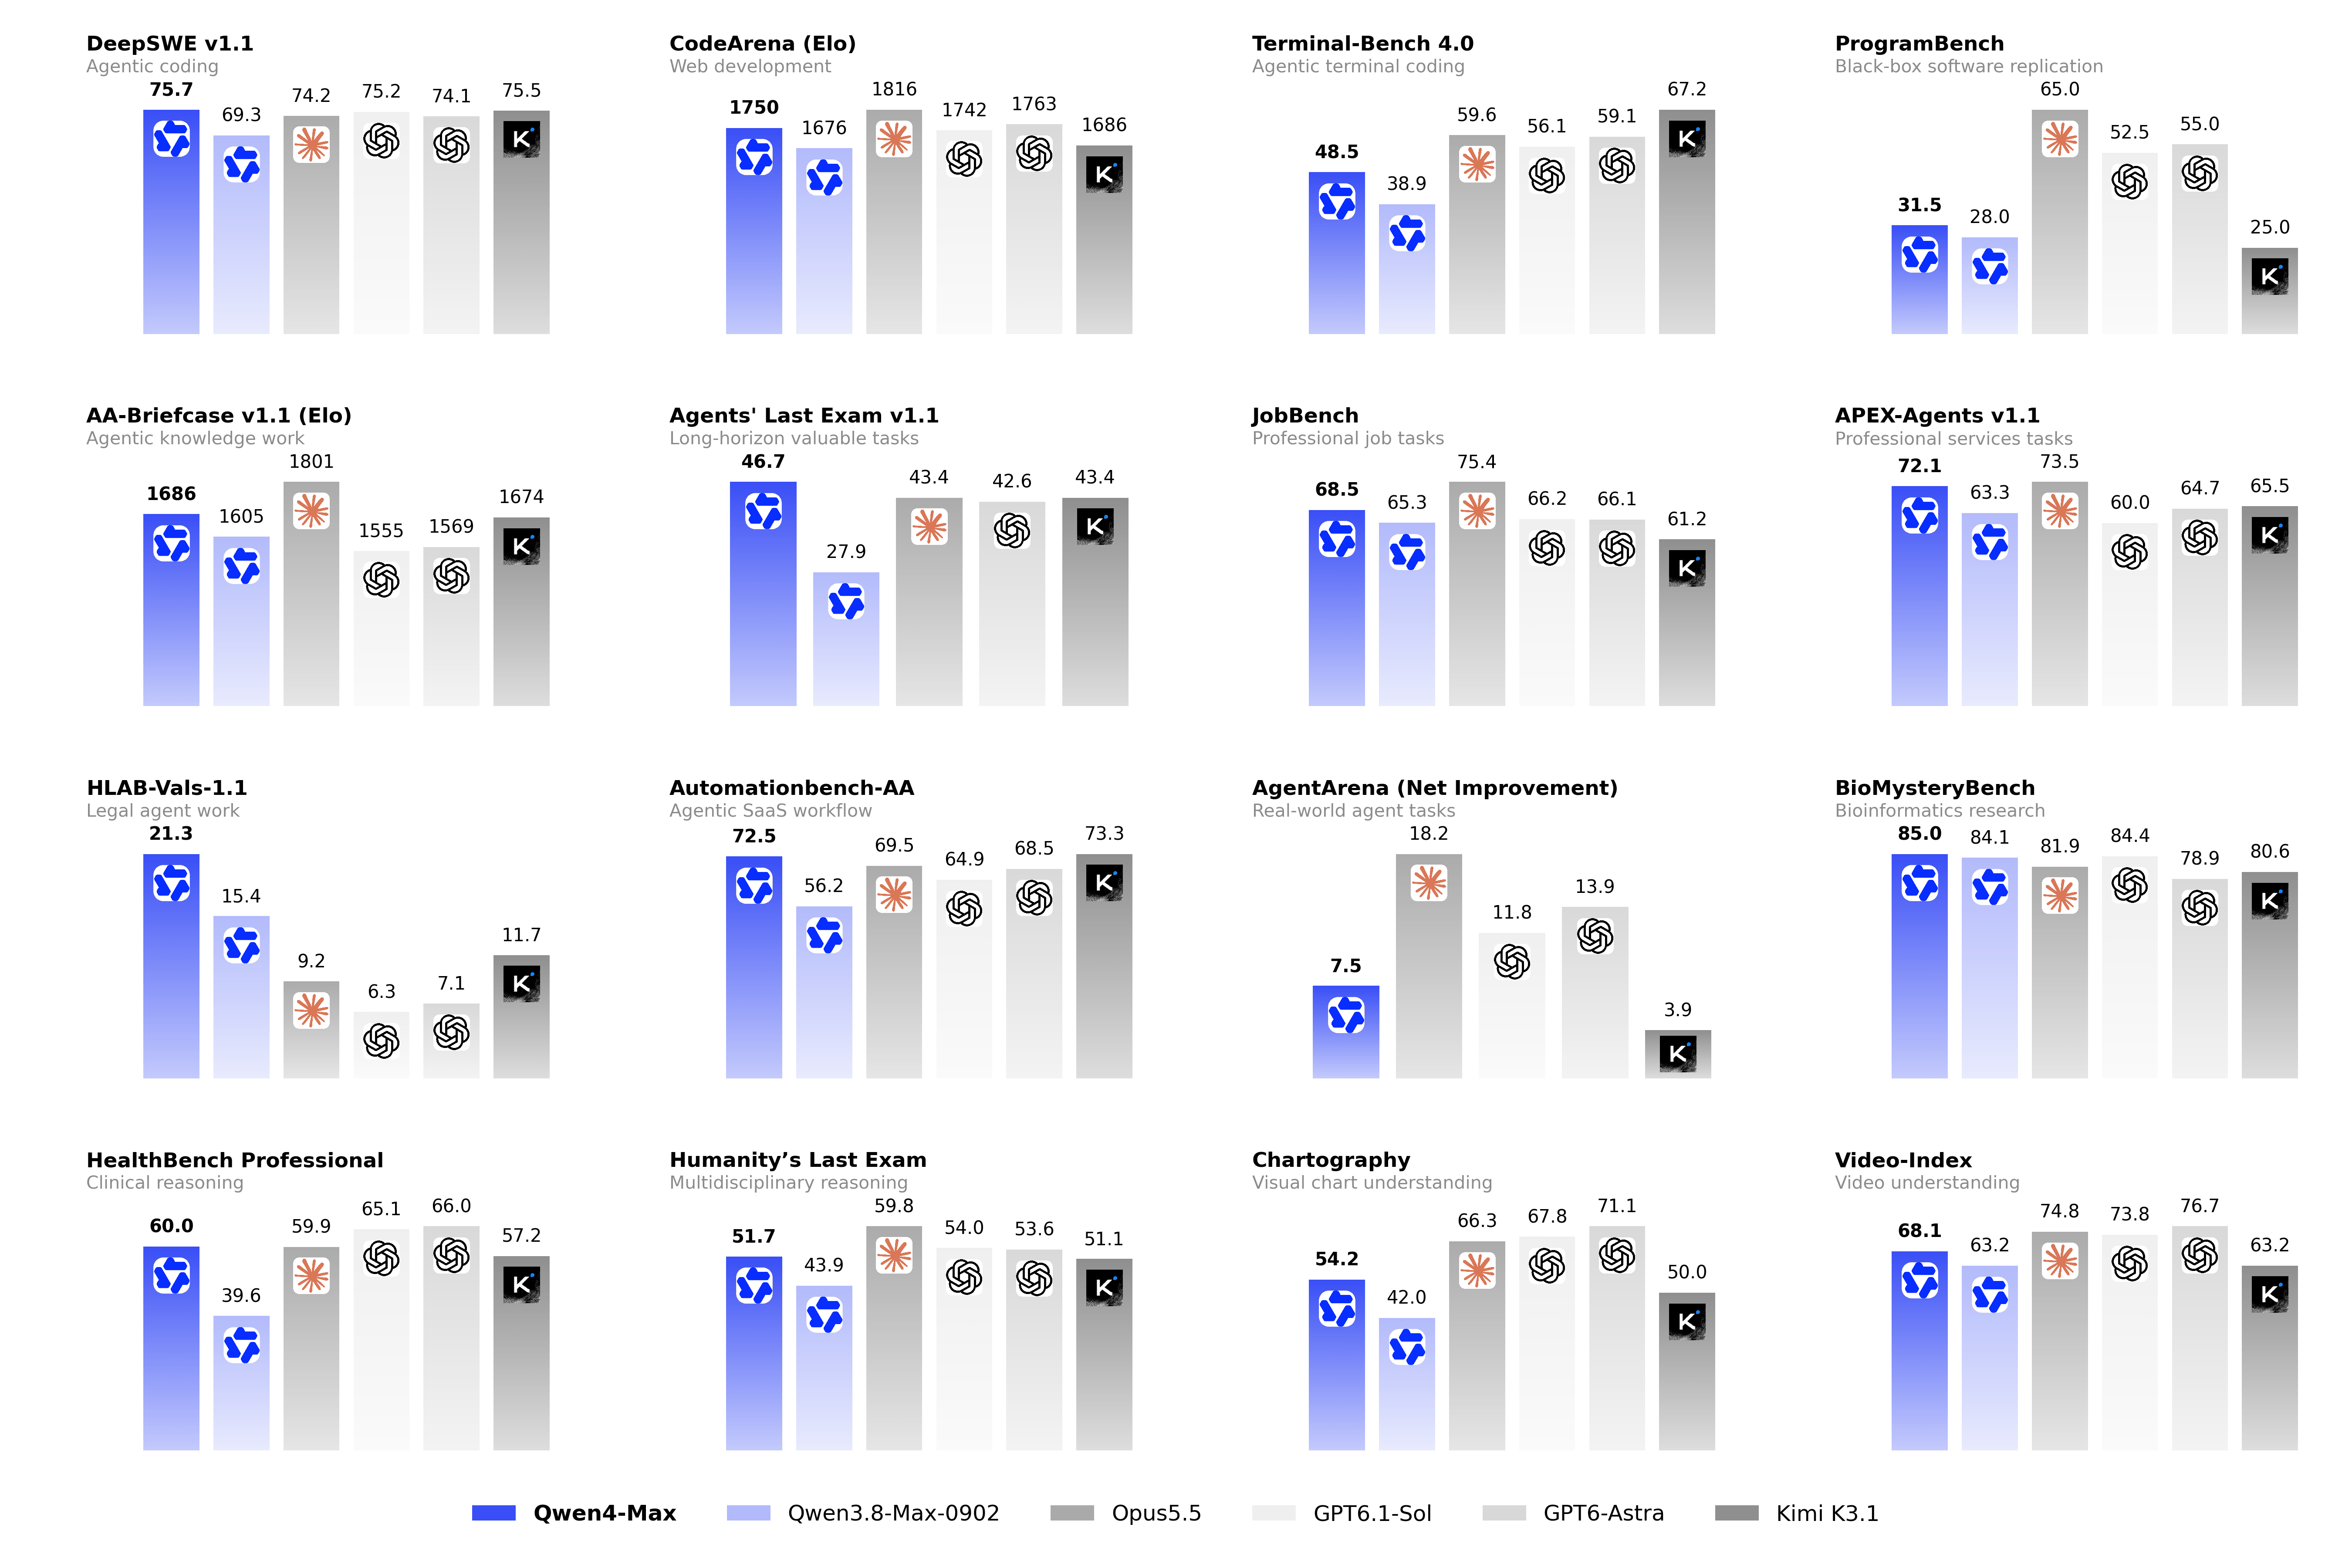
Segundo a Qwen, o modelo base alcança cerca de 5–13% menos bits por byte que o Qwen3.8-Max-Base nas avaliações de Conhecimento, Código, QA e STEM, ativando 25% menos parâmetros.
Resultados de benchmark: pontuações melhores, menos tokens
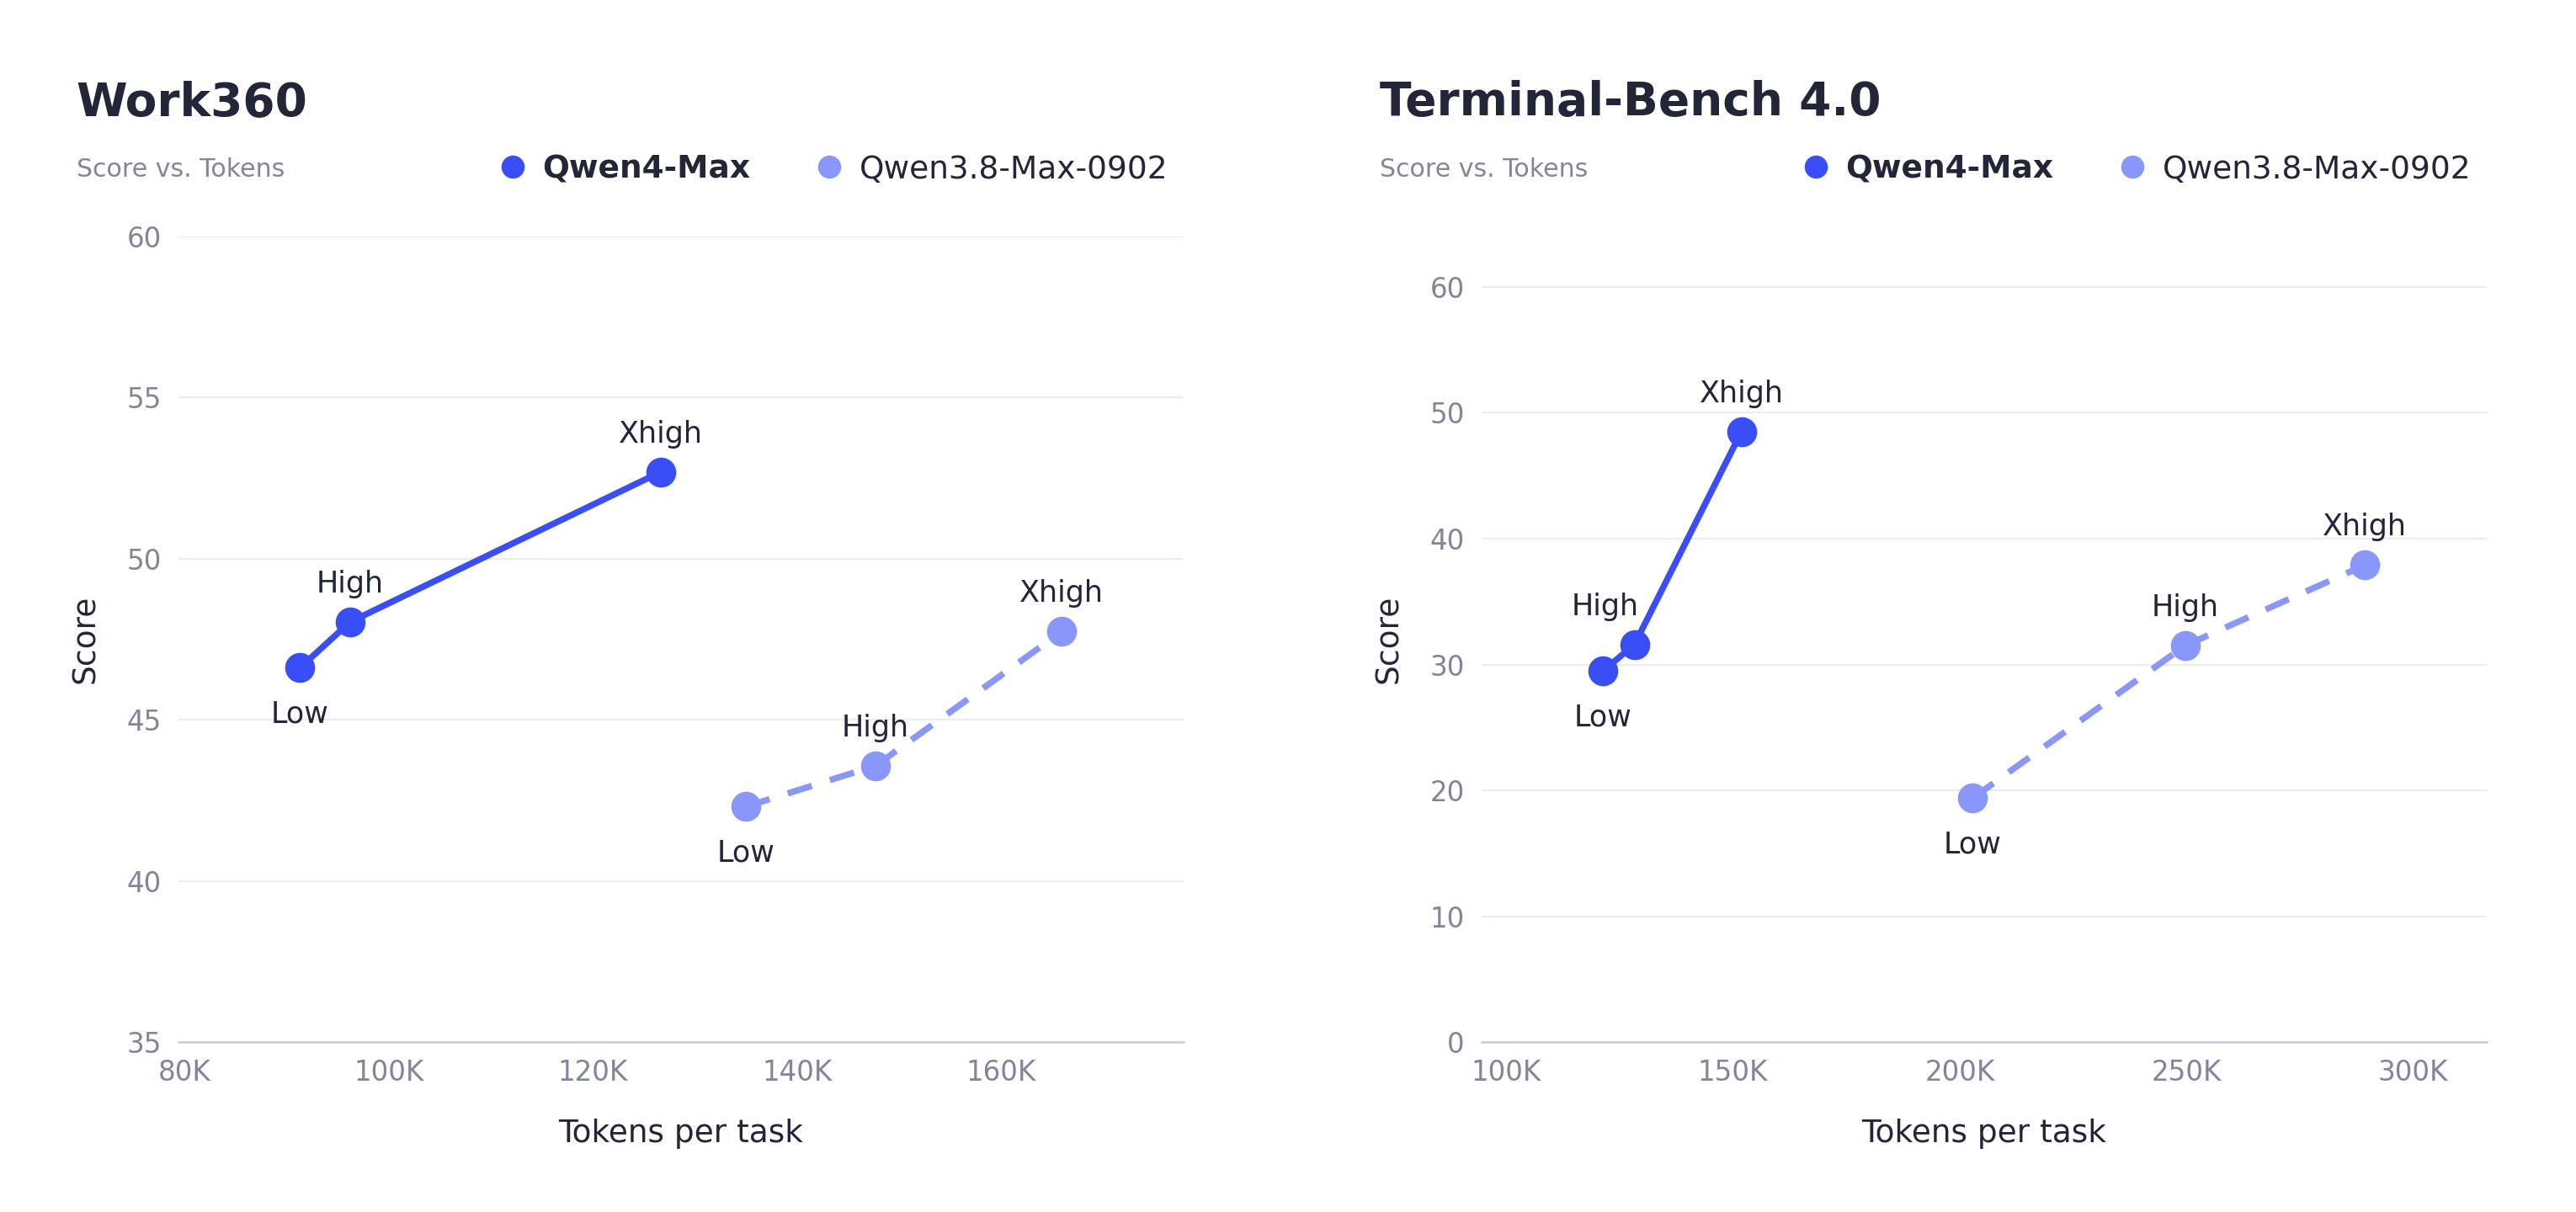
No Work360, benchmark que abrange 26 domínios de nível 1, 182 subdomínios e 721 áreas especializadas, Qwen4-Max obteve 52,69, contra 47,74 do Qwen3.8-Max, segundo a Qwen.
A equipe também relata menor uso de tokens: aproximadamente 24% menos tokens no nível de esforço Xhigh e 35% menos no nível High no Work360, além de 48–49% menos no Terminal-Bench 4.0.
Segundo os dados divulgados pela Qwen, o custo médio por tarefa no Work360 caiu de US$ 4,43 para US$ 1,67, uma redução de 62%. O anúncio afirma que os preços da API são inferiores aos do Qwen3.8-Max, especialmente para entradas em cache, mas não divulga tarifas exatas. Esses resultados são informados pelo fornecedor e não são uma garantia para todas as cargas de trabalho.
Um agente de IA que você pode redirecionar durante a tarefa
A mudança mais prática no fluxo de trabalho é o Live Delivery: agentes de longa duração transmitem entregas intermediárias para que os usuários revisem o progresso e redirecionem a tarefa antes de sua conclusão. A Qwen lançou um plugin Live Delivery de código aberto.
As demonstrações vão de jogos jogáveis criados no Unity 6, Unreal Engine e Godot a modelagem no Blender e produção de vídeo com agentes. A seguir, "Meow of Magic", uma aventura com um gato mago criada pelo modelo no Unreal Engine.
Entre os exemplos profissionais estão pesquisas financeiras que usam 90 ferramentas MCP para produzir planilhas do Excel e apresentações do PowerPoint, além de diligência jurídica que transforma 198 documentos de trabalho em um relatório de 86 páginas com citações. O padrão é o mesmo em todos os casos: uso prolongado de ferramentas, seguido de uma entrega que você pode revisar.
Onde experimentar Qwen4-Max
A Qwen informa que o modelo está disponível pelo plano de tokens ou pela API da QwenCloud, além do QwenWork, Qoder e QwenStudio. Os pesos do Qwen4-Max não são abertos; modelos Qwen4 menores serão disponibilizados como código aberto posteriormente.
Você pode experimentar modelos de ponta em vega.chat ou por meio de api.vega.chat; confira o seletor de modelos para ver quando Qwen 4 Max estará disponível.
Para tarefas médicas, jurídicas, financeiras e outras de alto impacto, vale a ressalva da própria Qwen: o modelo auxilia o julgamento profissional. Não o substitui.