GLM-5.3: kodlash va kiberxavfsizlikdagi yutuq
GLM-5.3 uchun biz faqat post-treningni kengaytirdik. GLM-5.2 bilan asosiy texnologik stekni yaratdik: samarali, uzun kontekstli ishlov berish uchun IndexShare, uzoq ufqli vazifalarda RL uchun SAO va keng miqyosli asinxron trening uchun slime — bularning barchasi biz to‘plab kelayotgan uzoq ufqli vazifalar muhitlarida ishlaydi. O‘tgan oy davomida ushbu stekni kengaytirishda davom etdik: ko‘proq muhitlar, xilma-xilroq vazifalar va ular ustida trening o‘tkazish uchun ko‘proq hisoblash quvvati.
Bugun GLM-5.3’ni taqdim etyapmiz. Unda GLM-5.2 bilan bir xil bazaviy model ishlatilgan — barcha yutuqlar post-treningdan. GLM-5.2 bilan solishtirganda, u murakkab kodlash va uzoq ufqli vazifalarni bajarishda ancha kuchli:
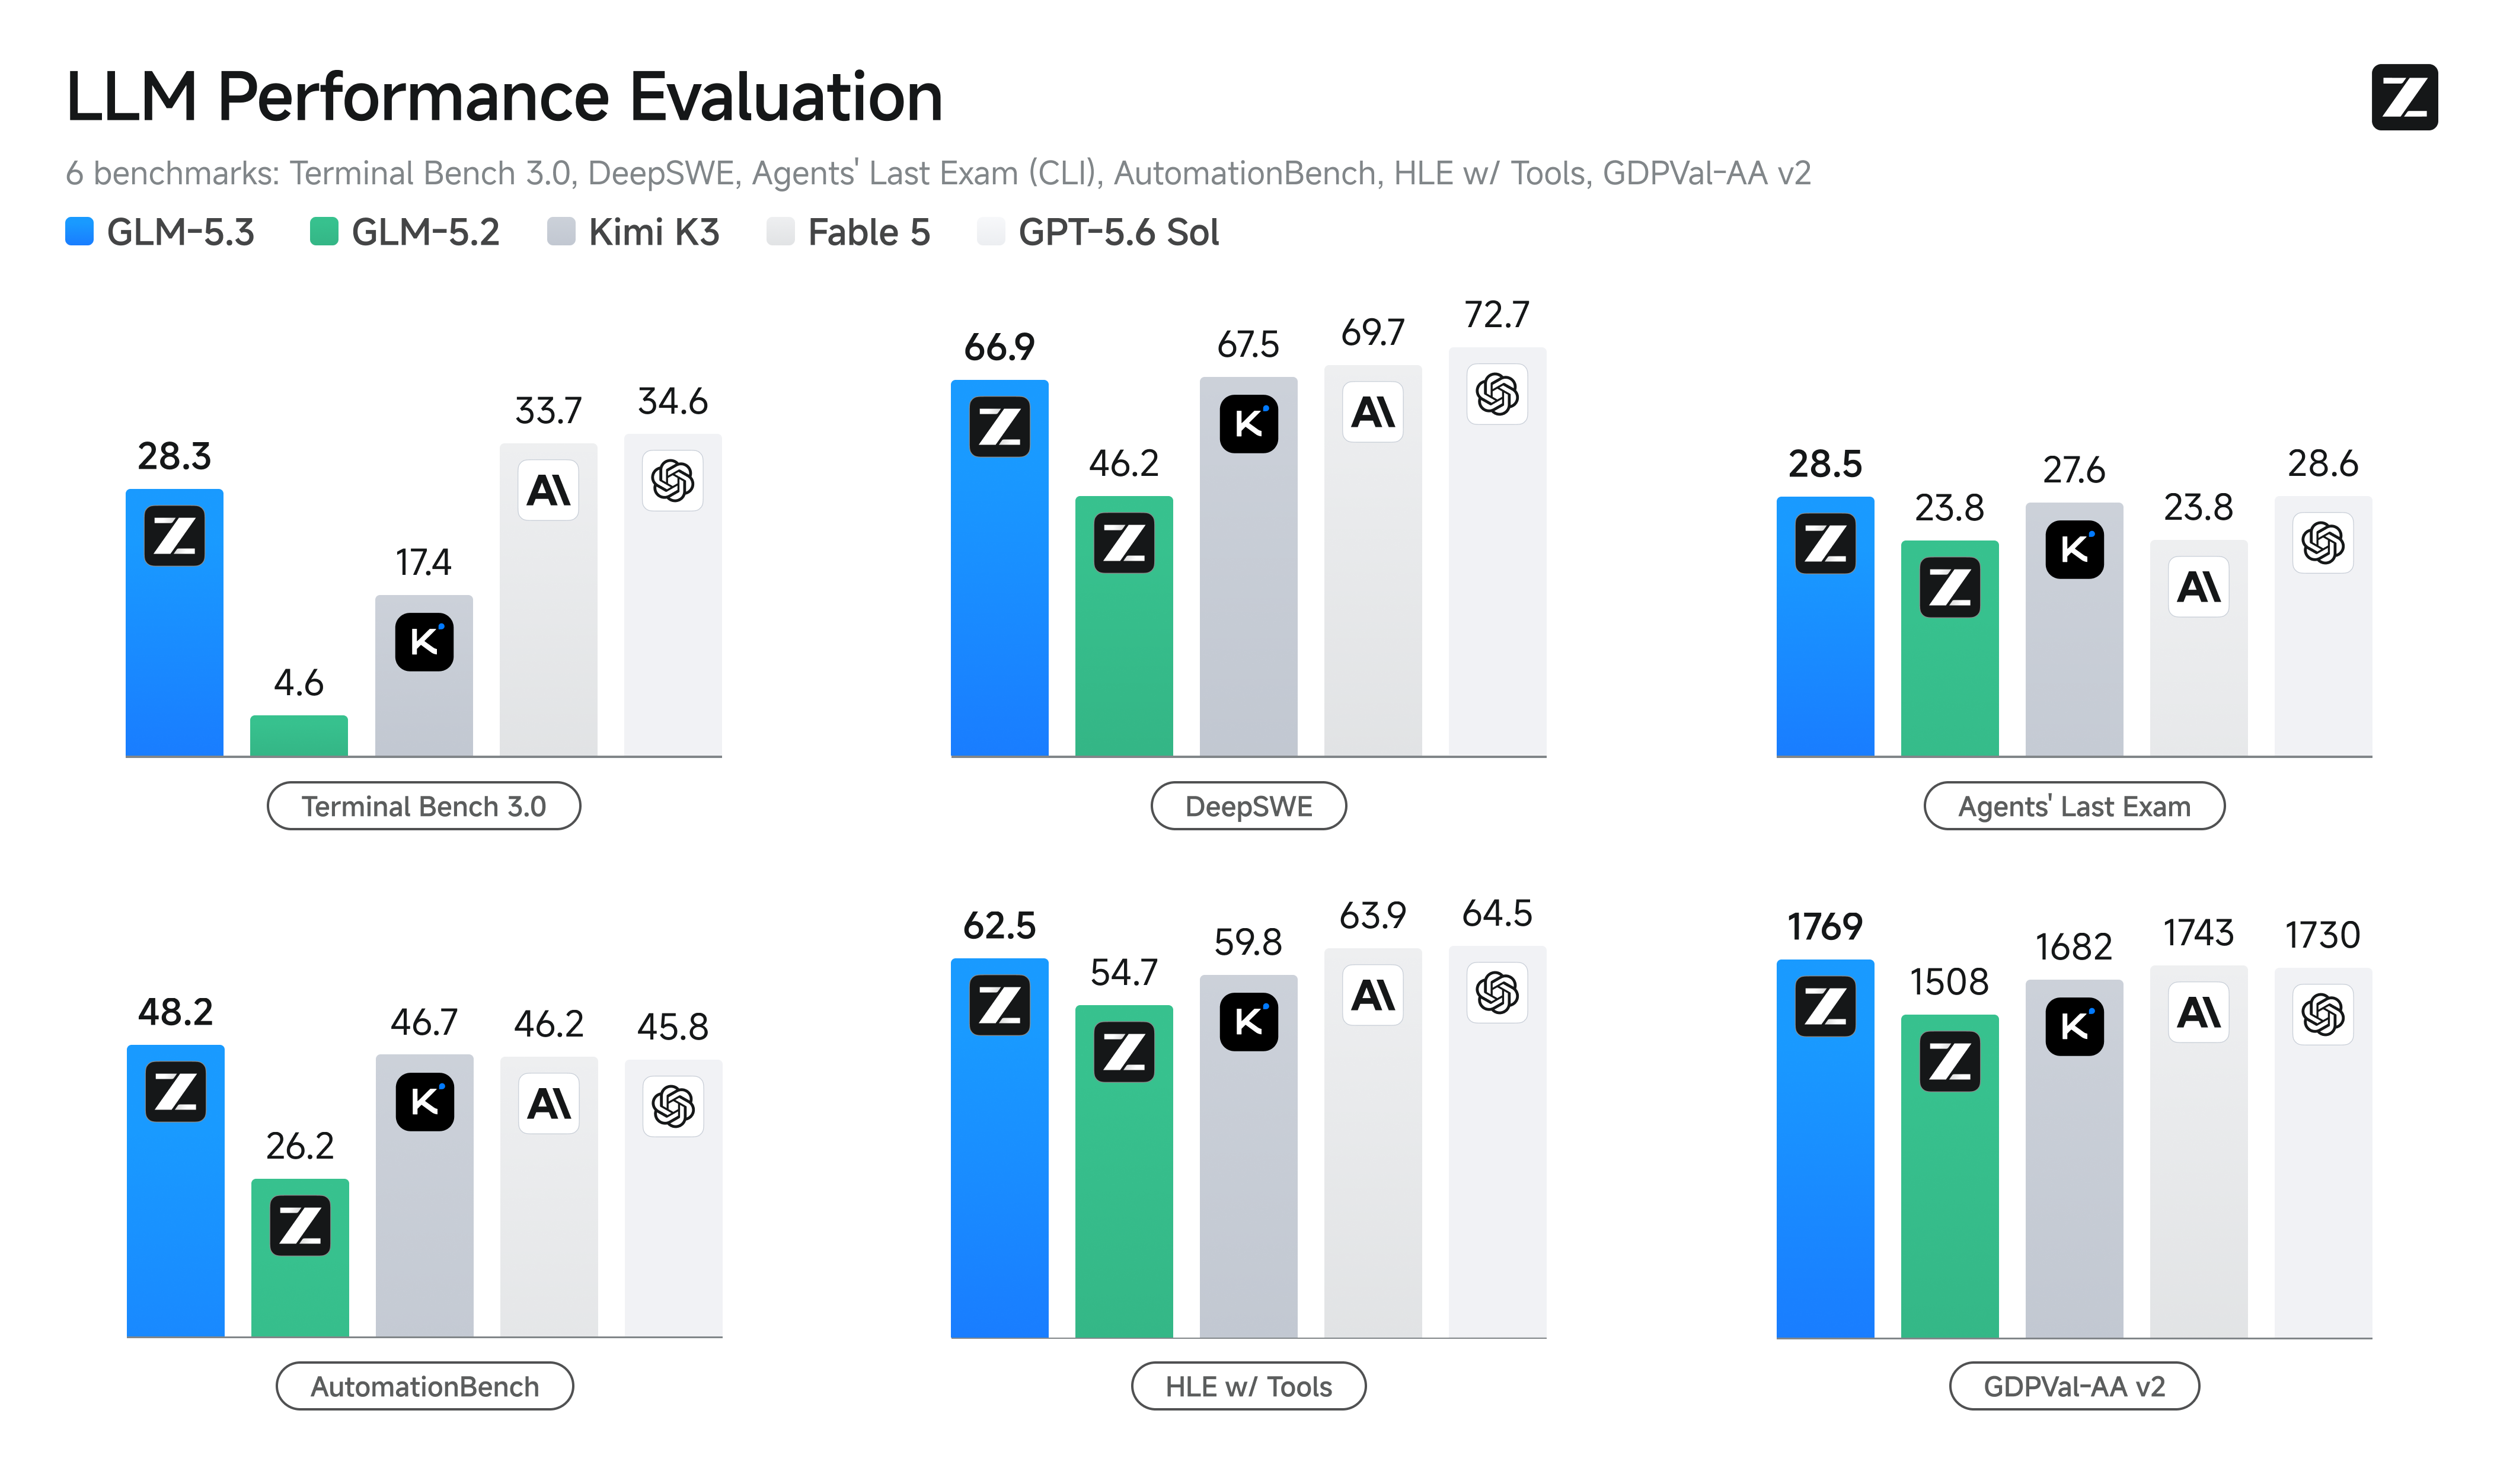
- Kuchliroq kodlash: GLM-5.3 kodlash uchun ochiq vaznli modellar orasida eng qobiliyatlisi bo‘lib, Z.ai’ning ichki Code Bench benchmarkida GLM-5.2’dan 50% yuqori natija ko‘rsatdi. Shuningdek, Terminal Bench 3.0 va Agents' Last Exam kabi ommaviy benchmarklarda ochiq manbali SOTA natijalariga erishdi.
- Kutilmaganda namoyon bo‘lgan kiber imkoniyatlar: Post-treningni kengaytirar ekanmiz, kiber imkoniyatlar kutilganimizdan tezroq rivojlandi. GLM-5.3 zaifliklarni aniqlash bo‘yicha CyberGym’da eng ilg‘or natijaga ega, shuningdek, ekspluatatsiya zanjirining keyingi bosqichlarida uning yutuqlari eng katta: ekspluatatsiya benchmarklarida GLM-5.2 natijasidan ikki baravardan ham ko‘proq yuqori natija ko‘rsatadi.
- Ochiq manba: Xavfsizlik baholashlari va mustahkamlash ishlari yakunlangach, ishga tushirilganidan ikki hafta o‘tib vaznlarni e’lon qilamiz.
Kutilmaganda namoyon bo‘lgan kiber imkoniyatlar
Post-trening doirasida biz zaifliklarni aniqlashga oid ma’lumotlar va muhitlarni trening ma’lumotlari tarkibiga kiritdik. Bu modelning zaifliklarni topish va ular haqida xulosa chiqarish qobiliyatini yaxshilaydi, deb kutgandik. Bizni hayratga solgani — bu qobiliyat kutilgan maqsaddan ancha oshib ketdi.
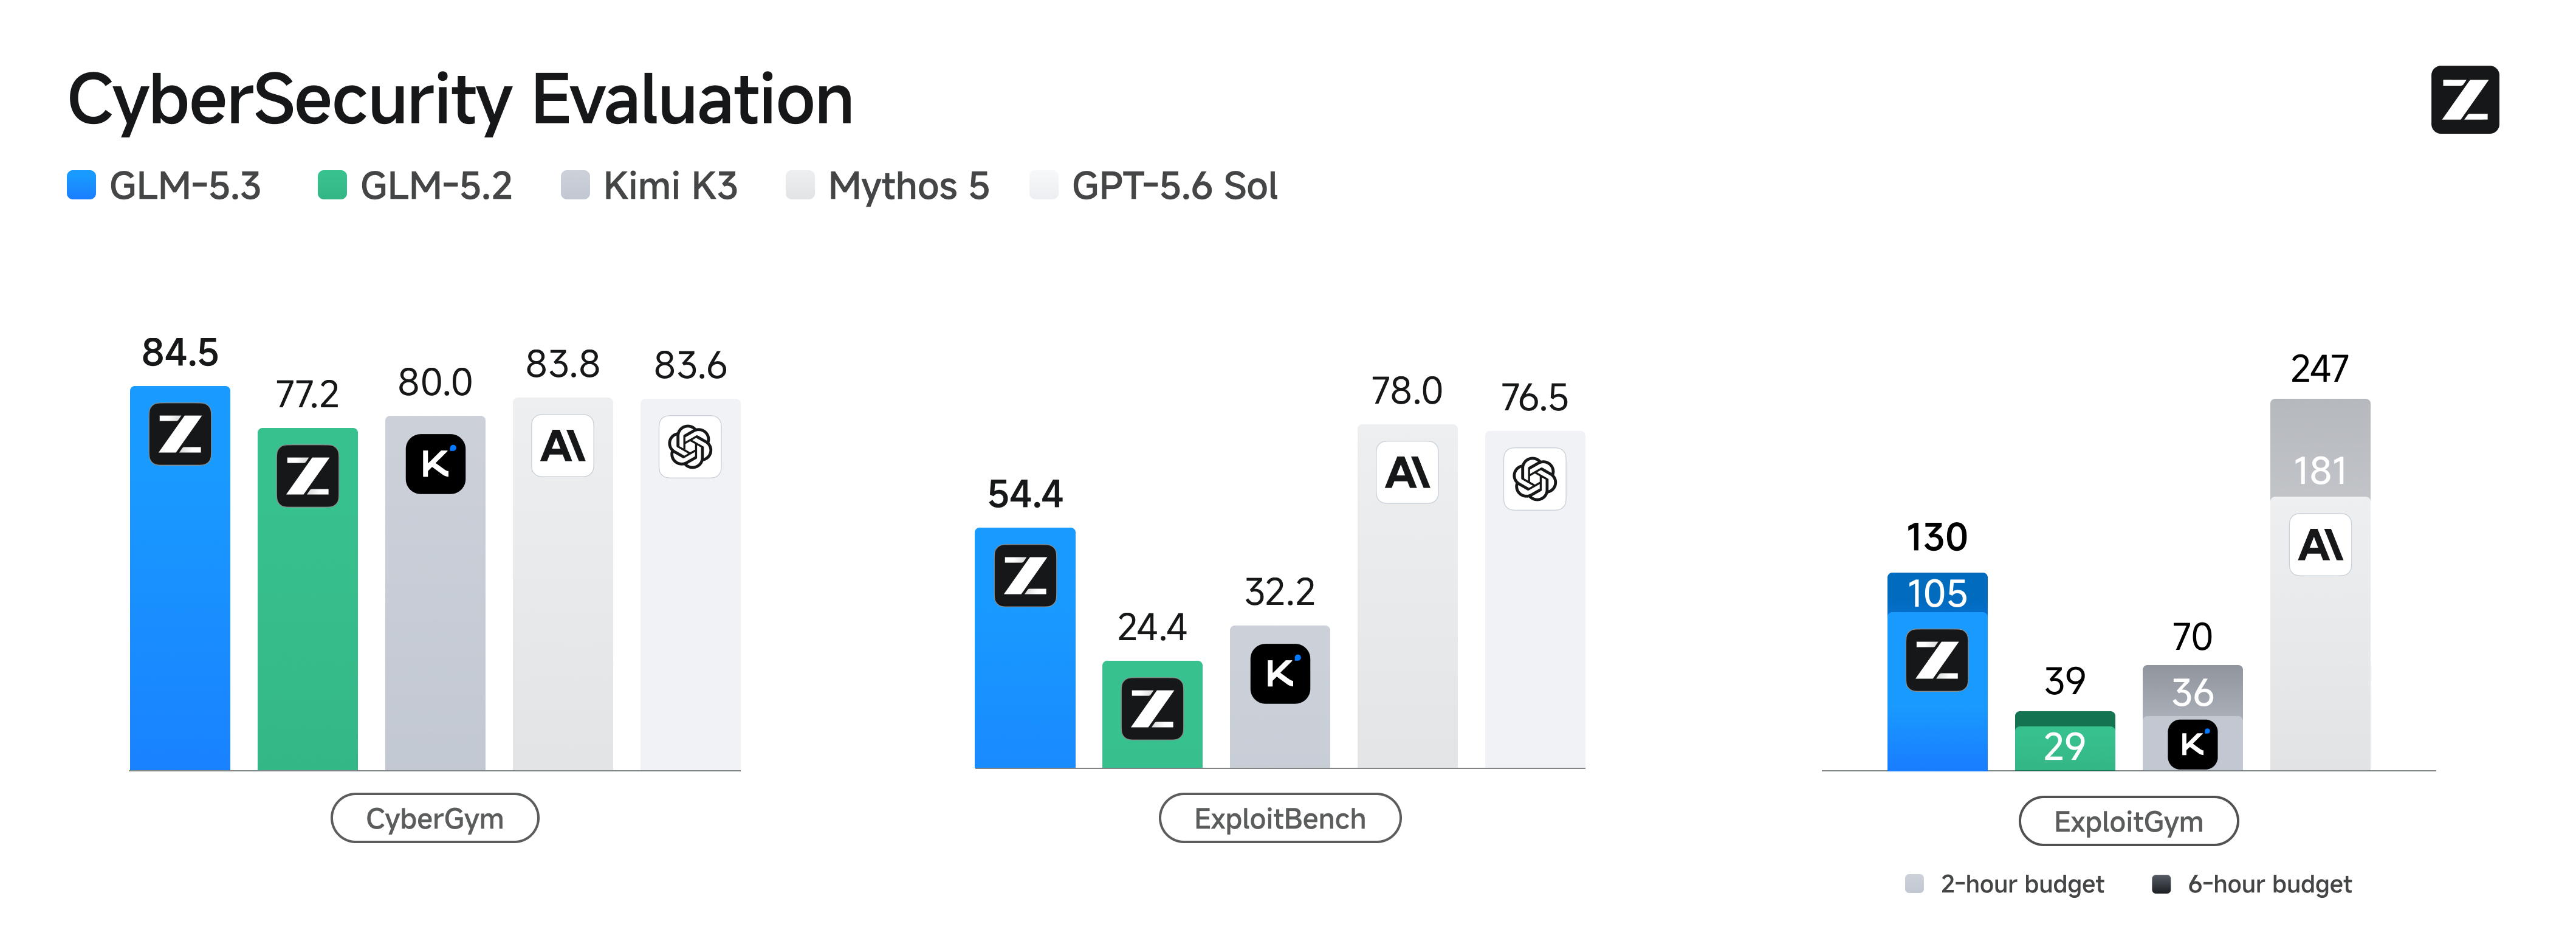
GLM-5.3’ni zaifliklarni tahlil qilish va ekspluatatsiyaning turli bosqichlarini qamrab oluvchi uchta benchmarkda baholaymiz. Oq quti manba kodidan boshlanib, model xatolarni keltirib chiqarish orqali zaifliklarni aniqlay olishi va tasdiqlay olishini tekshiradigan CyberGym’da GLM-5.3 84.5% natija ko‘rsatdi; bu GLM-5.2’ning 77.2% natijasidan yuqori va benchmarkdagi eng yaxshi natija bo‘lib, Mythos 5 (83.8%) hamda GPT-5.6 Sol’dan (83.6%) oldinda. Haqiqiy zaifliklar va ularni ekspluatatsiya qilish haqida chuqurroq fikrlashni talab qiladigan ExploitBench’da GLM-5.3 54.4% natijaga erishib, GLM-5.2’ning 24.4% natijasidan ikki baravardan ko‘proq yuqori bo‘ldi; Mythos 5 va GPT-5.6 Sol esa mos ravishda 78.0% va 76.5% natija ko‘rsatdi. Model vaqtga moslashtirilgan byudjetlar doirasida nechta ekspluatatsiya vazifasini bajara olishini o‘lchaydigan ExploitGym’da GLM-5.3 ikki soatda 105 ta, olti soatda esa 130 ta vazifani bajardi; GLM-5.2 mos ravishda 29 ta va 39 ta vazifani bajargan. Mythos 5 esa 181 va 247 ta vazifa bilan ancha oldinda qolmoqda. Uchala benchmarkda ham manzara bir xil: benchmark ekspluatatsiya zanjirining qanchalik yuqori bosqichini o‘lchasa, GLM-5.2 bilan solishtirgandagi yutuq shunchalik katta — yopiq, ilg‘or modellar bilan qolayotgan tafovut ham shunchalik keng. Biz eng ortda qolayotgan sohalardagina imkoniyatlar eng tez o‘smoqda.
Keyin bu imkoniyatlar nazorat qilinadigan benchmarklardan tashqarida ham namoyon bo‘ladimi, deb sinab ko‘rdik. GLM-5.2 chiqqanidan beri Xitoydagi bir nechta xavfsizlik jamoasi bilan hamkorlik qilib, modellarimizni real kod bazalarida sinovdan o‘tkazib kelyapmiz. Mutaxassislar tekshiruvi, saralash va takrorlarni olib tashlashdan so‘ng, model 269 ta loyihada 2,436 ta zaiflikni aniqladi; ularning 1,097 tasi o‘rta va yuqori darajadagi jiddiylikka ega edi. Aniqlangan zaifliklar tizim yadrolari, operatsion tizimlar, brauzer dvigatellari, ochiq manbali infratuzilmalar, veb-ilovalar va tarmoq protokollarini qamrab oladi. Ularning aksariyati yillar, hatto o‘n yillab sezilmay qolgan; eng qadimgisi taxminan 40 yil avval paydo bo‘lgan.
Bu ish keyinchalik davom etayotgan oshkor qilish tashabbusiga aylandi. Aniqlangan zaifliklar oshkor qilish jarayonidan o‘tishi davomida ular haqidagi ochiq qaydlarni yuritish uchun Z.ai Security Disclosure Ledger platformasini yaratdik. Yangi zaifliklar ko‘rib chiqilib, oshkor etilgani sari ledger muntazam yangilanib boradi va ommaga allaqachon e’lon qilingan muammolarni oshkor qilish jarayoni davom etayotgan muammolardan ajratib ko‘rsatadi. Oshkor qilingan muammolar uchun unda ta’sirlangan loyiha, jiddiylik darajasi, mavjud bo‘lsa CVE va zaiflik kod bazasida qancha vaqt saqlanib qolgani kabi ma’lumotlar qayd etiladi.
slime: uzoq ufqli RL’ni kengaytirish uchun yaratilgan
Bularning barchasi RL’ni kengaytirish uchun mo‘ljallangan ochiq manbali post-trening freymvorkimiz — slime’da ishlaydi. Trening tomonda Megatron, natijalarni hosil qilish tomonda esa SGLang qo‘llanadi. Uning dizayni trening, natijalarni hosil qilish va ma’lumotlar buferini yagona ma’lumot oqimida birlashtiradi. Shu bois matematika, kod, sinov muhitlari, verifikatorlar va uzoq ufqli agentli muhitlarni trening siklini o‘zgartirish o‘rniga, ma’lumot yaratish vositasi sifatida ulash mumkin. Aynan shu xususiyat tufayli har safar trening stekini qayta yaratmasdan, GLM-5.2 va GLM-5.3 davomida yangi muhitlar qo‘shib bordik.
GLM-5.3 davomida uni ikki yo‘nalishda rivojlantirdik. Algoritmlar tomondan RL tadqiqotlari uchun yangi imkoniyatlarni qo‘shdik: top-p mask, top-k va to‘liq lug‘atli OPD, shuningdek trening va natijalarni hosil qilish jarayonlari orasidagi muvofiqlikni yaxshilovchi sozlamalar. Jumladan, R3 uslubidagi konfiguratsiyalar hamda trening va natijalarni hosil qilish yo‘llari orasida to‘liq sonli moslikni ta’minlash. Bular namuna olish, trening va o‘qituvchi signallarini aniqroq boshqarish imkonini beradi hamda nazorat qilinadigan taqqoslashlarni tez o‘tkazishga yordam beradi. Trening va natijalarni hosil qilish muvofiqligini baholashimizda logarifmik ehtimollar (logprob) orasidagi o‘rtacha farq 1e-7 darajasida saqlandi — bu avvalgi sozlamalar bilan solishtirganda 99.99% dan ortiq kamayish demakdir.
Shuningdek, keng ko‘lamli RL uchun resurslardan samarali foydalanish va tizim o‘tkazuvchanligini oshirish ustida ishladik. Endi mahalliy xotira qo‘shimcha kesh qatlami sifatida xizmat qilib, aks holda xost xotirasida saqlanadigan model holatlari va ma’lumotlarni iyerarxik tarzda saqlaydi. Bu, ayniqsa, ko‘p o‘qituvchili OPD uchun muhim: trening tomonida o‘qituvchilarni dinamik almashtirish va oldindan yuklash yordamida bir nechta o‘qituvchidan har biri uchun alohida, doimiy ishlaydigan inferensiya xizmati yaratmasdan foydalanish mumkin. Bunda qo‘shimcha xarajat cheklangan, resurslar sarfi esa ancha past bo‘ladi. Agentli va asinxron ish yuklamalari uchun router va slime o‘rtasidagi birgalikda rejalashtirish hamda yuklamani muvozanatlashni yaxshiladik. Natijada, davomiyligi va bajarilish vaqti keskin farq qiladigan natija so‘rovlari inferensiya resurslaridan samaraliroq foydalanadi. Har bir natija hosil qilish muhitining xususiyatlariga qarab o‘tkazuvchanlikka yo‘naltirilgan konfiguratsiyalarni — prefill/decode resurslar nisbati, bir vaqtdagi so‘rovlar sozlamalari va o‘tkazuvchanlik uchun muhim boshqa parametrlarni — aniqlaydigan ish yuklamasidan xabardor evristikalarni qo‘shdik. Natijada, uzoq ufqli kodlash RL vazifalarida tizim darajasidagi bu optimallashtirishlar RL treningining boshidan oxirigacha bo‘lgan o‘tkazuvchanligini 2.3× dan ko‘proq oshirdi. Bu esa treningni ancha yuqori samaradorlikda uzoqroq trayektoriyalar va murakkabroq muhitlarda kengaytirish imkonini berdi.
Umuman olganda, bular tajribalar o‘tkazishda ko‘proq erkinlik, kamroq resurs sarfi va yuqoriroq o‘tkazuvchanlikni ta’minlaydi — RL’ni kengaytirishni amalda davom ettirishimizga aynan shu imkon beradi.
GLM-5.3’dan foydalanishni boshlash
GLM-5.3’dagi API o‘zgarishlari
GLM-5.3 uchta fikrlash darajasini qo‘llab-quvvatlaydi: low, high va max. GLM-5.3’da fikrlashni o‘chirib qo‘llab-quvvatlash endi mavjud emas.
| Parametr | Qiymatlar | Standart qiymat | Tavsif |
|---|---|---|---|
| thinking.type | enabled | enabled | Fikrlashni yoqadi. disabled endi qo‘llab-quvvatlanmaydi. |
| reasoning_effort | low, high, max | max | low: yengil; high: kuchaytirilgan; max: chuqur. Kodlash vazifalari uchun max tavsiya etiladi. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
O‘tish talab etiladi: Agar ilovangiz hozirda thinking.type: "disabled" parametridan foydalansa, model ID’sini glm-5.3’ga yangilashdan oldin uni enabled ga o‘zgartiring va reasoning_effort ni low qilib belgilang. Aks holda, so‘rov bajarilmaydi.
GLM Coding Plan va ZCode bilan GLM-5.3’dan foydalaning
GLM-5.3’ni sevimli kodlash agentlaringizda sinab ko‘ring — ZCode, Claude Code, OpenCode va boshqalarda. devpack haqida batafsil ma’lumot oling.
GLM Coding Plan obunachilari uchun: GLM-5.3’ni barcha GLM Coding Plan foydalanuvchilariga taqdim etdik. Yangi GLM Coding Plan endi ballarga asoslangan kvota tizimidan foydalanadi. Ballar sarfi kiruvchi, keshlangan kiruvchi va chiquvchi tokenlar uchun alohida hisoblanadi. Tig‘iz vaqtlar tashqarisida amalga oshirilgan model chaqiruvlari standart ballarning 50% ini sarflaydi. Tig‘iz vaqtlar dushanbadan jumagacha 14:00–18:00 (UTC+8); dam olish kunlari ham qo‘shib hisoblaganda qolgan barcha vaqtlarda tig‘iz bo‘lmagan vaqtlar uchun belgilangan 50% chegirmali tarif amal qiladi. Hozirdanoq yaratishni boshlang: z.ai/subscribe
ZCode bilan GLM-5.3’dan ko‘proq foydalaning
- 98%+ keshdan foydalanish darajasi — takroriy kontekst uchun arzonroq keshlangan tarif bo‘yicha haq olinadi, samarali tokenlar ~30% ko‘proq
- Cheklangan muddatga kvotaga 1.5x oshirish — kesh tejamkorligi bilan birga foydalanib, 31-avgustgacha standart kvotangizni 180% gacha oshiring
- Uzoq ufqli vazifalarni mahorat bilan bajarish — Goal rejimi maqsadga erishilmaguncha rejalashtiradi, kod yozadi, sinaydi va tekshiradi
- Remote Control — uzoq davom etadigan vazifalarni WeChat yoki Feishu orqali telefoningizdan kuzating va boshqaring
ZCode’ni sinab ko‘ring: zcode.z.ai
GLM-5.3’ni mahalliy muhitda ishga tushiring
GLM-5.3 model vaznlari ishga tushirilganidan keyin ikki hafta ichida ommaga taqdim etiladi.