Claude Haiku 5.5 est désormais disponible sur VEGA
Anthropic a lancé Claude Haiku 5.5 le 7 octobre 2026. C’est le petit modèle le plus rapide et le plus performant que l’entreprise ait commercialisé, et son coût d’utilisation est en moyenne environ 75 % inférieur à celui de Haiku 4.5.
Haiku 5.5 est déjà intégré à VEGA. C’est le modèle par défaut des modes auto, chat, code, web, extreme et memory.
Pour quels usages a-t-il été conçu ?
Haiku 5.5 vise les tâches à grand volume, pour lesquelles le coût et la rapidité comptent davantage qu’un raisonnement approfondi. Anthropic cite les résumés, la compaction du contexte, les requêtes de base de données et la classification. Le modèle convient également au service client en direct et à la navigation dans un navigateur, où le temps de réponse influe sur l’expérience du produit.
Dans les configurations de codage, il peut agir comme sous-agent aux côtés d’Opus 5.5 ou de Sonnet 5.5. Anthropic précise qu’il ne s’agit pas du modèle à privilégier pour le codage agentique complexe. Sonnet 5.5 et Opus 5.5 restent en tête pour des tâches comme Terminal-Bench 4.0.
Haiku 5.5 est aussi le premier modèle de la classe Haiku doté d’un réglage d’effort ajustable. Vous pouvez choisir entre un coût plus bas et une qualité supérieure selon l’usage.
Benchmarks
Le tableau compare Haiku 5.5 à Haiku 4.5, GPT-6 Luna et Sonnet 5.5, inclus à titre de référence.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (travail intellectuel) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (travail intellectuel) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, sous-ensemble hors ligne (utilisation d’un ordinateur) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam, sans outils | 45.9% | 10.2% | n/a | 56.9% |
| Humanity's Last Exam, avec outils | 57.4% | 18.7% | n/a | 64.5% |
| Terminal-Bench 4.0 (codage agentique) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1, Main (codage agentique) | 46.4% | n/a | 42.4% | 52.1% (Xhigh) |
| Chartography, sans outils (raisonnement visuel) | 46.4% | 6.4% | 29.1% | 61.6% |
Le réglage d’effort fait beaucoup varier les résultats. Sur OSWorld 2.1, Haiku 5.5 passe de 42.0% avec le réglage Low (0,07 $) à 72.4% avec le réglage Max (0,61 $).
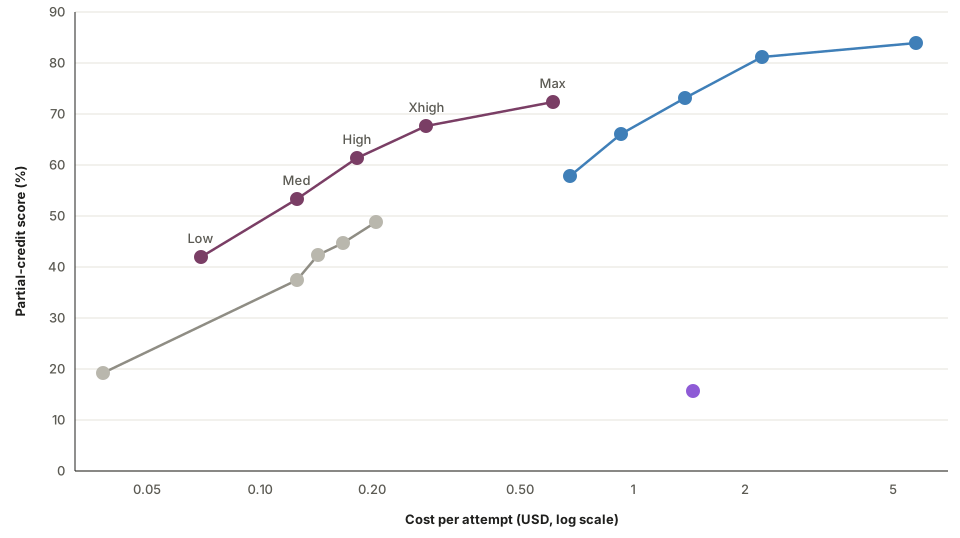
OSWorld 2.1 mesure la capacité des agents à utiliser un véritable ordinateur pour effectuer des tâches longues en plusieurs étapes.
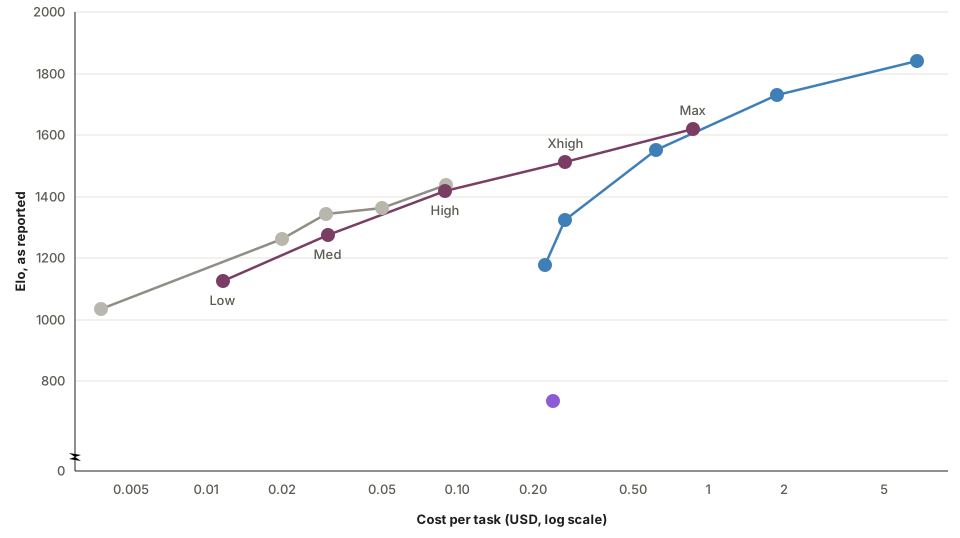
GDPval-AA v2.1 est réalisé par Artificial Analysis. Il évalue les agents sur des tâches professionnelles réelles dans 44 métiers. Haiku 5.5 atteint 1620 avec le réglage Max, contre 735 pour Haiku 4.5.
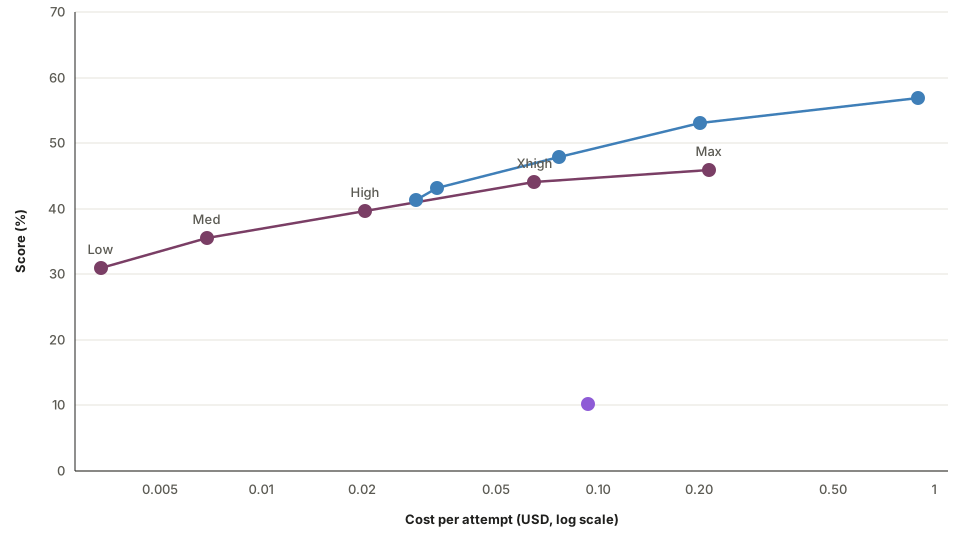
Humanity's Last Exam évalue les connaissances et le raisonnement de niveau expert dans le domaine universitaire. Haiku 5.5 obtient 45.9% avec le réglage Max et sans outils, contre 10.2% pour Haiku 4.5.
Premiers résultats chez les clients
Selon Anthropic, les premiers testeurs ont obtenu des résultats conformes aux chiffres ci-dessus.
- Asana a réalisé son évaluation AI Teammates. Par rapport au modèle utilisé actuellement, Haiku 5.5 a réduit de plus de 30 % la latence d’exécution des tâches et atteint une inférence jusqu’à 2,5 fois plus rapide par tour d’agent.
- HubSpot l’a testé sur des portails CRM simulés. Haiku 5.5 a obtenu une moyenne de 92.8% sur trois essais, le meilleur score que HubSpot ait observé jusqu’ici sur cette suite. Il a également réalisé le plus rapidement une tâche d’audit des fiches obsolètes, avec le meilleur taux de détection et le taux de faux positifs le plus faible parmi les modèles testés.
- AlphaSense a exécuté 400 requêtes avec Ask in Document, une fonctionnalité qui traite environ 8 millions d’appels par semaine en production. Haiku 5.5 a obtenu 0.84, contre 0.76 pour Haiku 4.5, un écart statistiquement significatif.
- Box a indiqué que, lors des premiers tests, Haiku 5.5 avait obtenu un score supérieur de 11 points à celui de Haiku 4.5, avec environ deux fois moins de latence.
- Cognition a ajouté Haiku 5.5 à la gamme de sidekicks de Devin Fusion. Associé à Opus 5.5 en tant que modèle principal, Fusion conserve un score FrontierCode de 66.2 tout en réduisant les coûts et la latence.
Tarification
Les tarifs sont indiqués par million de tokens. Les requêtes de 100 000 tokens maximum représentaient environ 90 % des requêtes adressées au précédent modèle Haiku : c’est pour celles-ci que Haiku 5.5 permet les économies les plus importantes.
| Prix par million de tokens | Haiku 5.5 (jusqu’à 100k / plus de 100k) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Lectures du cache | $0.01 / $0.05 | $0.10 | $0.10 |
| Écritures dans le cache | $0.125 / $0.625 | $1.25 | $2.50 |
| Tokens d’entrée | $0.10 / $0.50 | $1.00 | $2.00 |
| Tokens de sortie | $0.50 / $2.50 | $5.00 | $10.00 |
Pour les requêtes d’au plus 100 000 tokens, Haiku 5.5 coûte 90 % de moins que Haiku 4.5 ; pour les requêtes plus longues, 50 % de moins. L’économie moyenne est d’environ 75 %. Ce chiffre tient également compte du nouveau tokenizer, similaire à celui de Sonnet 5.5 et d’Opus 5.5, qui produit légèrement plus de tokens par tâche.
Autres changements tarifaires
Anthropic a également modifié les tarifs de ses autres modèles. Les lectures du cache de Sonnet 5.5 coûtent désormais 50 % moins cher, soit $0.10 par million de tokens au lieu de $0.20. Pour la plupart des tâches agentiques, le coût de Sonnet 5.5 diminue ainsi d’environ 20 %. Sur Terminal-Bench 4.0, le graphique ci-dessous présente les deux tarifs de lecture du cache.

Terminal-Bench 4.0 mesure la capacité d’un modèle à réaliser des tâches professionnelles complexes en plusieurs étapes dans une interface en ligne de commande. Le graphique montre aussi pourquoi Haiku 5.5 et les modèles plus grands ont des usages différents. Sonnet 5.5 et Opus 5.5 gèrent mieux le codage agentique complexe, tandis que Haiku 5.5 convient aux tâches plus ciblées, comme la compaction, la synthèse et le travail en sous-agent.
Les abonnés Max et Team bénéficient également d’un nouveau crédit API mensuel. Les utilisateurs Max 5x reçoivent 100 $ par mois, les utilisateurs Max 20x reçoivent 200 $, et les abonnés Team bénéficient d’un crédit mutualisé pouvant atteindre 500 $ pour l’ensemble de leurs utilisateurs. Les crédits seront déployés cette semaine et sont utilisables avec n’importe quel modèle de la Claude Platform.
Les SDK Claude pour Python et TypeScript prennent désormais en charge l’utilisation de l’ordinateur et du navigateur en version bêta. Anthropic estime que Haiku 5.5 est adapté à ces tâches grâce à sa rapidité, ses capacités et son prix.
Sécurité
Haiku 5.5 surpasse Haiku 4.5 dans presque toutes les évaluations d’alignement. Le modèle présente beaucoup moins de comportements mal alignés et se montre moins disposé à faciliter les usages abusifs.
Ses protections en matière de cybersécurité sont plus strictes que celles de Haiku 4.5, mais moins que celles de Sonnet 5.5. Elles autorisent davantage de travaux défensifs, mais bloquent toujours les tests d’intrusion et les autres techniques susceptibles d’être employées par des attaquants. Ses protections en biologie sont comparables à celles de Sonnet 5, Sonnet 5.5 et Opus 5. Les questions de recherche en biologie sont autorisées, tandis que les demandes jugées susceptibles de causer des dommages sont restreintes. Les organisations ayant des besoins plus étendus en biologie ou en cybersécurité peuvent déposer une demande auprès des programmes Life Sciences Verification Program et Cyber Verification Program d’Anthropic.
Disponibilité
Haiku 5.5 est disponible dès maintenant sur toutes les principales plateformes cloud, notamment Amazon Web Services, Google Cloud et Microsoft Azure. Sur la Claude Platform, son identifiant de modèle est claude-haiku-5-5.
Essayez-le sur VEGA
Haiku 5.5 est le modèle par défaut des modes auto, chat, code, web, extreme et memory de VEGA. Il convient aux réponses rapides, aux résumés et aux recherches d’informations, pour lesquels la rapidité compte le plus.
Pour les tâches ouvertes les plus difficiles, Opus 5.5 et Sonnet 5.5 restent les meilleurs choix, comme le précise également Anthropic.
Lisez l’annonce originale d’Anthropic sur anthropic.com/claude-haiku-5-5.