DeepSeek V4.1 Flash : évolution ou révolution ?
DeepSeek a lancé V4.1-Flash le 10 septembre 2026. Il s’agit d’un modèle Mixture-of-Experts multimodal de 552 milliards de paramètres, doté d’une fenêtre de contexte de 1 million de tokens. Selon les propres benchmarks de DeepSeek, il rivalise avec Opus-5.0 ou le dépasse sur plusieurs tâches agentiques. Il est également peu coûteux : l’entrée coûte 0,15 $ par million de tokens en heures creuses, et la sortie, 0,60 $. C’est environ 4 fois moins cher que DeepSeek V4-Pro pour l’entrée et 3 fois moins cher pour la sortie.
Le modèle est disponible dès maintenant sur vega.chat et via l’API api.vega.chat.
Architecture
DeepSeek V4.1-Flash utilise une architecture Causal Encoder-Decoder (CED) : un Transformer de 40 couches réparti entre un encodeur causal de 20 couches et un décodeur de 20 couches. Le cache KV du décodeur est projeté à partir des états cachés finaux de l’encodeur, plutôt qu’à partir des états cachés propres à chaque couche du décodeur. Le modèle n’active ainsi que 8 milliards de paramètres par token pendant le préremplissage et 16 milliards pendant le décodage.
La couche MoE comprend 1 expert partagé et 384 experts routés, dont 6 sont activés par token. Le modèle traite nativement les images et le texte grâce à un encodeur de vision (DeepSeek-ViT, entraîné à partir de zéro avec 2D-RoPE) et à un projecteur MLP à deux couches.
DeepSeek a entraîné le modèle à partir de zéro sur un corpus multimodal de 45T tokens, avec une attention parcimonieuse à une longueur de séquence de 64K, puis un contexte étendu à 1M tokens à 34T tokens. Le pipeline de post-entraînement suit les étapes SFT, RL et distillation on-policy, sans changements algorithmiques. L’essentiel du travail a porté sur le pipeline de données : synthèse automatisée à grande échelle de tâches et d’environnements agentiques, avec une mise à l’échelle progressive des données, des tâches et des rollouts.
Performances : niveau Opus, prix Flash
Selon les propres benchmarks de DeepSeek, V4.1-Flash atteint le niveau d’Opus-5.0 et le dépasse sur plusieurs tâches agentiques. Sur Terminal-Bench 2.1, V4.1-Flash obtient un score de 90.6, supérieur aux 89.1 d’Opus-5.0. Sur DeepSWE v1.1, il obtient 74.2, devant Opus à 74.0. Sur Agent's Last Exam, son score de 31.8 est le meilleur parmi tous les modèles comparés, y compris Opus, GPT-5.6 Sol, K3, GLM-5.3 et V4-Pro. Sur Codeforces, il atteint une note de 3471, là encore la plus élevée de la comparaison. Sur AutomationBench, il obtient un score de 54.8, également le meilleur.
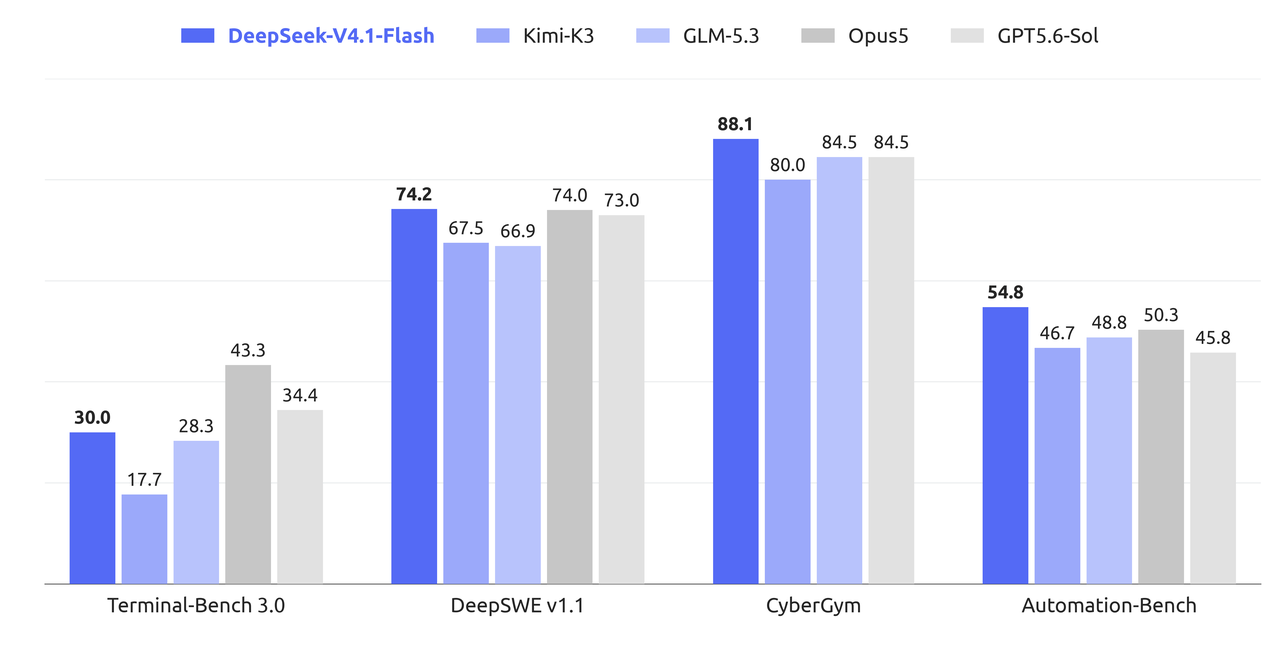
Le tableau complet des benchmarks couvre les tâches de raisonnement, agentiques et visuelles pour sept modèles. V4.1-Flash arrive en tête sur Terminal-Bench 2.1, DeepSWE v1.1, Codeforces, CyberGym, HLE avec outils, AutomationBench et Agent's Last Exam.
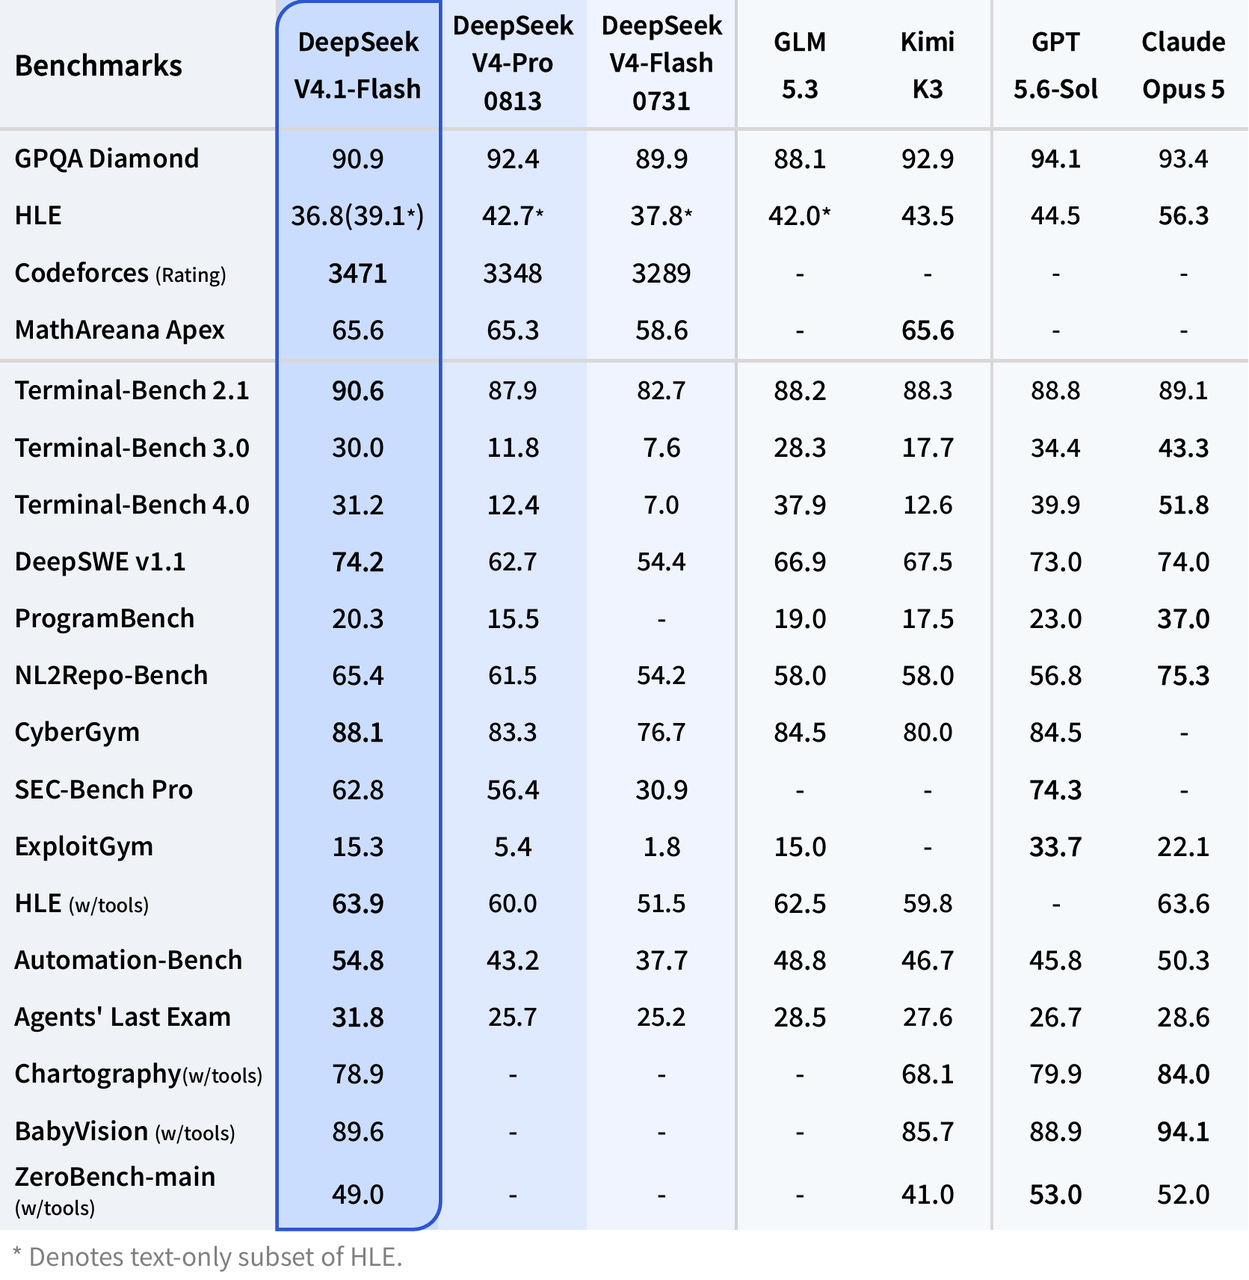
DeepSeek indique que les tests menés par plusieurs parties placent V4.1-Flash devant V4-Pro en matière de performances, de coût, de vitesse et de temps d’exécution total. L’entreprise abandonne progressivement V4-Pro. À partir du 14 septembre 2026, toutes les requêtes API deepseek-v4-pro seront dirigées vers V4.1-Flash, aux tarifs de V4.1-Flash, jusqu’au lancement de V4.1-Pro.
Cache KV : 4 fois plus compact
Le modèle utilise Compressed Sparse Attention 2 (CSA2), qui attribue à chaque couche d’attention l’un de trois modes statiques : Full, Reindex ou Reuse. Cette méthode partage le KV principal et le K de l’indexeur entre les couches, et réutilise les indices d’attention parcimonieuse Top-K. Associée à la mise en cache du KV principal au format FP4 (format E2M1, une échelle E4M3 par tranche de 16 canaux), elle réduit l’empreinte globale du cache KV à 890 octets par token. Cela représente environ 1/4 de celle de DeepSeek V4-Flash et 1/437 de celle de DeepSeek V1.
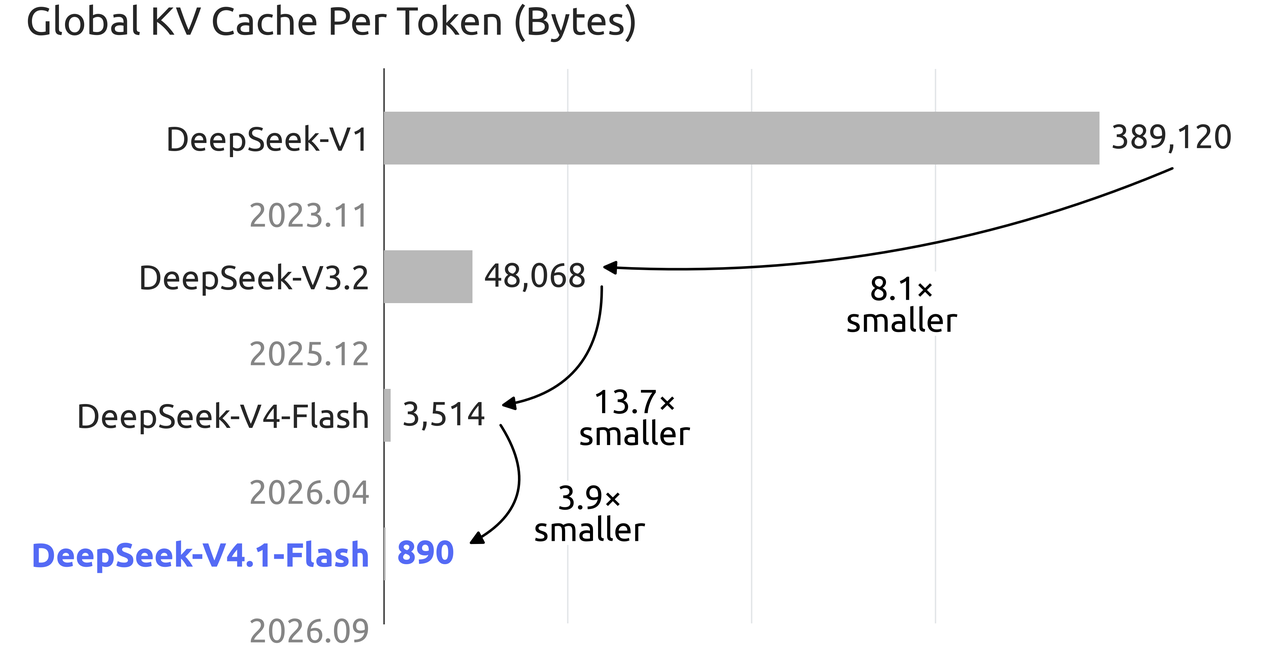
Les frais liés aux accès au cache représentent souvent une grande part des coûts des agents. La compression du cache réduit directement ces coûts. Par rapport à la génération précédente, V4.1-Flash nécessite 1/4 de la mémoire HBM et 1/8 de l’espace de stockage SSD pour son cache KV.
Tarification
V4.1-Flash applique des tarifs de pointe et d’heures creuses. Les tarifs hors pointe correspondent à 50 % des tarifs de pointe. Les nouveaux tarifs sont entrés en vigueur le 10 septembre 2026 à 04:00 UTC.
| Type de token | Heures creuses (par 1M) | Heures de pointe (par 1M) |
|---|---|---|
| Entrée (cache hit) | $0.003 | $0.006 |
| Entrée (cache miss) | $0.15 | $0.30 |
| Sortie | $0.60 | $1.20 |
À titre de comparaison, V4-Pro facture $0.66 par 1M de tokens d’entrée (heures creuses, cache miss) et $1.98 par 1M de tokens de sortie (heures creuses). V4.1-Flash est environ 4 fois moins cher pour l’entrée et 3 fois moins cher pour la sortie, tout en rivalisant avec V4-Pro ou en le dépassant sur les benchmarks.

Tâches quotidiennes, agents et vibe coding
V4.1-Flash est conçu pour les charges de travail agentiques qui nécessitent beaucoup d’entrées. Les 8 milliards de paramètres actifs pendant le préremplissage permettent de traiter de longs contextes à moindre coût, là où les coûts des agents s’accumulent. La fenêtre de contexte de 1M tokens et la prise en charge multimodale native (texte et images) lui permettent de lire de longs documents, des bases de code et des contenus visuels en une seule passe.
Le modèle prend en charge un réglage du niveau d’effort de raisonnement contrôlable en continu (entier de 1 à 100), qui permet de faire varier le coût d’inférence en fonction de la précision. Les niveaux d’effort plus faibles réduisent le nombre de tokens utilisés pour les requêtes simples. Les niveaux plus élevés ajoutent des étapes de raisonnement pour les problèmes complexes. Le modèle se prête ainsi aussi bien aux conversations quotidiennes et aux questions rapides qu’aux boucles agentiques intensives.
Le modèle affiche ses meilleurs résultats sur les benchmarks agentiques : Terminal-Bench 2.1 (90.6), DeepSWE v1.1 (74.2), Agent's Last Exam (31.8) et AutomationBench (54.8). Il prend en charge les appels d’outils, la sortie JSON et l’API Responses. WorkBuddy (y compris CodeBuddy) et OpenCode, partenaires officiels de DeepSeek, prennent désormais entièrement en charge V4.1-Flash.
Pour le vibe coding, la note de 3471 sur Codeforces et le score de 74.2 sur DeepSWE v1.1 placent V4.1-Flash en tête de la comparaison, devant Opus-5.0 et GPT-5.6 Sol. Associé à son prix bas et à son contexte de 1M, cela en fait un excellent modèle par défaut pour les agents de programmation qui exécutent de longues sessions et accumulent de vastes contextes.
Essayez DeepSeek V4.1-Flash sur vega.chat
DeepSeek V4.1-Flash est disponible dès maintenant sur vega.chat et via l’API api.vega.chat. Vous pouvez le tester dans l’interface de chat, comparer ses réponses côte à côte avec celles d’autres modèles ou l’intégrer à vos applications grâce à l’API compatible avec OpenRouter disponible sur api.vega.chat.