GLM-5.3 : du code de pointe et des capacités cyber émergentes
Pour GLM-5.3, nous avons fait une seule chose : intensifier le post-training. Avec GLM-5.2, nous avions construit toute la pile technique : IndexShare pour traiter efficacement les longs contextes, SAO pour l'apprentissage par renforcement sur les tâches à long horizon, et slime pour l'entraînement asynchrone à grande échelle — le tout s'appuyant sur les environnements de tâches à long horizon que nous accumulons depuis longtemps. Ce dernier mois, nous avons continué à monter en charge sur cette même pile : davantage d'environnements, des tâches plus variées, et nettement plus de calcul consacré à l'entraînement.
Aujourd'hui, nous sortons GLM-5.3. Il repose sur le même modèle de base que GLM-5.2 — chaque progrès est issu du post-training. Comparé à GLM-5.2, il se montre bien plus à l'aise sur le code complexe et les tâches à long horizon :
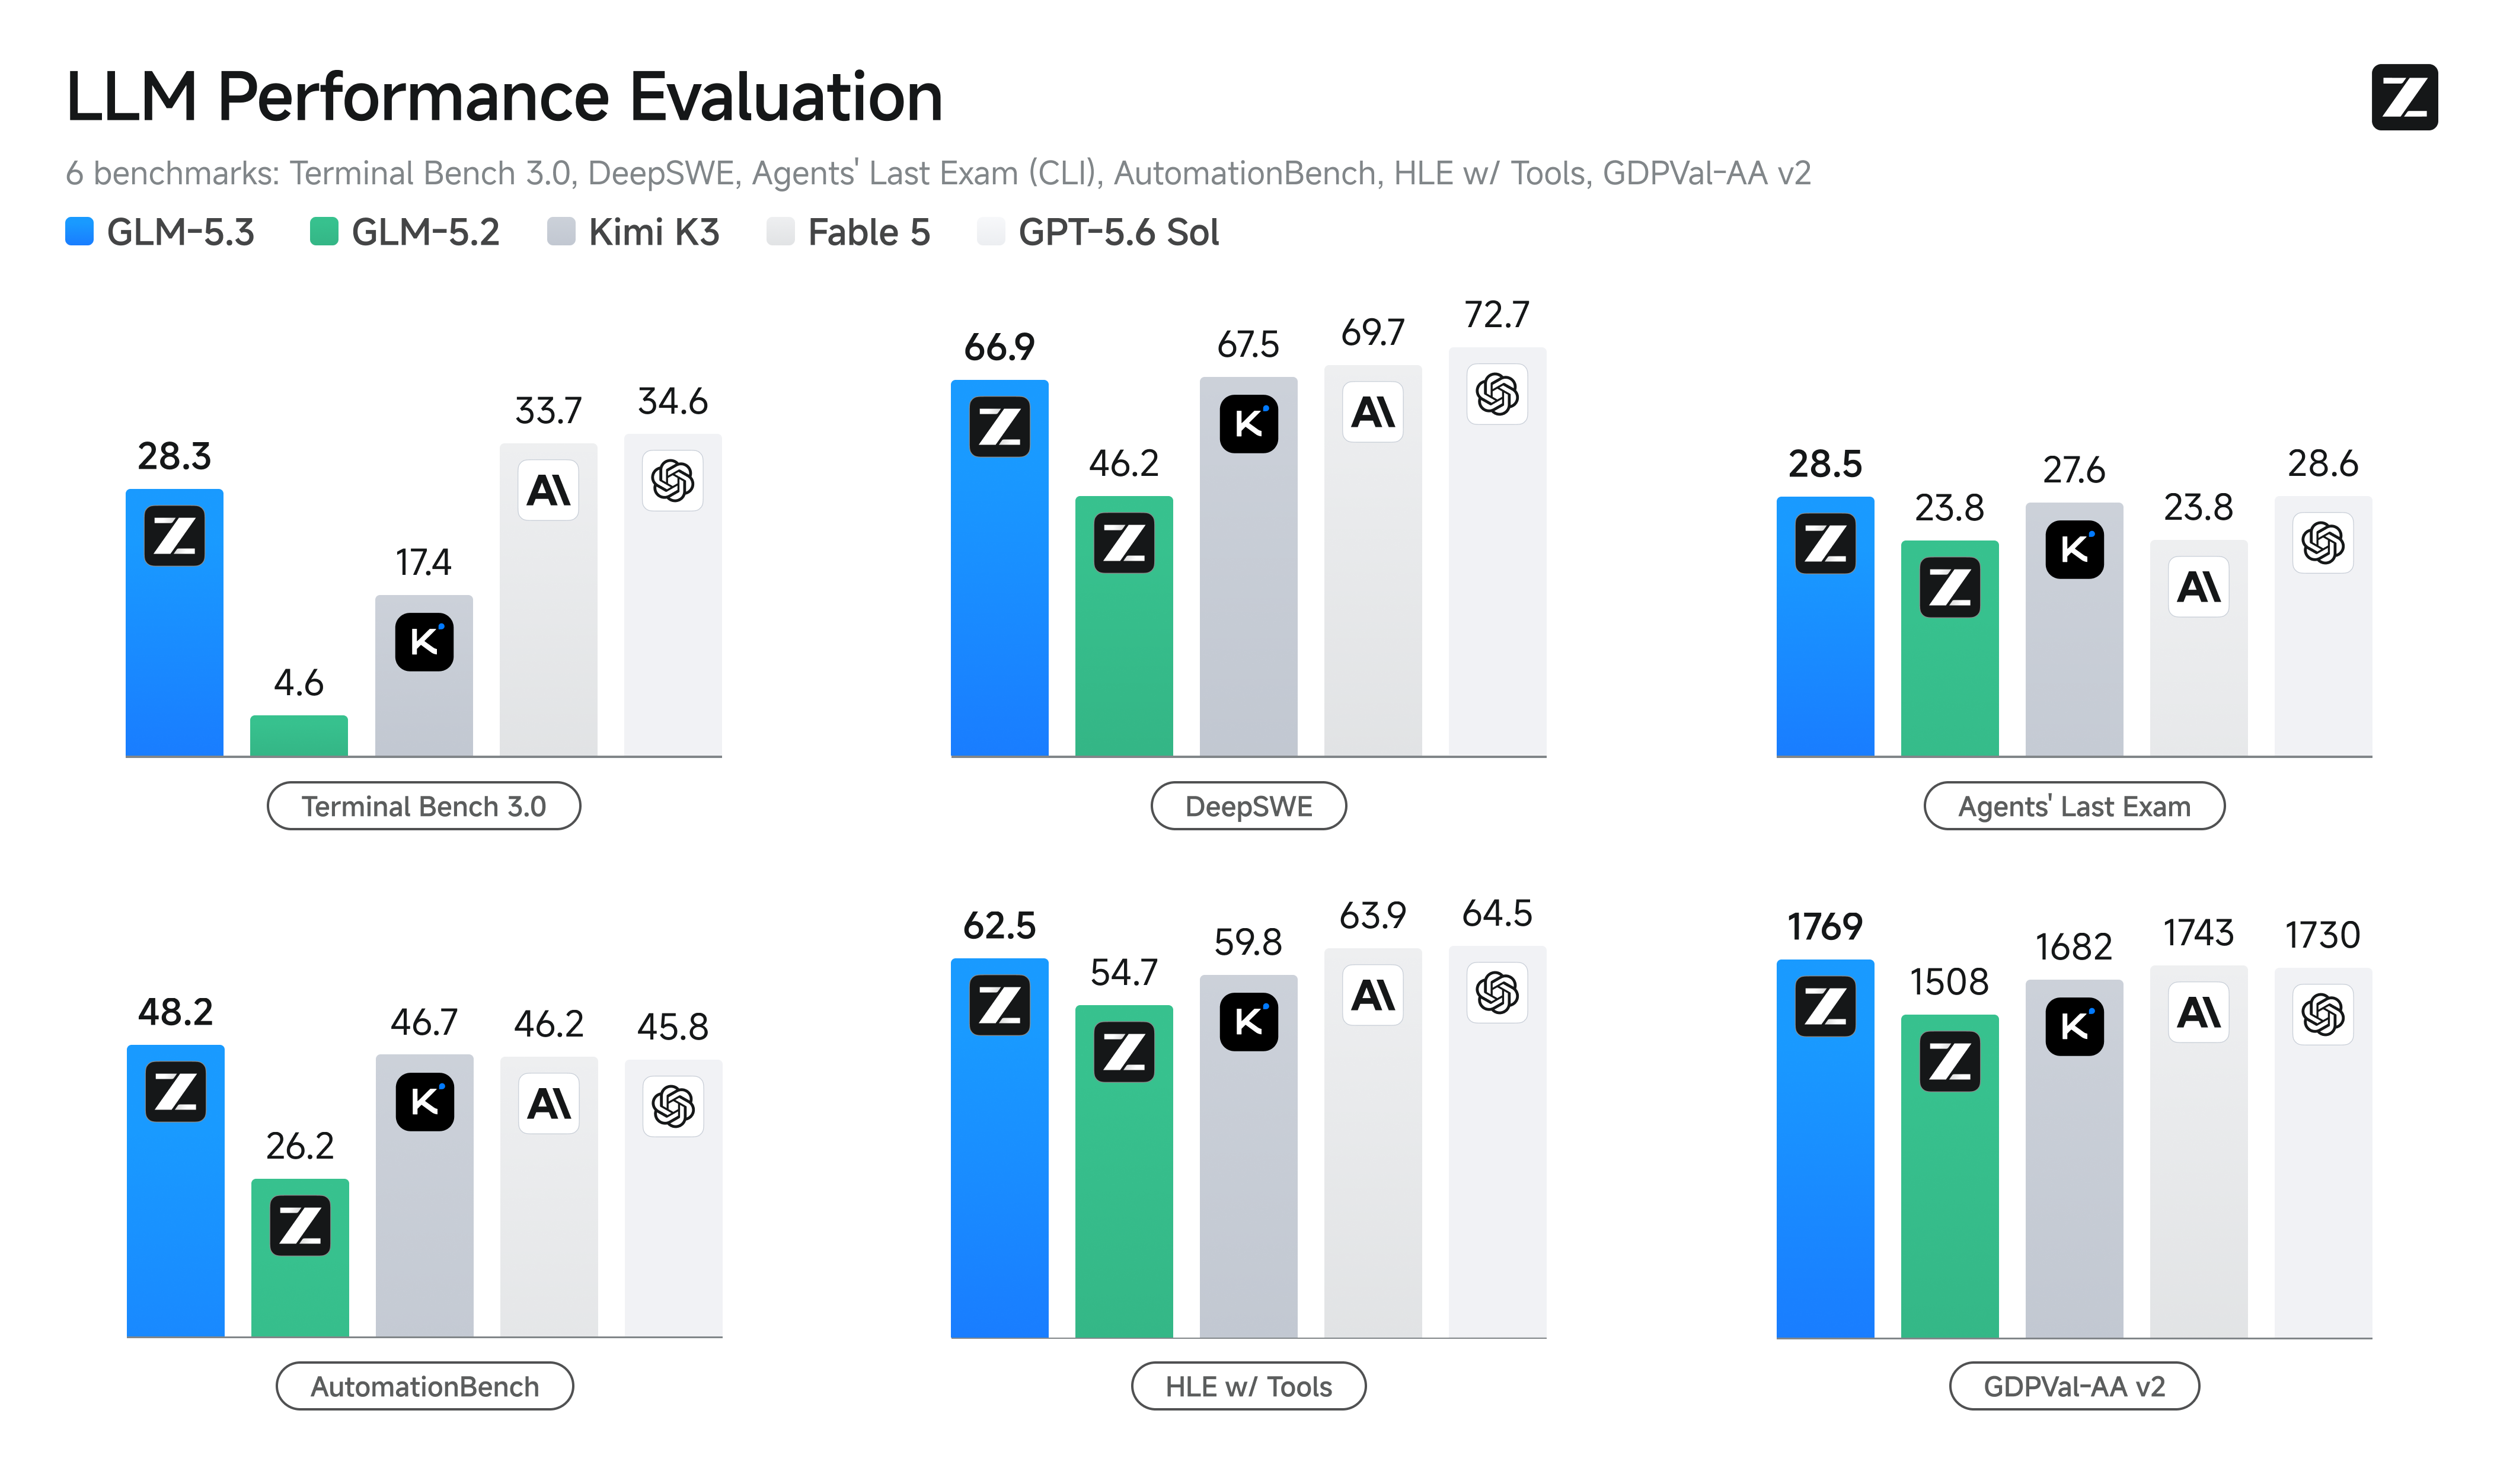
- Code plus robuste : GLM-5.3 est le modèle open weights le plus performant pour le code, avec une amélioration de 50 % par rapport à GLM-5.2 sur notre benchmark interne Z.ai Code Bench. Il établit également la SOTA open source sur des benchmarks publics, notamment Terminal Bench 3.0 et Agents' Last Exam.
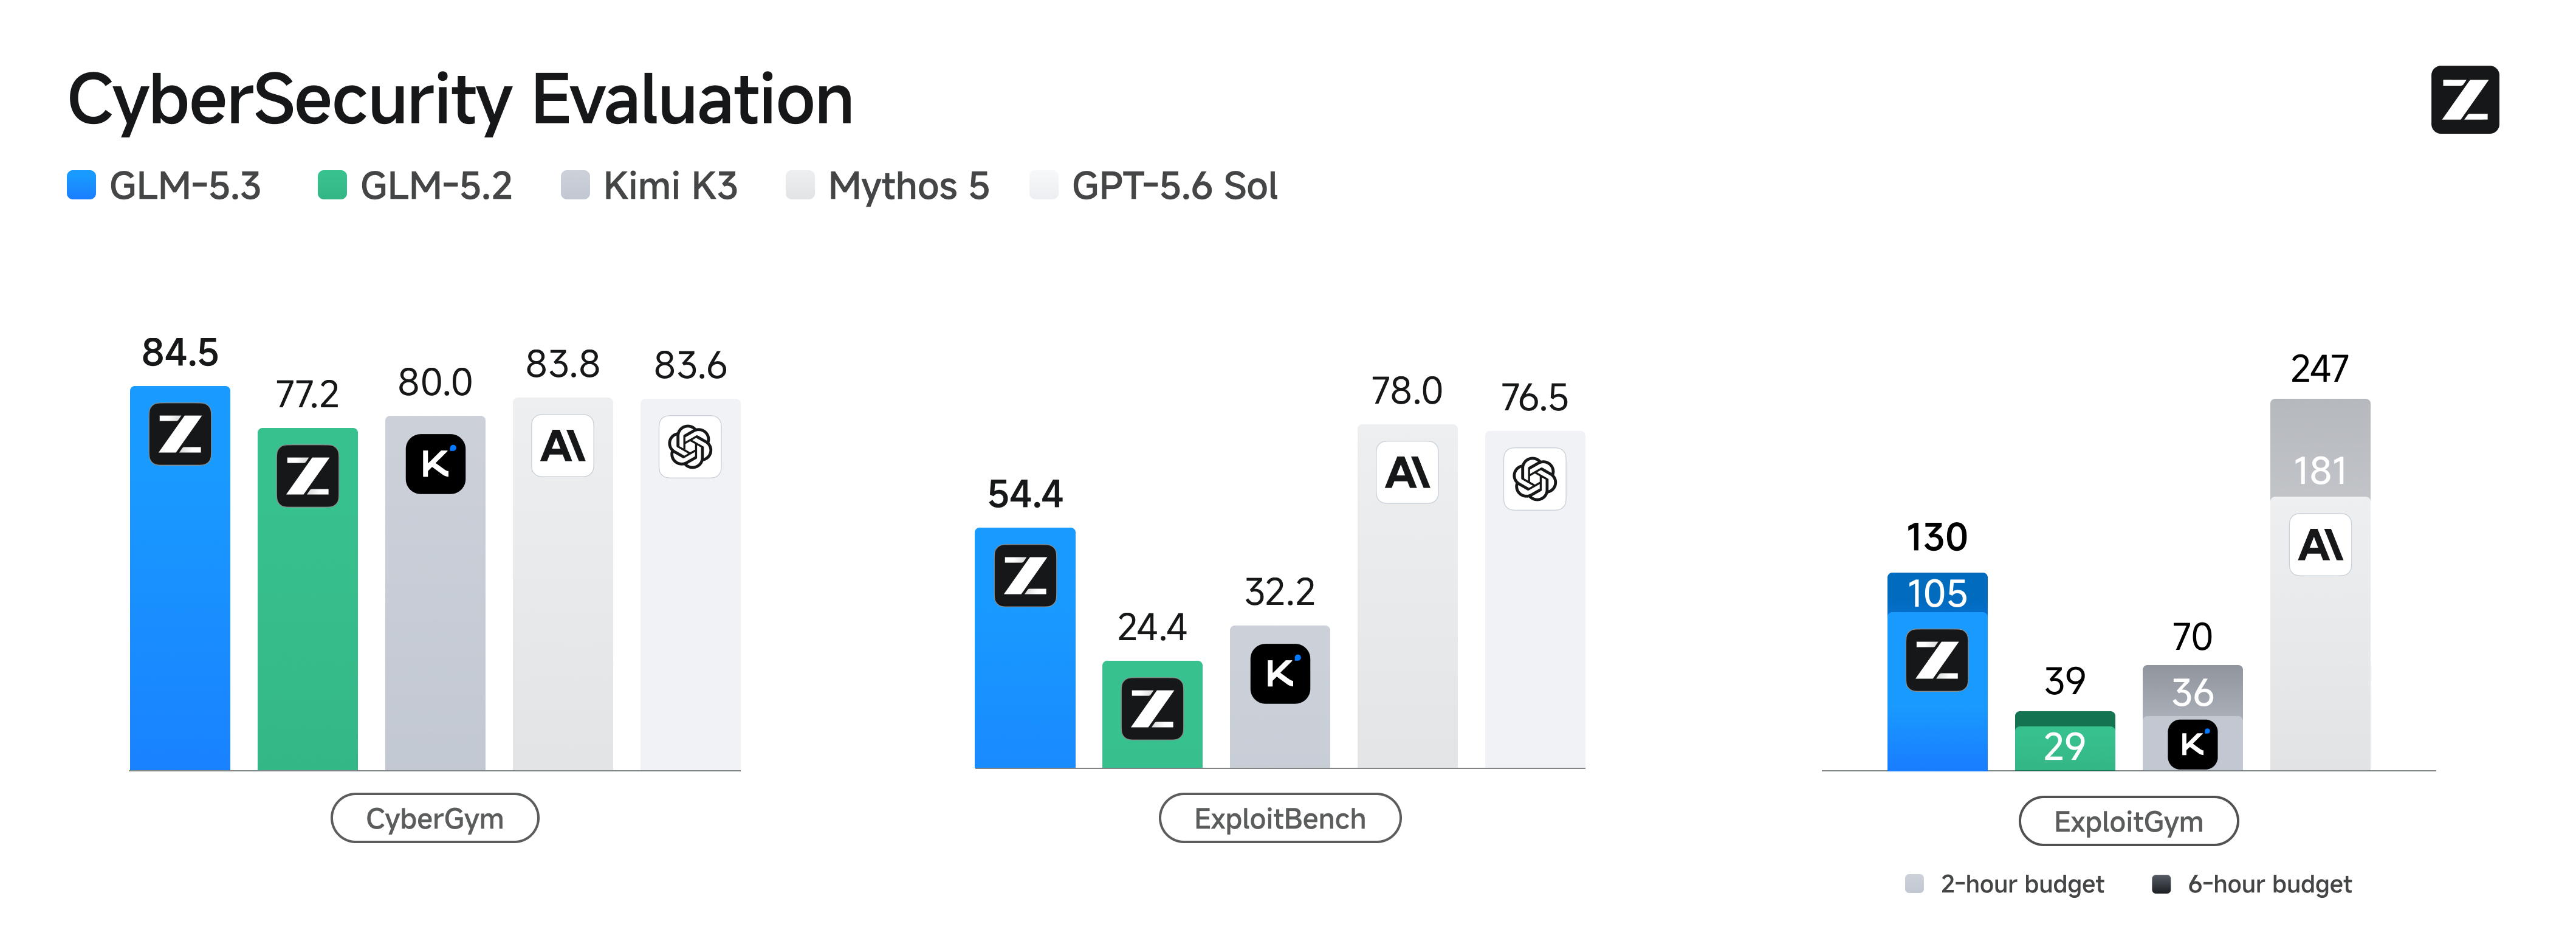
- Capacités cyber émergentes : à mesure que nous montions en charge sur le post-training, les capacités liées à la cybersécurité ont progressé plus vite que prévu. GLM-5.3 est à l'état de l'art sur CyberGym pour la découverte de vulnérabilités, et ses gains sont d'autant plus marqués qu'on remonte la chaîne d'exploitation : il fait plus que doubler GLM-5.2 sur les benchmarks d'exploitation.
- Open source : nous publierons les poids dans deux semaines après le lancement, une fois les évaluations de sécurité et le durcissement terminés.
Capacités cyber émergentes
Dans le cadre du post-training, nous avons intégré des données et des environnements liés à la découverte de vulnérabilités dans le mélange d'entraînement. Nous nous attendions à ce que cela améliore la capacité du modèle à repérer et à raisonner sur les vulnérabilités. Ce qui nous a surpris, c'est l'ampleur avec laquelle la compétence a dépassé cet objectif.
Nous évaluons GLM-5.3 sur trois benchmarks couvrant différentes étapes de l'analyse et de l'exploitation de vulnérabilités. Sur CyberGym, qui part de code source en boîte blanche et vérifie si le modèle parvient à identifier et valider des vulnérabilités en déclenchant des fautes, GLM-5.3 atteint 84,5 %, contre 77,2 % pour GLM-5.2 — le meilleur résultat du benchmark, devant Mythos 5 (83,8 %) et GPT-5.6 Sol (83,6 %). Sur ExploitBench, qui exige un raisonnement plus poussé sur des vulnérabilités réelles et leur exploitation, GLM-5.3 grimpe à 54,4 %, soit plus du double de GLM-5.2 (24,4 %), tandis que Mythos 5 et GPT-5.6 Sol affichent respectivement 78,0 % et 76,5 %. Sur ExploitGym, qui mesure combien de tâches d'exploitation un modèle peut accomplir dans des budgets normalisés dans le temps, GLM-5.3 complète 105 tâches en deux heures et 130 en six heures, contre 29 et 39 pour GLM-5.2. Mythos 5 reste nettement devant avec 181 et 247 tâches. La tendance sur les trois benchmarks est cohérente : plus on remonte la chaîne d'exploitation, plus le gain par rapport à GLM-5.2 est important — et plus l'écart avec la frontière fermée se creuse. La capacité progresse le plus rapidement précisément là où nous sommes le plus en retard.
Nous avons ensuite voulu vérifier si ces capacités se transfèrent au-delà des benchmarks contrôlés. Depuis GLM-5.2, nous collaborons avec plusieurs équipes de sécurité en Chine pour confronter nos modèles à des bases de code réelles. Après examen par des experts, filtrage et déduplication, le modèle a identifié 2 436 vulnérabilités réparties sur 269 projets, dont 1 097 de sévérité moyenne à élevée. Ces découvertes couvrent des noyaux système, des systèmes d'exploitation, des moteurs de navigateur, des infrastructures open source, des applications web et des protocoles réseau. Certaines étaient passées inaperçues depuis des années, voire des décennies, la plus ancienne remontant à environ 40 ans.
Ce travail s'est depuis transformé en un effort de divulgation continu. Nous avons mis en place le Z.ai Security Disclosure Ledger pour tenir un registre public des découvertes au fur et à mesure de leur traitement. Le registre est mis à jour en continu à mesure que de nouvelles vulnérabilités sont examinées et divulguées, en distinguant les problèmes déjà rendus publics de ceux encore en cours de divulgation. Pour les problèmes divulgués, il consigne des informations telles que le projet concerné, la sévérité, le CVE lorsqu'il existe, et la durée pendant laquelle la vulnérabilité est restée présente dans la base de code.
slime : conçu pour la montée en charge du RL à long horizon
Tout cela tourne sur slime, notre framework open source de post-training dédié à la montée en charge du RL, avec Megatron côté entraînement et SGLang côté rollout. Sa conception maintient l'entraînement, le rollout et le tampon de données sur un seul flux de données, de sorte que les maths, le code, les sandboxes, les vérificateurs et les environnements agentic à long horizon s'intègrent comme de la génération de données plutôt que comme des modifications de la boucle d'entraînement. C'est ce qui nous a permis d'ajouter des environnements tout au long de GLM-5.2 et GLM-5.3 sans reconstruire la pile d'entraînement à chaque fois.
Avec GLM-5.3, nous avons continué à le développer sur deux fronts. Côté algorithmique, nous avons ajouté des capacités orientées recherche en RL : masque top-p, OPD top-k et sur vocabulaire complet, ainsi que des configurations qui améliorent la cohérence entraînement–rollout, notamment des configurations de type R3 et un alignement numérique complet entre les chemins d'entraînement et de rollout. Cela nous donne un contrôle plus fin sur l'échantillonnage, l'entraînement et les signaux du teacher, et rend les comparaisons contrôlées beaucoup plus rapides à exécuter. Lors de notre évaluation de cohérence entraînement–rollout, la différence moyenne sur les log-probabilités (logprob) a été maîtrisée au niveau 1e-7, soit une réduction de plus de 99,99 % par rapport aux configurations précédentes.
Nous avons également travaillé sur l'efficacité des ressources et le débit système pour le RL à grande échelle. Le stockage local fait désormais office de couche de cache supplémentaire, retenant les états du modèle et les données de manière hiérarchique plutôt que de les laisser en mémoire hôte. C'est particulièrement important pour l'OPD multi-teacher : avec la commutation dynamique de teachers et le préchargement côté entraînement, plusieurs teachers peuvent être utilisés sans déployer un service d'inférence longue durée dédié à chacun, avec une surcoût limité et une consommation de ressources nettement moindre. Pour les charges agentic et asynchrones, nous avons amélioré la planification conjointe et l'équilibrage de charge entre le routeur et slime, de sorte que les requêtes de rollout aux durées et temps d'achèvement très variables exploitent mieux les ressources d'inférence. Nous avons ajouté des heuristiques sensibles à la charge qui dérivent des configurations orientées débit — ratio de ressources prefill/decode, paramètres de concurrence et autres paramètres critiques pour le débit — à partir des caractéristiques de chaque environnement de rollout. Résultat : pour les tâches de RL sur le code à long horizon, ces optimisations au niveau système ont amélioré le débit d'entraînement RL de bout en bout de plus de 2,3×, ce qui nous permet de monter en charge sur des trajectoires plus longues et des environnements plus complexes avec une efficacité bien supérieure.
Prises ensemble, ces évolutions nous apportent davantage de flexibilité expérimentale, des coûts de ressources réduits et un débit plus élevé — c'est précisément ce qui rend réaliste la poursuite de la montée en charge du RL.
Bien démarrer avec GLM-5.3
Évolutions de l'API dans GLM-5.3
GLM-5.3 prend en charge trois niveaux d'intensité de réflexion : low, high et max. La désactivation de la réflexion n'est plus prise en charge par GLM-5.3.
| Parameter | Values | Default | Description |
|---|---|---|---|
| thinking.type | enabled | enabled | Enables thinking. disabled is no longer supported. |
| reasoning_effort | low, high, max | max | low: light; high: enhanced; max: deep. max is recommended for coding tasks. |
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
Migration requise : si votre application utilise actuellement thinking.type: "disabled", remplacez-le par enabled et définissez reasoning_effort sur low avant de mettre à jour l'identifiant du modèle vers glm-5.3. Dans le cas contraire, la requête échouera.
Utiliser GLM-5.3 avec le GLM Coding Plan et ZCode
Essayez GLM-5.3 dans vos agents de code préférés — ZCode, Claude Code, OpenCode, et d'autres. Consultez la présentation du devpack.
Pour les abonnés au GLM Coding Plan : nous avons déployé GLM-5.3 auprès de tous les utilisateurs du plan. Le nouveau GLM Coding Plan utilise désormais un système de quota basé sur des points. La consommation de points est calculée séparément pour les tokens en entrée, en entrée mise en cache et en sortie. Les appels de modèle effectués en dehors des heures de pointe consomment 50 % des points standard. Les heures de pointe sont 14h00–18h00 (UTC+8), du lundi au vendredi ; toutes les autres heures, week-ends compris, bénéficient du tarif réduit à 50 %. Commencez dès maintenant : z.ai/subscribe
Tirer davantage de GLM-5.3 avec ZCode
- Taux de cache hit de 98 % et plus — le contexte répété est facturé au tarif réduit du cache, soit ~30 % de tokens effectifs supplémentaires
- Bonus de quota temporaire de 1,5× — cumulable avec les économies de cache pour atteindre jusqu'à 180 % de votre quota standard jusqu'au 31 août
- Maîtrise du long horizon — le mode Goal planifie, code, teste et vérifie jusqu'à ce que l'objectif soit atteint
- Remote Control — suivez et pilotez les tâches longue durée depuis votre téléphone via WeChat ou Feishu
Essayez ZCode : zcode.z.ai
Servir GLM-5.3 en local
Les poids du modèle GLM-5.3 seront disponibles publiquement prochainement, dans les deux semaines suivant le lancement.