Qwen 4 Max : un équipier de 2,4 T pour les longs travaux
Qwen 4 Max est le nouveau modèle phare d'Alibaba pour le travail professionnel, la production créative et la recherche. Annoncé par l'équipe Qwen le 16 novembre 2026, Qwen4-Max combine une fenêtre de contexte de 1 M, la vision et le langage natifs, ainsi qu'un flux de travail permettant d'examiner les résultats d'un agent IA pendant qu'il travaille.
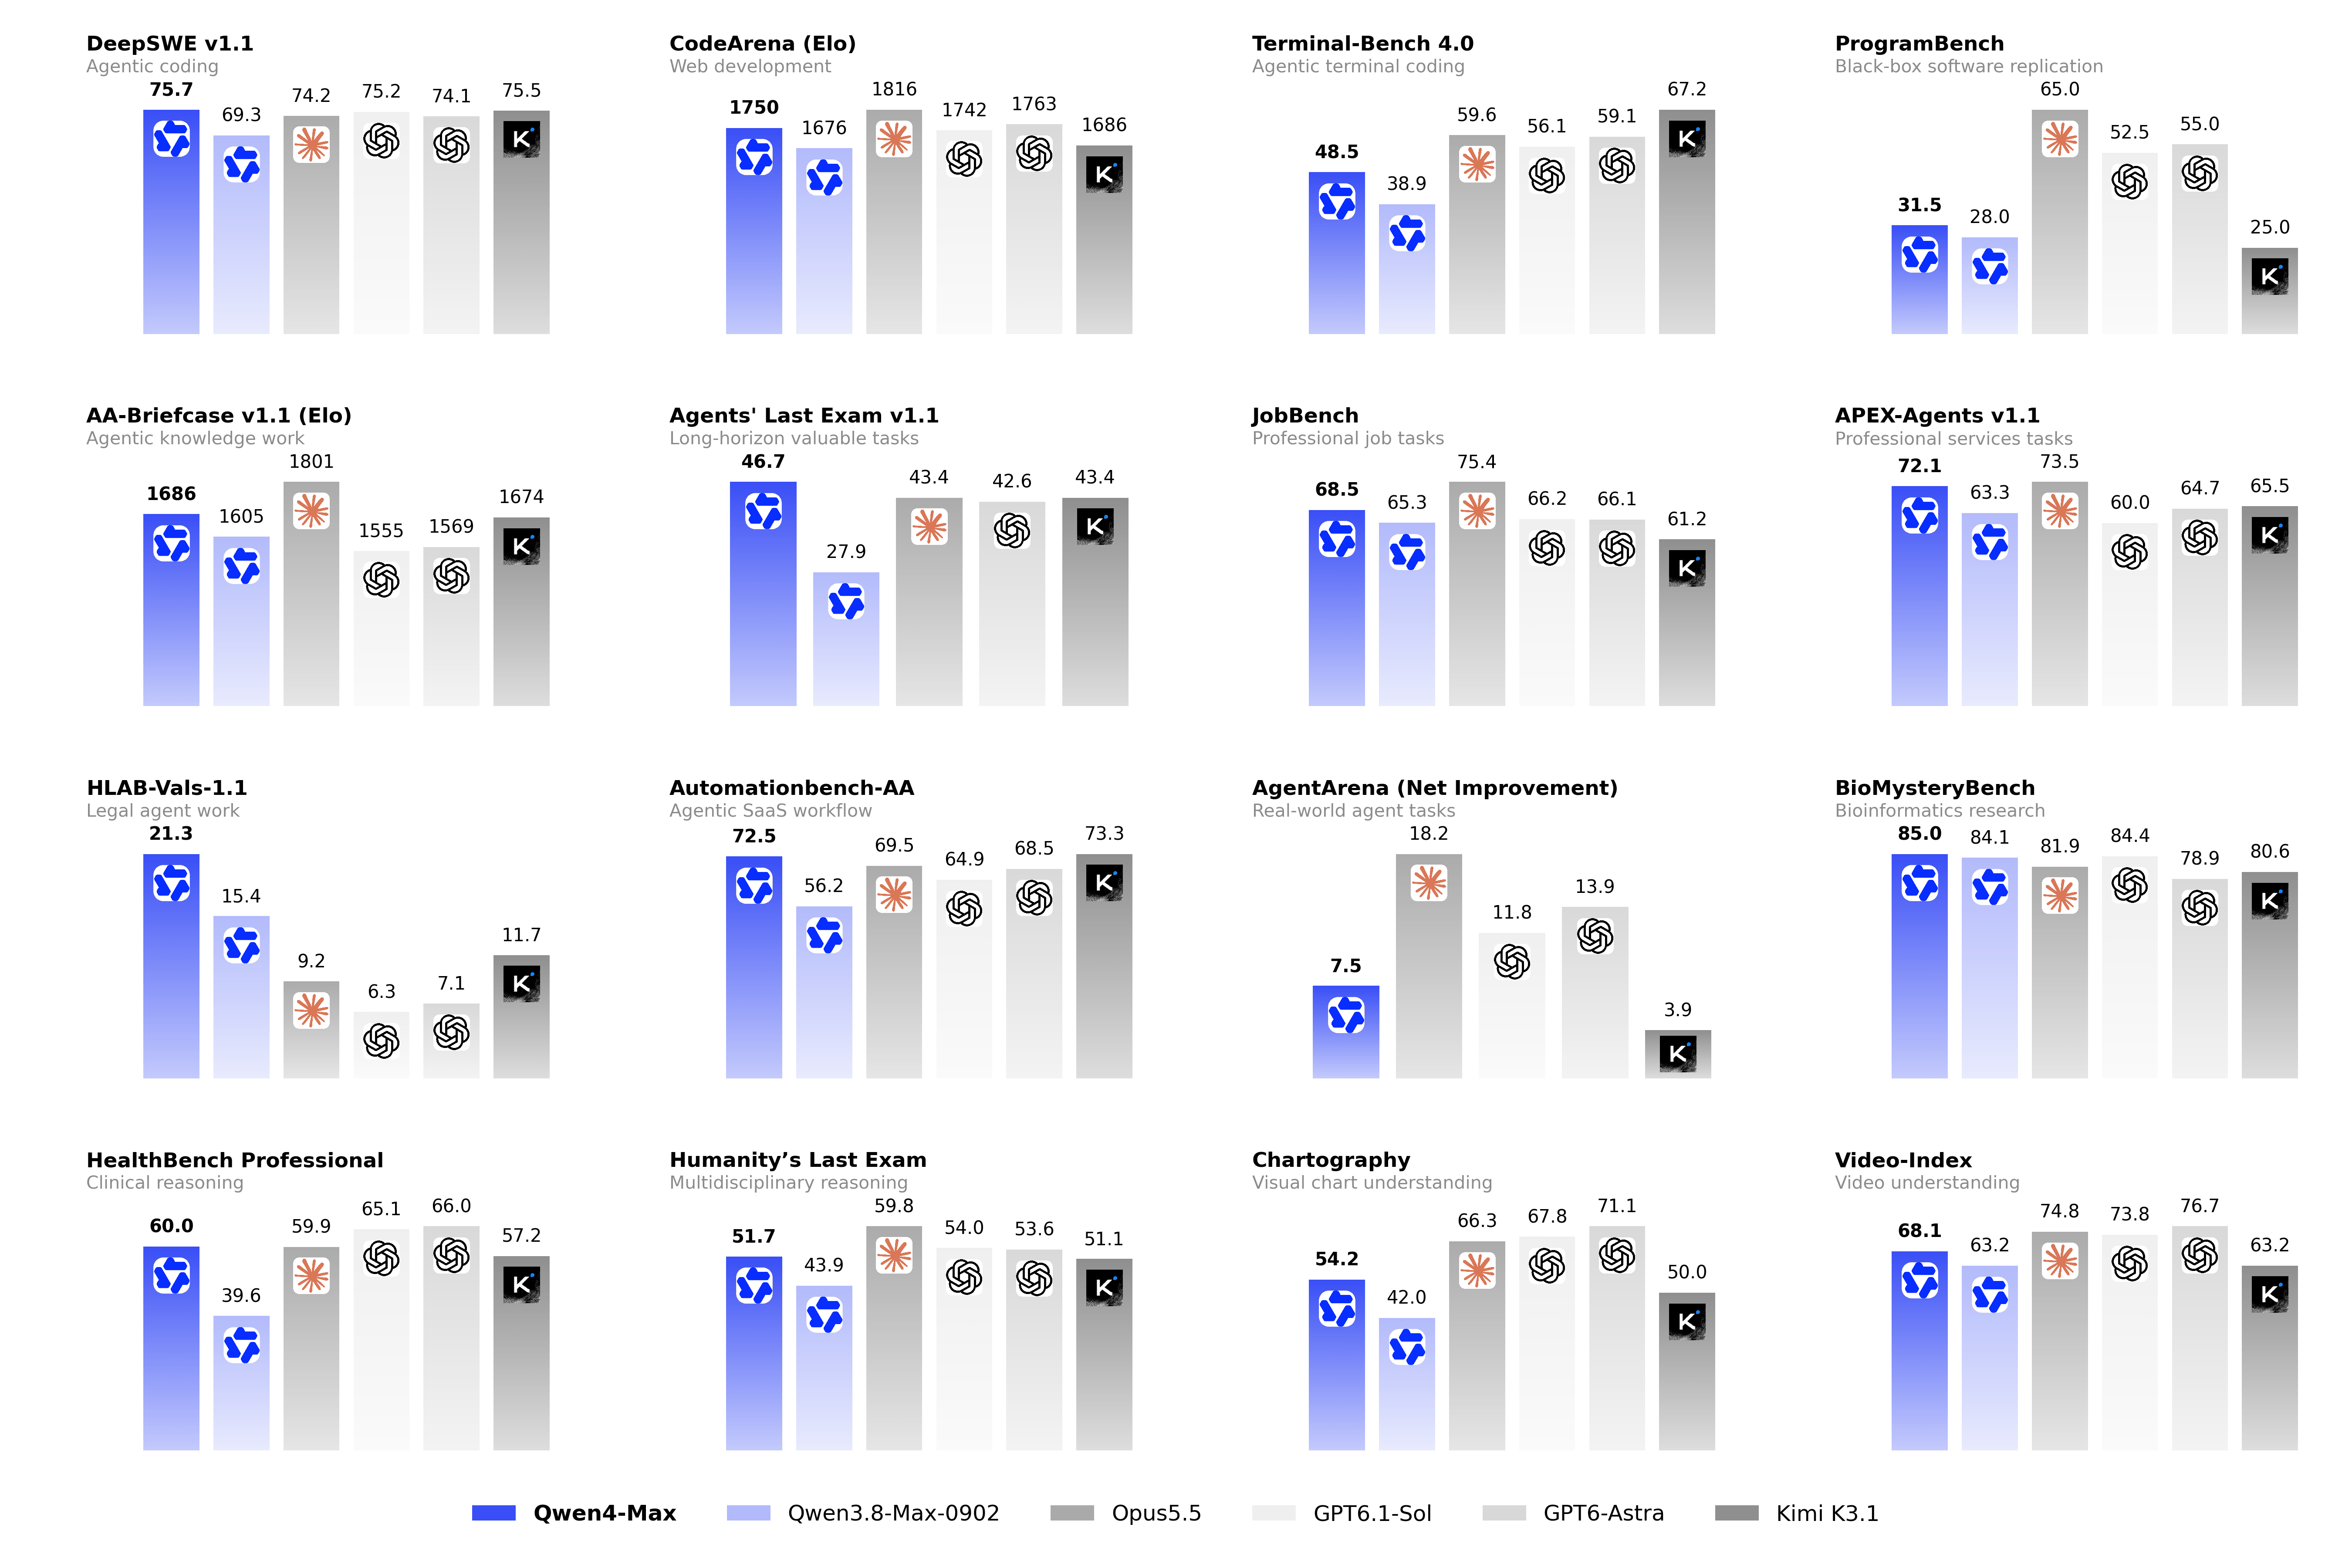
Qwen 4 Max : contexte de 1 M et architecture clairsemée
Qwen4-Max utilise une nouvelle architecture clairsemée à mélange d'experts, avec 2 400 milliards de paramètres au total, dont 71 milliards activés par jeton, auxquels s'ajoutent 328 milliards de paramètres d'embedding N-gram. Elle combine des couches Gated DeltaNet, une attention clairsemée en microblocs et quatre branches Gated Residual parallèles.
La caractéristique phare pour les grands projets est la fenêtre de contexte de 1 000 000 de jetons, qui permet de traiter une base de code entière ou une archive documentaire complète en une seule exécution.
Selon Qwen, le modèle de base obtient environ 5 à 13 % de bits par octet en moins que Qwen3.8-Max-Base dans les évaluations Knowledge, Code, QA et STEM, tout en activant 25 % de paramètres en moins.
Résultats des benchmarks : de meilleurs scores avec moins de jetons
Sur Work360, un benchmark couvrant 26 domaines de niveau 1, 182 sous-domaines et 721 champs spécialisés, Qwen4-Max a obtenu un score de 52,69, contre 47,74 pour Qwen3.8-Max, selon Qwen.
L'équipe indique également une utilisation réduite des jetons : environ 24 % de jetons en moins avec l'effort Xhigh et 35 % en moins avec High sur Work360, ainsi que 48 à 49 % en moins sur Terminal-Bench 4.0.
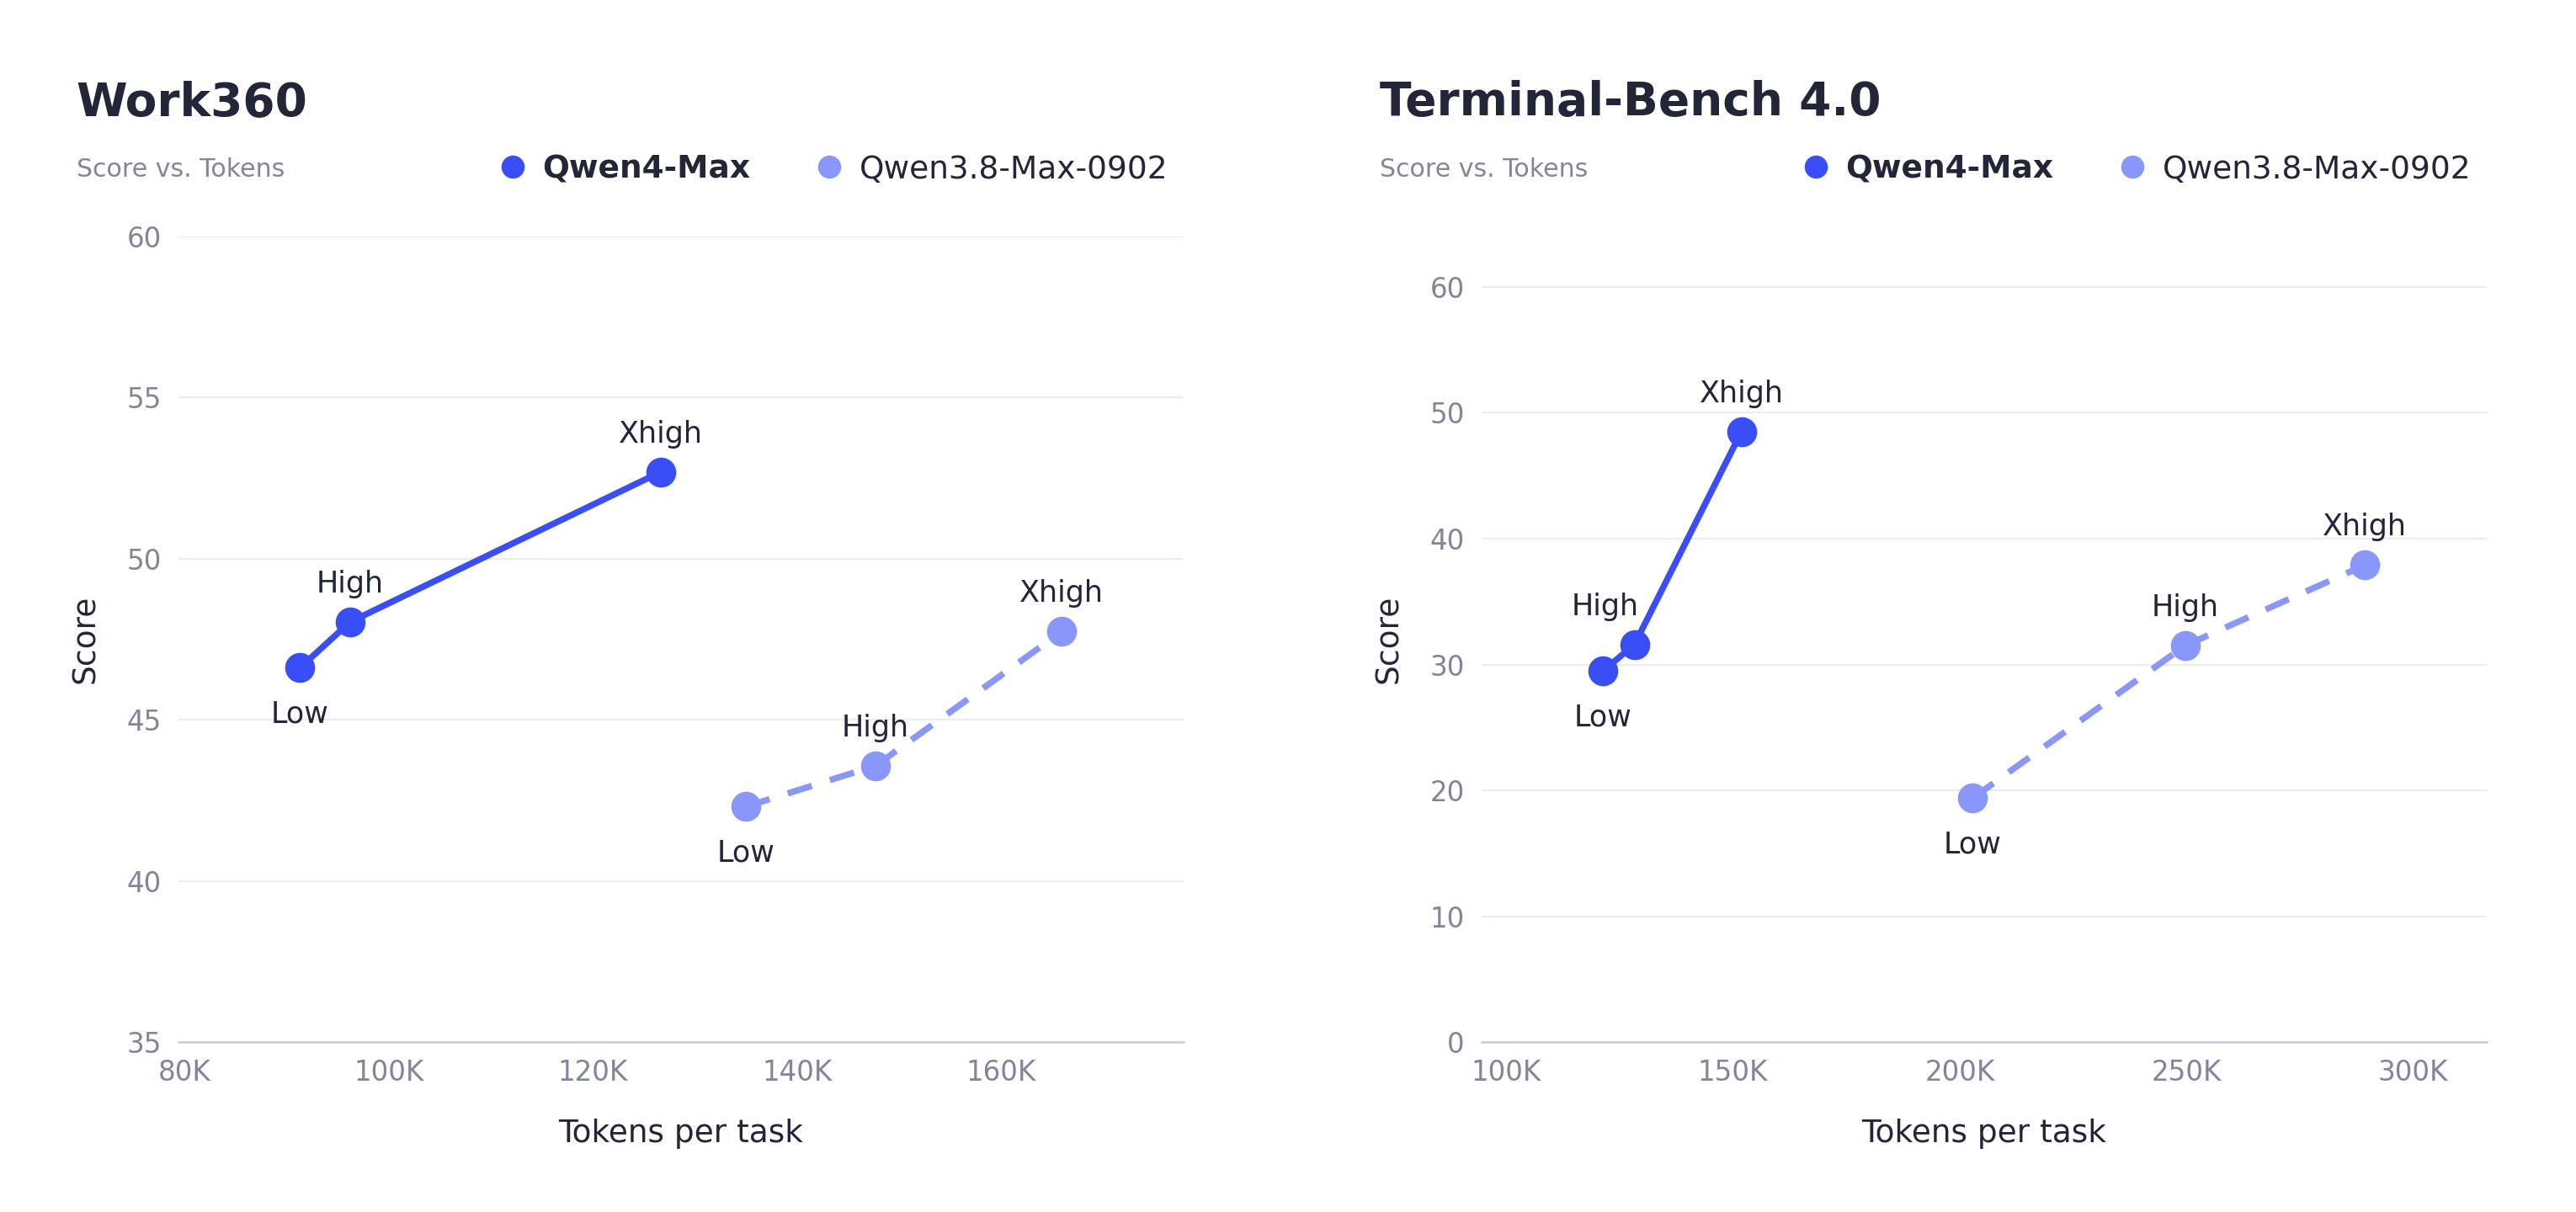
Selon les chiffres communiqués par Qwen, le coût moyen par tâche sur Work360 est passé de 4,43 $ à 1,67 $, soit une baisse de 62 %. L'annonce indique que les tarifs de l'API sont inférieurs à ceux de Qwen3.8-Max, en particulier pour les entrées mises en cache, sans toutefois publier de tarifs exacts. Ces résultats sont communiqués par le fournisseur et ne sont pas garantis pour toutes les charges de travail.
Un agent IA que vous pouvez réorienter en cours de tâche
Le changement le plus concret du flux de travail est Live Delivery : les agents de longue durée transmettent des livrables intermédiaires afin que les utilisateurs puissent suivre l'avancement et réorienter la tâche avant son terme. Qwen a publié un plugin Live Delivery open source.
Les démonstrations vont de jeux jouables créés dans Unity 6, Unreal Engine et Godot à la modélisation dans Blender et à la production vidéo agentique. Voici « Meow of Magic », une aventure mettant en scène un chat mage, créée par le modèle dans Unreal Engine.
Parmi les exemples professionnels figurent des recherches financières s'appuyant sur 90 outils MCP pour produire des classeurs Excel et des présentations PowerPoint, ainsi qu'une vérification préalable juridique transformant 198 documents de travail en un rapport de 86 pages avec citations. Le principe est le même dans tous les cas : une utilisation prolongée d'outils, suivie d'un livrable que vous pouvez examiner.
Où essayer Qwen4-Max
Qwen indique que le modèle est disponible via le Token Plan ou l'API de QwenCloud, ainsi que sur QwenWork, Qoder et QwenStudio. Les poids de Qwen4-Max ne sont pas ouverts ; la publication en open source de modèles Qwen4 plus petits est prévue ultérieurement.
Vous pouvez essayer des modèles de pointe sur vega.chat ou via api.vega.chat ; consultez le sélecteur de modèles pour savoir quand Qwen 4 Max sera disponible.
Pour les tâches médicales, juridiques, financières et autres tâches à fort impact, la réserve formulée par Qwen s'applique : le modèle aide à exercer le jugement professionnel, mais ne le remplace pas.