DeepSeek V4.1 Flash․ էվոլյուցիա՞, թե՞ հեղափոխություն
DeepSeek-ը V4.1-Flash-ը թողարկել է 2026 թվականի սեպտեմբերի 10-ին։ Այն 552B պարամետրով բազմամոդալ Mixture-of-Experts մոդել է՝ 1M թոքենանոց կոնտեքստի պատուհանով։ DeepSeek-ի սեփական բենչմարքների համաձայն՝ այն գործակալային մի շարք առաջադրանքներում համարժեք է Opus-5.0-ին կամ գերազանցում է նրան։ Այն նաև էժան է․ մուտքային թոքենների արժեքը ոչ պիկ ժամերին մեկ միլիոնի համար $0.15 է, իսկ ելքայիններինը՝ $0.60։ Սա մուտքային թոքենների համար մոտ 4 անգամ էժան է DeepSeek V4-Pro-ից, իսկ ելքայինների համար՝ 3 անգամ։
Մոդելն այժմ հասանելի է vega.chat-ում և api.vega.chat API-ի միջոցով։
Ճարտարապետություն
DeepSeek-V4.1-Flash-ն օգտագործում է Causal Encoder-Decoder (CED) ճարտարապետություն․ 40 շերտից բաղկացած Transformer, որը բաժանված է 20-շերտանոց պատճառահետևանքային կոդավորիչի և 20-շերտանոց ապակոդավորիչի։ Ապակոդավորիչի KV քեշը ստացվում է կոդավորիչի վերջնական թաքնված վիճակներից, այլ ոչ թե ապակոդավորիչի յուրաքանչյուր շերտի սեփական թաքնված վիճակներից։ Դրա շնորհիվ մոդելը նախալցման ընթացքում յուրաքանչյուր թոքենի համար ակտիվացնում է ընդամենը 8B պարամետր, իսկ դեկոդավորման ընթացքում՝ 16B։
MoE շերտն ունի 1 ընդհանուր փորձագետ և 384 ուղղորդվող փորձագետ՝ յուրաքանչյուր թոքենի համար ակտիվացնելով 6 ուղղորդվող փորձագետ։ Մոդելը պատկերներն ու տեքստը բնիկ կերպով մշակում է տեսողության կոդավորիչի (DeepSeek-ViT, զրոյից ուսուցանված 2D-RoPE-ով) և երկշերտ MLP պրոյեկտորի միջոցով։
DeepSeek-ը մոդելը զրոյից ուսուցանել է 45T թոքենանոց բազմամոդալ կորպուսի վրա՝ 64K հաջորդականության երկարության դեպքում կիրառելով նոսր ուշադրություն, իսկ կոնտեքստը 34T թոքենի ընթացքում ընդլայնելով մինչև 1M թոքեն։ Հետուսուցման փուլերն են՝ SFT, RL և on-policy դիստիլյացիա՝ առանց ալգորիթմական փոփոխությունների։ Հիմնական աշխատանքը կատարվել է տվյալների մշակման գործընթացում․ գործակալային առաջադրանքների և միջավայրերի լայնածավալ ավտոմատ սինթեզ՝ տվյալների, առաջադրանքների և փորձարկումների աստիճանական ընդլայնմամբ։
Արտադրողականություն․ Opus-ի մակարդակ՝ Flash-ի գներով
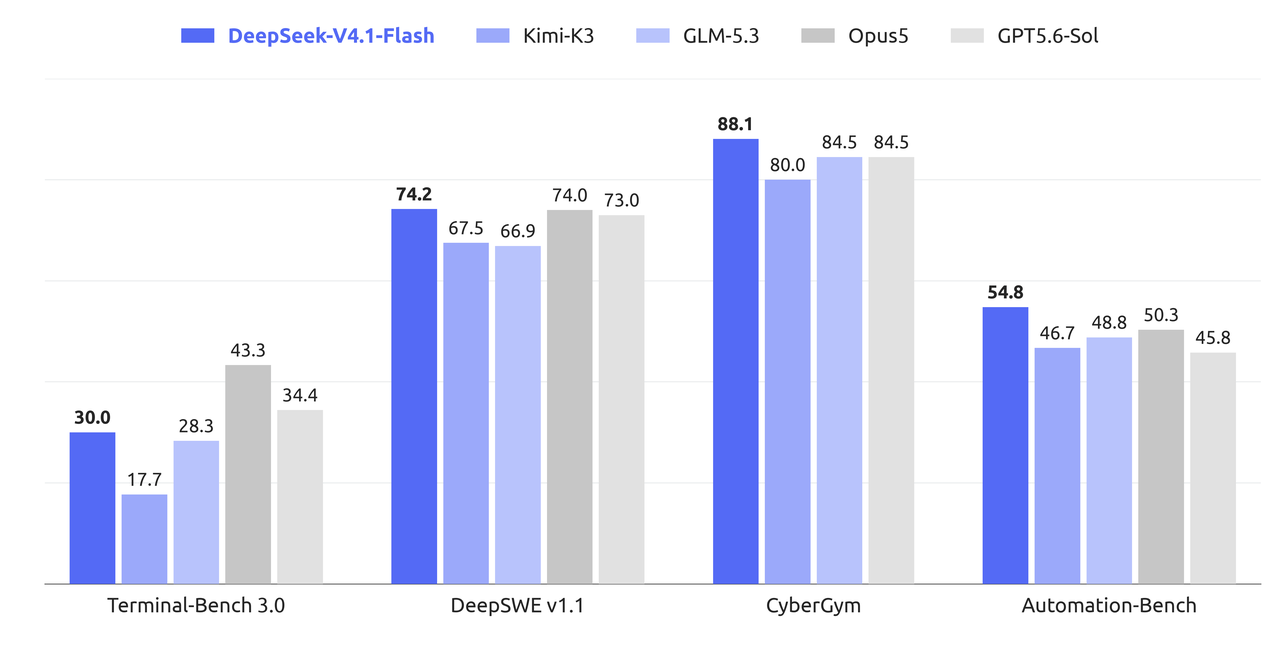
DeepSeek-ի սեփական բենչմարքները V4.1-Flash-ը դասում են Opus-5.0-ի մակարդակին, իսկ մի շարք գործակալային առաջադրանքներում այն առաջ է նրանից։ Terminal-Bench 2.1-ում V4.1-Flash-ը հավաքում է 90.6 միավոր՝ գերազանցելով Opus-5.0-ի 89.1-ը։ DeepSWE v1.1-ում այն հավաքում է 74.2 միավոր՝ առաջ անցնելով Opus-ից, որի արդյունքը 74.0 է։ Agent's Last Exam-ում այն հավաքում է 31.8 միավոր՝ լավագույն արդյունքը բոլոր համեմատվող մոդելների թվում, այդ թվում՝ Opus, GPT-5.6 Sol, K3, GLM-5.3 և V4-Pro։ Codeforces-ում այն հասնում է 3471 վարկանիշի՝ նույնպես ունենալով համեմատության ամենաբարձր արդյունքը։ AutomationBench-ում այն հավաքում է 54.8 միավոր՝ կրկին գրանցելով լավագույն արդյունքը։
Բենչմարքների ամբողջական աղյուսակն ընդգրկում է տրամաբանական, գործակալային և տեսողական առաջադրանքներ՝ յոթ մոդելների համար։ V4.1-Flash-ը լավագույն արդյունքն է գրանցել Terminal-Bench 2.1-ում, DeepSWE v1.1-ում, Codeforces-ում, CyberGym-ում, գործիքներով HLE-ում, AutomationBench-ում և Agent's Last Exam-ում։
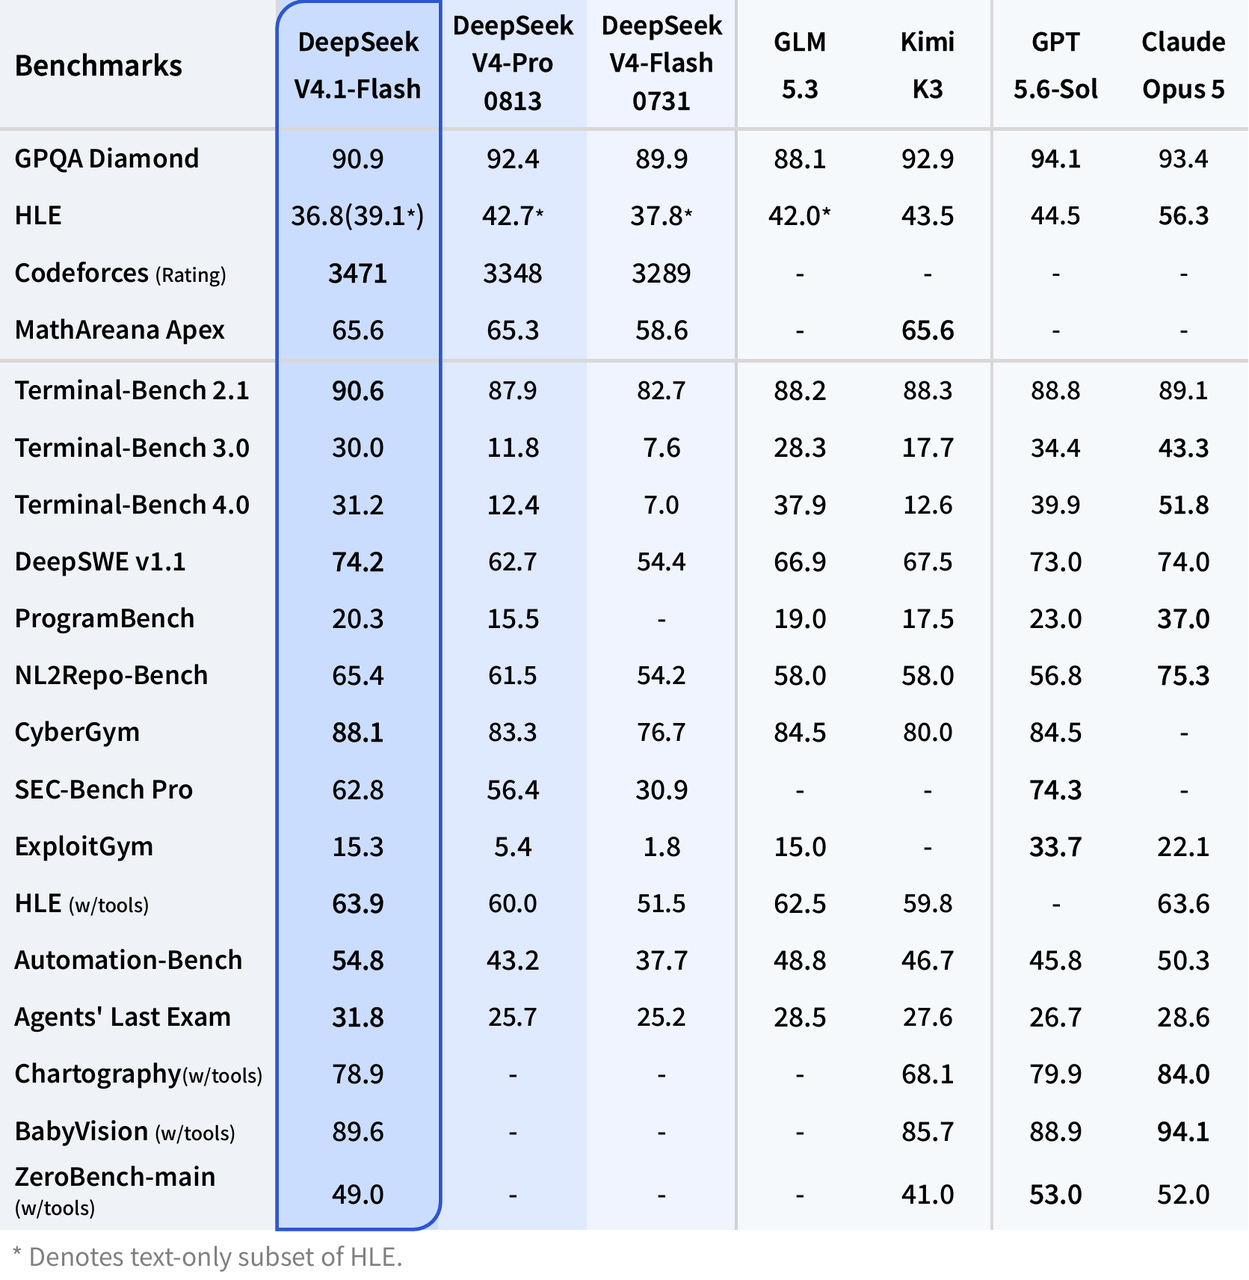
DeepSeek-ը նշում է, որ մի քանի կողմերի անցկացրած թեստերում V4.1-Flash-ը գերազանցում է V4-Pro-ին արտադրողականությամբ, արժեքով, արագությամբ և կատարման ընդհանուր տևողությամբ։ Ընկերությունն աստիճանաբար դադարեցնում է V4-Pro-ի սպասարկումը։ 2026 թվականի սեպտեմբերի 14-ից սկսած՝ deepseek-v4-pro API-ի բոլոր հարցումները կուղղորդվեն դեպի V4.1-Flash՝ V4.1-Flash-ի սակագներով, մինչև V4.1-Pro-ի թողարկումը։
KV քեշ․ 4 անգամ փոքր
Մոդելն օգտագործում է Compressed Sparse Attention 2 (CSA2), որը յուրաքանչյուր ուշադրության շերտին վերագրում է երեք ստատիկ ռեժիմներից մեկը՝ Full, Reindex կամ Reuse։ Սա տարբեր շերտերում կիսում է հիմնական KV-ն և ինդեքսավորիչի K-ն, ինչպես նաև կրկնակի օգտագործում Top-K նոսր ուշադրության ինդեքսները։ FP4 հիմնական KV քեշավորման հետ համատեղ (E2M1 ձևաչափ՝ յուրաքանչյուր 16 ալիքի համար մեկ E4M3 սանդղակ)՝ ընդհանուր KV քեշի ծավալը նվազում է մինչև 890 բայթ մեկ թոքենի համար։ Դա DeepSeek V4-Flash-ի ծավալի մոտ 1/4-ն է և DeepSeek V1-ի ծավալի 1/437-ը։
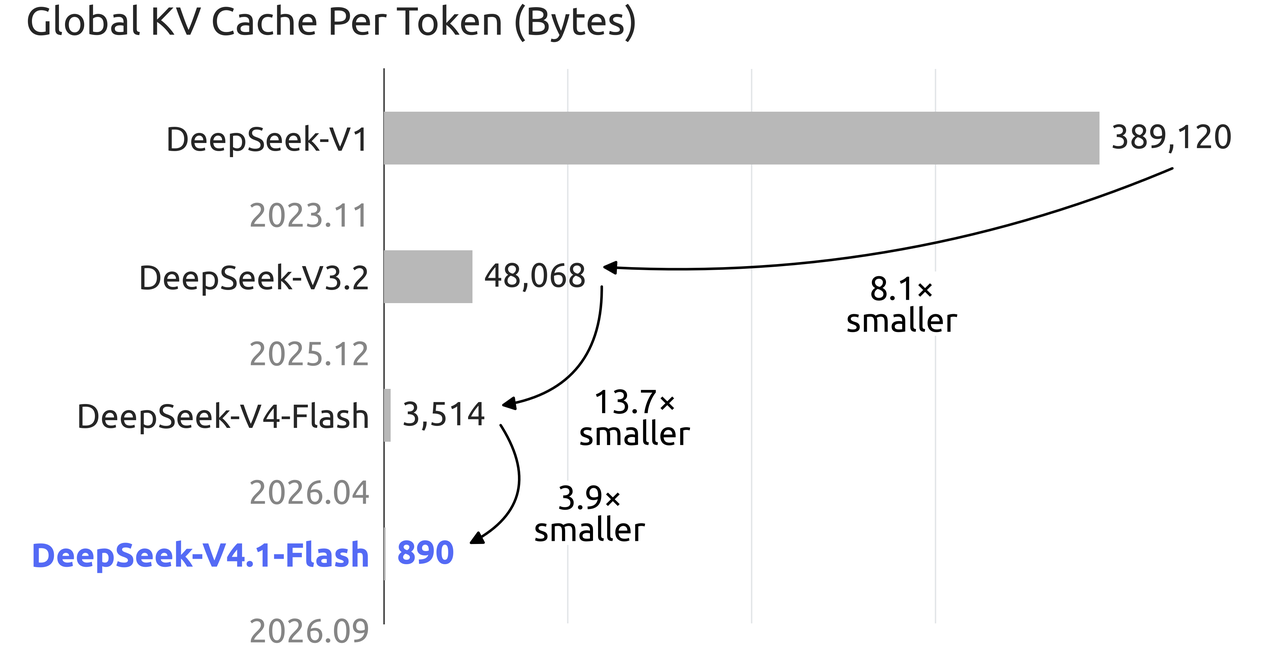
Քեշի հարվածի վճարները հաճախ կազմում են գործակալների ծախսերի զգալի մասը։ Քեշի սեղմումն անմիջապես կրճատում է այդ ծախսերը։ Նախորդ սերնդի համեմատ՝ V4.1-Flash-ին իր KV քեշի համար անհրաժեշտ է HBM-ի 1/4-ը և SSD պահեստի 1/8-ը։
Գներ
V4.1-Flash-ն ունի պիկ և ոչ պիկ ժամերի սակագներ։ Ոչ պիկ ժամերի գները պիկ ժամերի գների 50%-ն են։ Գների նոր ցանկն ուժի մեջ է մտել 2026 թվականի սեպտեմբերի 10-ին՝ UTC ժամանակով 04:00-ին։
| Թոքենի տեսակ | Ոչ պիկ ժամերին (1M-ի համար) | Պիկ ժամերին (1M-ի համար) |
|---|---|---|
| Մուտքային (քեշի հարված) | $0.003 | $0.006 |
| Մուտքային (քեշի բացթողում) | $0.15 | $0.30 |
| Ելքային | $0.60 | $1.20 |
Համեմատության համար՝ V4-Pro-ի սակագինը մուտքային թոքենների մեկ միլիոնի համար $0.66 է (ոչ պիկ ժամերին, քեշի բացթողման դեպքում), իսկ ելքային թոքենների մեկ միլիոնի համար՝ $1.98 (ոչ պիկ ժամերին)։ V4.1-Flash-ը մուտքային թոքենների համար մոտ 4 անգամ էժան է, իսկ ելքայինների համար՝ 3 անգամ՝ միաժամանակ բենչմարքներում համարժեք կամ ավելի լավ արդյունքներ գրանցելով, քան V4-Pro-ը։

Առօրյա առաջադրանքներ, գործակալներ և վայբ-քոդավորում
V4.1-Flash-ը ստեղծված է մուտքային տվյալներով ծանրաբեռնված գործակալային աշխատանքների համար։ Նախալցման ընթացքում ակտիվ 8B պարամետրերը երկար կոնտեքստների մշակումն էժան են դարձնում․ հենց այդտեղ են կուտակվում գործակալների ծախսերը։ 1M թոքենանոց կոնտեքստի պատուհանը և բնիկ բազմամոդալ աջակցությունը (տեքստ և պատկերներ) թույլ են տալիս մեկ անցումով կարդալ ծավալուն փաստաթղթեր, կոդի բազաներ և տեսողական տվյալներ։
Մոդելն աջակցում է տրամաբանական աշխատանքի ինտենսիվության շարունակաբար կարգավորվող պարամետրի (1-ից 100 ամբողջ թիվ), որը թույլ է տալիս ճշտության դիմաց փոխել եզրակացման արժեքը։ Ավելի ցածր մակարդակները նվազեցնում են թոքենների ծախսը պարզ հարցումների դեպքում։ Ավելի բարձր մակարդակները բարդ խնդիրների համար ավելացնում են տրամաբանական քայլեր։ Դրա շնորհիվ մոդելը հարմար է առօրյա զրույցների և արագ հարցերի համար, ոչ միայն երկարատև գործակալային ցիկլերի։
Գործակալային բենչմարքներում մոդելը գրանցում է իր լավագույն արդյունքները՝ Terminal-Bench 2.1 (90.6), DeepSWE v1.1 (74.2), Agent's Last Exam (31.8) և AutomationBench (54.8)։ Այն աջակցում է գործիքների կանչերին, JSON ելքին և Responses API-ին։ DeepSeek-ի պաշտոնական գործընկերներ WorkBuddy-ն (ներառյալ CodeBuddy-ն) և OpenCode-ն այժմ լիովին աջակցում են V4.1-Flash-ին։
Վայբ-քոդավորման համար Codeforces-ի 3471 վարկանիշը և DeepSWE v1.1-ի 74.2 միավորը V4.1-Flash-ին համեմատության առաջին տեղն են բերում՝ Opus-5.0-ից և GPT-5.6 Sol-ից առաջ։ Մատչելի գնի և 1M կոնտեքստի հետ մեկտեղ՝ սա այն դարձնում է կոդավորման գործակալների հուսալի լռելյայն մոդել, հատկապես երկարատև աշխատանքային սեանսների և մեծ կոնտեքստային պատուհանների համար։
Փորձեք DeepSeek V4.1-Flash-ը vega.chat-ում
DeepSeek V4.1-Flash-ն այժմ հասանելի է vega.chat-ում և api.vega.chat API-ի միջոցով։ Կարող եք փորձարկել այն զրույցի միջերեսում, դրա պատասխանները կողք կողքի համեմատել այլ մոդելների պատասխանների հետ կամ ինտեգրել ձեր հավելվածներին՝ api.vega.chat-ի միջոցով հասանելի OpenRouter-ի հետ համատեղելի API-ով։