DeepSeek V4.1 Flash: 진화인가 혁명인가?
DeepSeek는 2026년 9월 10일 V4.1-Flash를 출시했습니다. 이 모델은 552B 파라미터의 멀티모달 Mixture-of-Experts 모델로, 1M 토큰 컨텍스트 윈도우를 지원합니다. DeepSeek 자체 벤치마크에 따르면 여러 에이전트 작업에서 Opus-5.0과 대등하거나 더 뛰어난 성능을 보입니다. 가격도 저렴합니다. 비혼잡 시간대 기준 입력 비용은 토큰 100만 개당 $0.15, 출력 비용은 $0.60입니다. 이는 입력 기준 DeepSeek V4-Pro보다 약 4배, 출력 기준 약 3배 저렴합니다.
이 모델은 지금 vega.chat 및 api.vega.chat API를 통해 이용할 수 있습니다.
아키텍처
DeepSeek-V4.1-Flash는 Causal Encoder-Decoder(CED) 아키텍처를 사용합니다. 40개 레이어의 Transformer를 20개 레이어의 인과적 인코더와 20개 레이어의 디코더로 나눴습니다. 디코더의 KV 캐시는 각 디코더 레이어 자체의 은닉 상태가 아니라 최종 인코더 은닉 상태를 투영해 생성합니다. 덕분에 프리필 과정에서는 토큰당 8B 파라미터만, 디코딩 과정에서는 16B 파라미터만 활성화합니다.
MoE 레이어에는 공유 전문가 1개와 라우팅 전문가 384개가 있으며, 토큰마다 라우팅 전문가 6개를 활성화합니다. 이 모델은 비전 인코더(DeepSeek-ViT, 2D-RoPE를 사용해 처음부터 학습)와 2층 MLP 프로젝터를 통해 이미지와 텍스트를 네이티브로 처리합니다.
DeepSeek는 45T 토큰 규모의 멀티모달 말뭉치로 모델을 처음부터 학습했으며, 시퀀스 길이 64K에서 희소 어텐션을 사용하고 34T 토큰 시점에 컨텍스트를 1M 토큰까지 확장했습니다. 사후 학습 파이프라인은 SFT, RL, 온폴리시 증류 순으로 진행되며 알고리즘 변경은 없었습니다. 실질적인 작업은 데이터 파이프라인에 집중됐습니다. 에이전트 작업과 환경을 대규모로 자동 합성하고, 데이터와 작업, 롤아웃을 점진적으로 확장했습니다.
성능: Flash 가격으로 Opus 수준
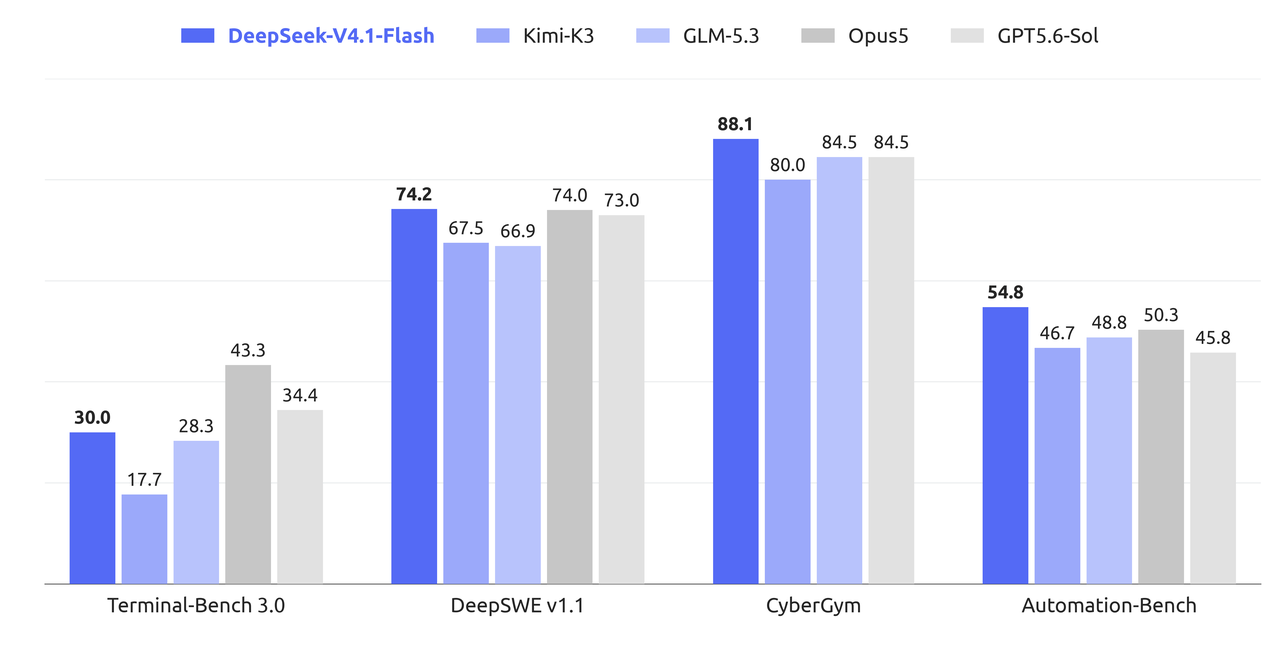
DeepSeek 자체 벤치마크에서 V4.1-Flash는 Opus-5.0 수준의 성능을 보이며 여러 에이전트 작업에서는 이를 앞섭니다. Terminal-Bench 2.1에서 V4.1-Flash는 90.6점을 기록해 Opus-5.0의 89.1점을 넘어섰습니다. DeepSWE v1.1에서는 74.2점으로 Opus의 74.0점보다 높았습니다. Agent's Last Exam에서는 31.8점을 기록해 Opus, GPT-5.6 Sol, K3, GLM-5.3, V4-Pro를 포함한 비교 모델 가운데 가장 높은 점수를 받았습니다. Codeforces 평점은 3471로, 비교 대상 중 역시 가장 높았습니다. AutomationBench에서는 54.8점으로 다시 최고 기록을 세웠습니다.
전체 벤치마크 표는 7개 모델을 대상으로 추론, 에이전트, 시각 작업을 비교합니다. V4.1-Flash는 Terminal-Bench 2.1, DeepSWE v1.1, Codeforces, CyberGym, 도구 사용 HLE, AutomationBench, Agent's Last Exam에서 1위를 차지했습니다.
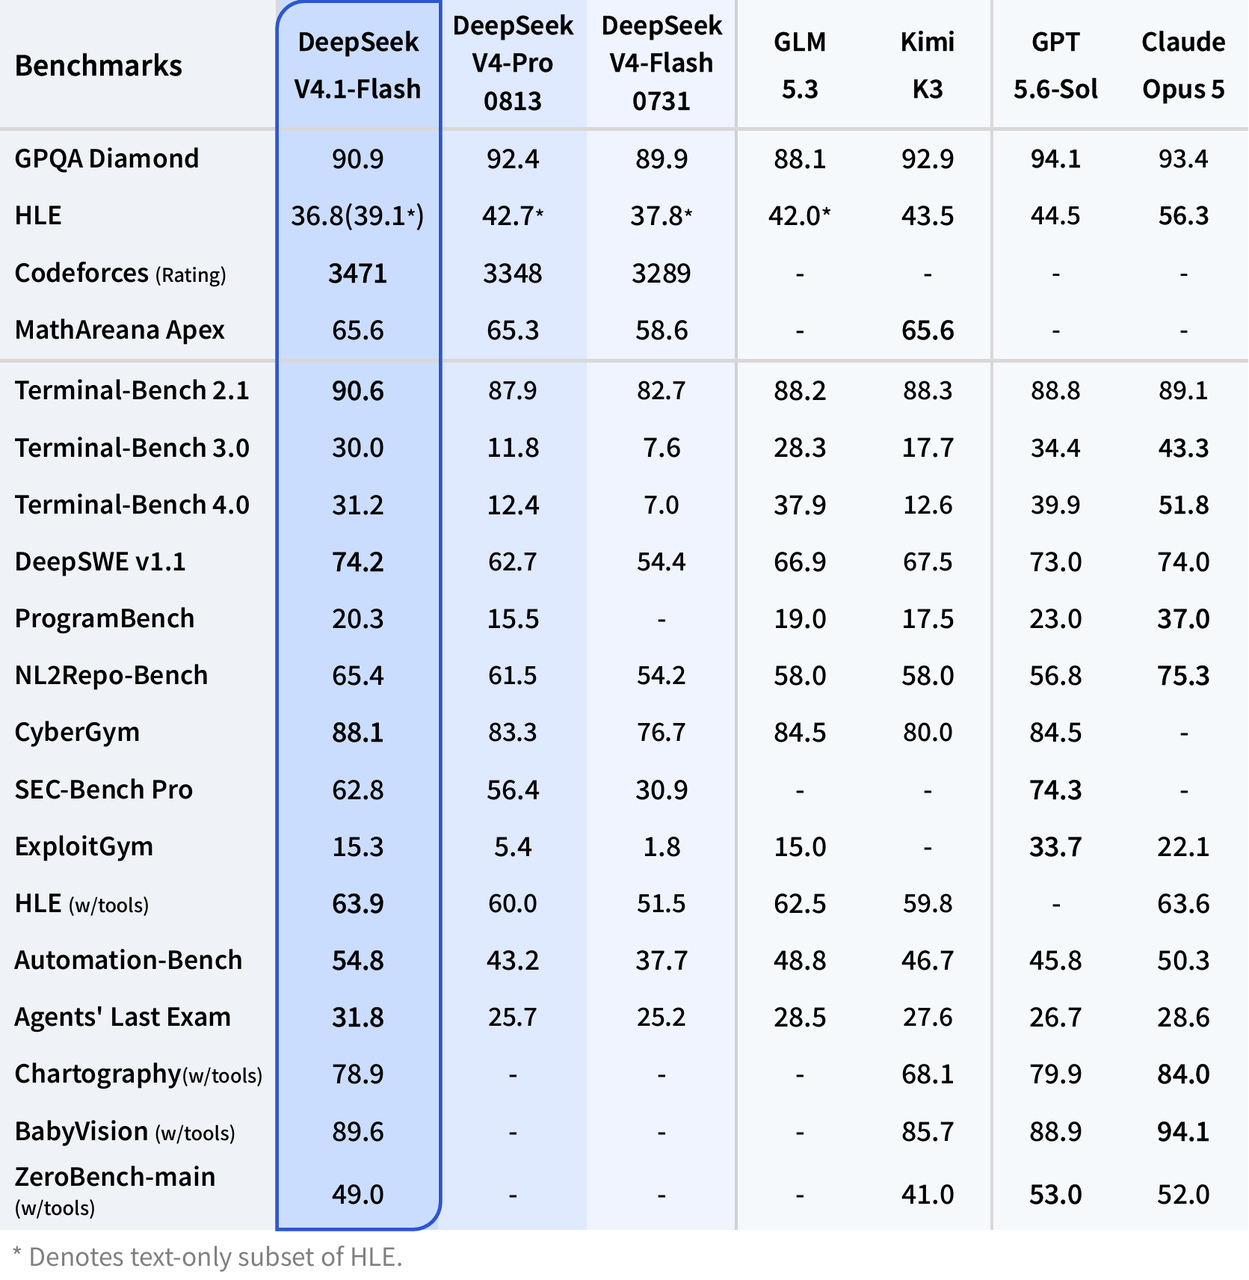
DeepSeek는 여러 기관의 테스트에서 성능, 비용, 속도, 전체 실행 시간 면에서 V4.1-Flash가 V4-Pro를 앞섰다고 밝혔습니다. 회사는 V4-Pro를 단계적으로 종료하고 있습니다. 2026년 9월 14일부터 모든 deepseek-v4-pro API 요청은 V4.1-Flash 요금으로 V4.1-Flash에 연결되며, V4.1-Pro 출시 전까지 이렇게 운영됩니다.
KV 캐시: 4배 더 작게
이 모델은 Compressed Sparse Attention 2(CSA2)를 사용합니다. 각 어텐션 레이어에 Full, Reindex, Reuse 중 하나의 정적 모드를 지정합니다. 이를 통해 레이어 간 메인 KV와 인덱서 K를 공유하고 Top-K 희소 어텐션 인덱스를 재사용합니다. 여기에 FP4 메인 KV 캐시(E2M1 형식, 채널 16개당 E4M3 스케일 1개)를 결합해 전체 KV 캐시 용량을 토큰당 890바이트로 줄였습니다. 이는 DeepSeek V4-Flash의 약 4분의 1, DeepSeek V1의 437분의 1에 해당합니다.
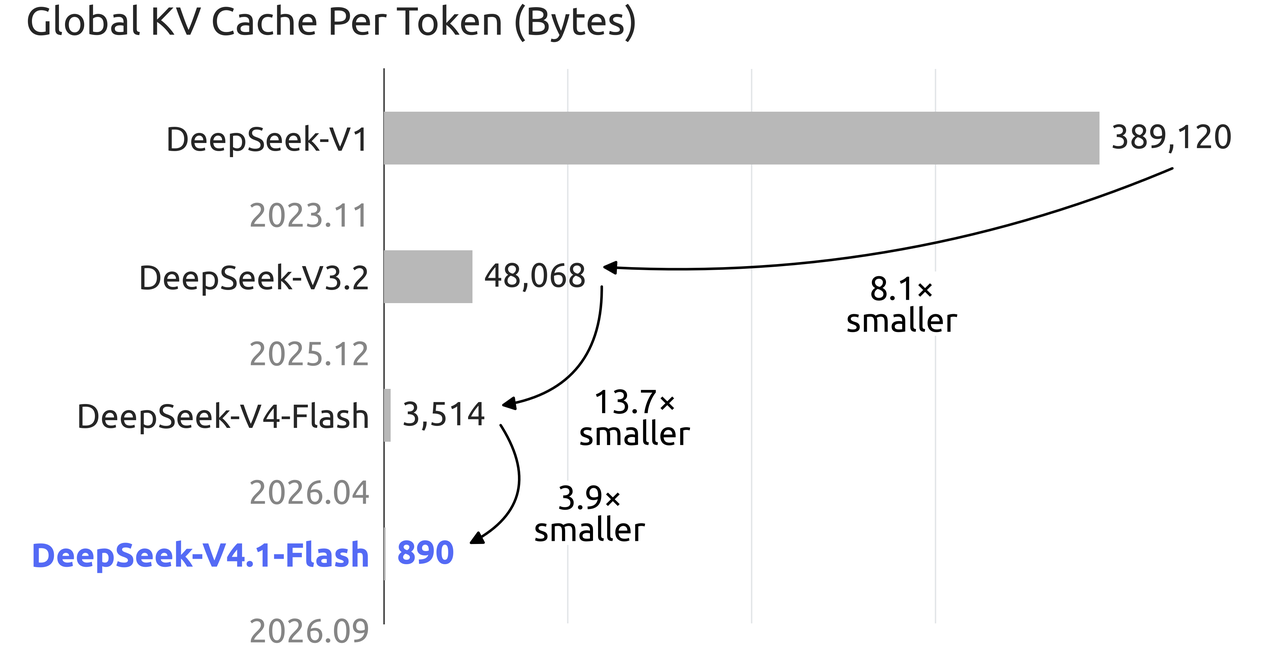
캐시 적중 요금은 에이전트 비용에서 큰 비중을 차지하는 경우가 많습니다. 캐시를 압축하면 비용을 직접 줄일 수 있습니다. 이전 세대와 비교했을 때 V4.1-Flash는 KV 캐시에 필요한 HBM을 4분의 1, SSD 저장 공간을 8분의 1만 사용합니다.
가격
V4.1-Flash는 피크 및 비혼잡 시간대 요금을 적용합니다. 비혼잡 시간대 요금은 피크 시간대 요금의 50%입니다. 새 요금은 2026년 9월 10일 04:00 UTC부터 적용됐습니다.
| 토큰 유형 | 비혼잡 시간대 (100만 개당) | 피크 시간대 (100만 개당) |
|---|---|---|
| 입력 (캐시 적중) | $0.003 | $0.006 |
| 입력 (캐시 미스) | $0.15 | $0.30 |
| 출력 | $0.60 | $1.20 |
비교를 위해 V4-Pro는 입력 토큰 100만 개당 $0.66(비혼잡 시간대, 캐시 미스), 출력 토큰 100만 개당 $1.98(비혼잡 시간대)를 부과합니다. V4.1-Flash는 벤치마크에서 V4-Pro와 대등하거나 더 뛰어난 성능을 보이면서 입력은 약 4배, 출력은 약 3배 저렴합니다.

일상 작업, 에이전트, 바이브 코딩
V4.1-Flash는 입력 비중이 높은 에이전트 워크로드를 위해 설계됐습니다. 프리필 과정에서 활성화되는 파라미터가 8B이므로 긴 컨텍스트를 저렴하게 처리할 수 있습니다. 에이전트 비용이 누적되는 지점이 바로 여기입니다. 1M 토큰 컨텍스트 윈도우와 네이티브 멀티모달 지원(텍스트 및 이미지)을 통해 대용량 문서, 코드베이스, 시각 입력을 한 번에 읽을 수 있습니다.
이 모델은 추론 강도를 연속적으로 조절하는 설정(정수 1~100)을 지원해 추론 비용과 정확도를 조정할 수 있습니다. 낮은 강도에서는 간단한 질의의 토큰 오버헤드를 줄이고, 높은 강도에서는 복잡한 문제에 필요한 추론 단계를 추가합니다. 따라서 고강도 에이전트 루프뿐 아니라 일상적인 채팅과 빠른 질문에도 실용적입니다.
에이전트 벤치마크에서 이 모델은 최고의 점수를 기록했습니다. Terminal-Bench 2.1(90.6), DeepSWE v1.1(74.2), Agent's Last Exam(31.8), AutomationBench(54.8)입니다. 도구 호출, JSON 출력, Responses API를 지원합니다. DeepSeek의 공식 파트너인 WorkBuddy(CodeBuddy 포함)와 OpenCode는 이제 V4.1-Flash를 완전히 지원합니다.
바이브 코딩에서는 Codeforces 평점 3471과 DeepSWE v1.1 점수 74.2를 기록한 V4.1-Flash가 Opus-5.0과 GPT-5.6 Sol을 제치고 비교 대상 중 가장 높은 자리에 올랐습니다. 저렴한 가격과 1M 컨텍스트까지 결합해, 긴 세션을 실행하며 대규모 컨텍스트 윈도우를 누적하는 코딩 에이전트의 강력한 기본 모델이 될 수 있습니다.
vega.chat에서 DeepSeek V4.1-Flash 사용해 보기
DeepSeek V4.1-Flash는 지금 vega.chat 및 api.vega.chat API를 통해 이용할 수 있습니다. 채팅 인터페이스에서 테스트하거나, 다른 모델의 응답과 나란히 비교하거나, api.vega.chat의 OpenRouter 호환 API를 통해 애플리케이션에 통합할 수 있습니다.